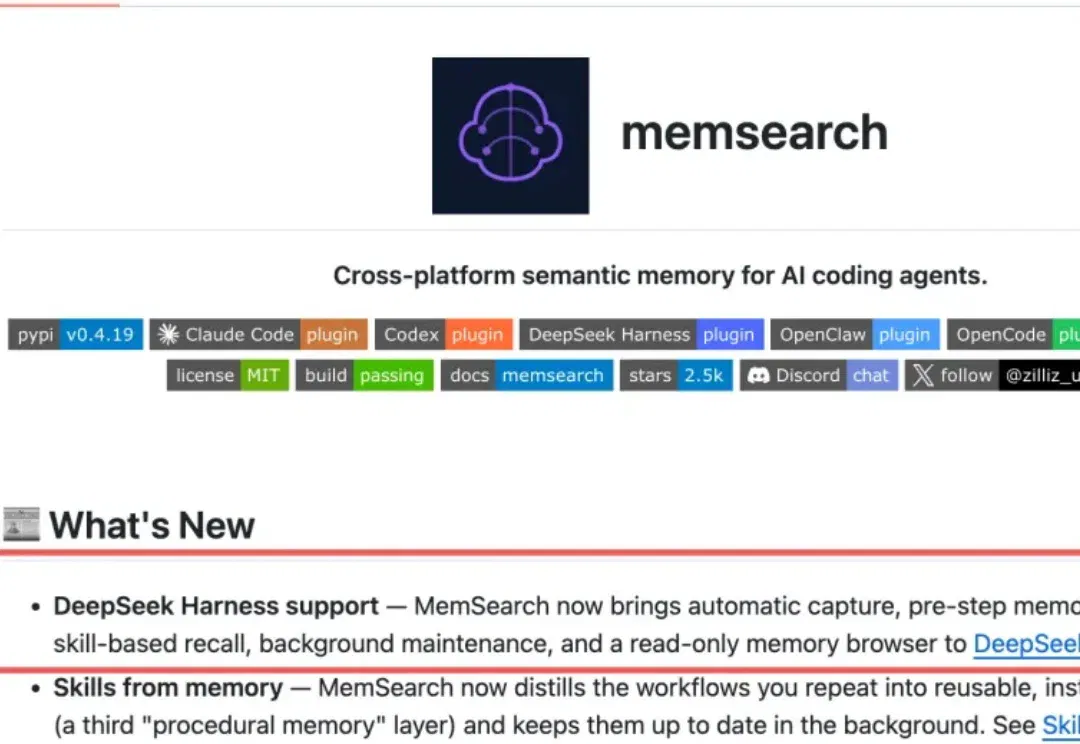
我们给DeepSeek Harness接入了MemSearch ,自动把Memory提炼成Skill (opens in a new tab)
DeepSeek Harness(DSH) 的口号,大家应该都有所了解,模型、工具、Skills、会话、沙箱、存储、Agent Loop、调度,甚至 UI,一切皆插件。
Total 45 articles
DeepSeek Harness(DSH) 的口号,大家应该都有所了解,模型、工具、Skills、会话、沙箱、存储、Agent Loop、调度,甚至 UI,一切皆插件。
Meta发布新一代旗舰模型家族Muse Wonder,推出Muse Wonder和Muse Wonder Full,引入Active Memory与Active Focus,并在Agent、记忆及编程等关键评测中取得领先成绩。
第一篇论文来自字节SEED团队, 打了一些基础; 《Over-Tokenized Transformer》。 论文标题看上去在讨论“过度分词”。 而重点必然是在第二篇上—— DeepSeek公司的学术成果Engram。 《Conditional Memory via Scalable Lookup》 也就是Engram模块所出处的论文。
前天,胡彦斌发了一条小红书。 人在路上,MacBook 摊在腿上,屏幕里是 VS Code 加 Claude Code 的插件,配文一句:正在 AI Vibe Coding。 当然也有人说作秀,不过,至少姿势看着还挺专业的。 评论区直接热闹起来,有个网友顺手把他的歌改了一遍 —— 「你要的 token 全拿走,把 memory 化成空。不要在乎 model context 有所保留,说过的话当 skill 附送。」 整个画风非常抽象。 但你仔细看大家讨论的点,会发现核心争议在另一个地方:「一个音乐人怎么也来抢程序员饭碗了」。 可如果你翻一翻各个社区,你会发现还有相当一部分人对 Vibe Cod
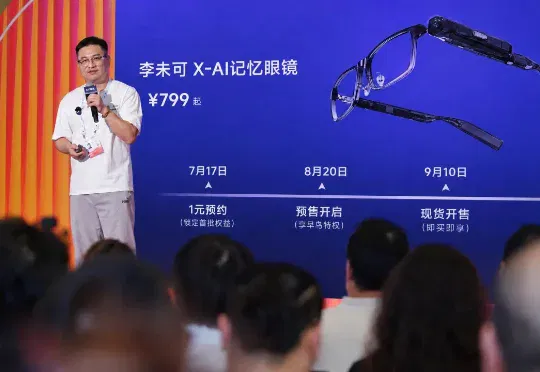
在行业陷入“刷榜”怪圈、产品功能同质化严重的今天,一家来自杭州的AI眼镜公司在WAIC大会上给出了不一样的答案:李未可科技正式发布了一款拥有“记忆”的AI眼镜——X-AI记忆眼镜,在这款产品背后,是基于WakeeMemory OS实现的“AI记忆能力体系”。
随着新一代主动执行型 Agent(如 OpenClaw、Hermes Agent 等)的爆发,AI 正经历从「被动工具」向「具备自我演化(Self-Evolving)能力的智能体」的范式跃迁。然而,受限于上下文窗口极限与记忆缺失,现有 Agent 难以在复杂任务中实现经验的复用与自我进化。
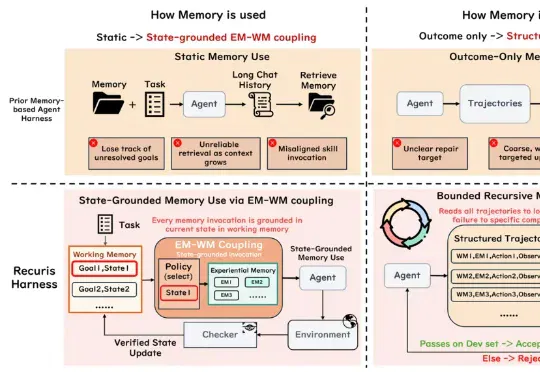
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
今天,Anthropic专为Claude上线了「导入记忆」(Import Memory)新功能,可一键丝滑搬家。只需一次简单的「复制粘贴」,就能将ChatGPT所有上下文,完整迁移至Claude。
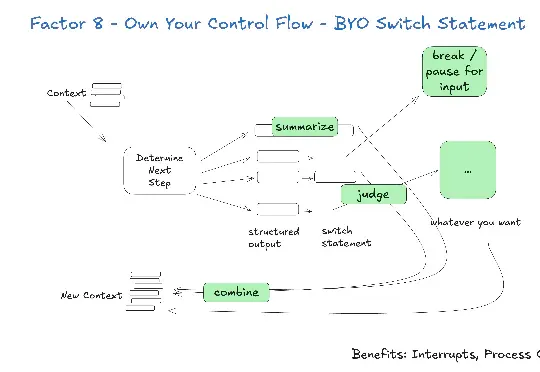
最近半年,我阅读了业界关于 AI Agent 的工程实践:Anthropic 的 Context Engineering 论文、Manus 的工程分享、Cline 的 Memory Bank 设计等。同时自己也一直在做跟 AI Agent 相关的项目,如:Jta[1](开源的翻译 Agent,基于 Agentic Workflow)。
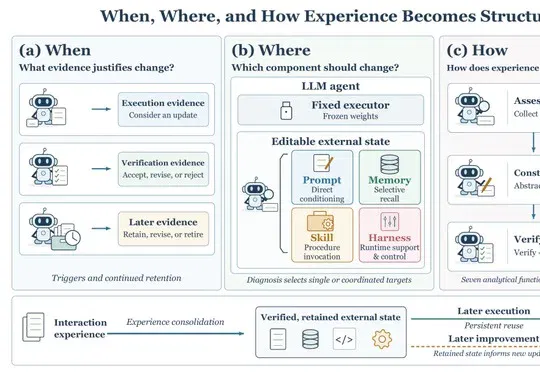
The paper compares Prompt, Memory, Skill and Harness evolution through a seven-step lifecycle, emphasizing independent verification, regression checks and long-term maintenance.