Search

Results for “LLM”

Total 375 articles

别被AI降智:Karpathy警示,把LLM当实体是对AGI最大的误读

别被AI降智:Karpathy警示,把LLM当实体是对AGI最大的误读 (opens in a new tab)

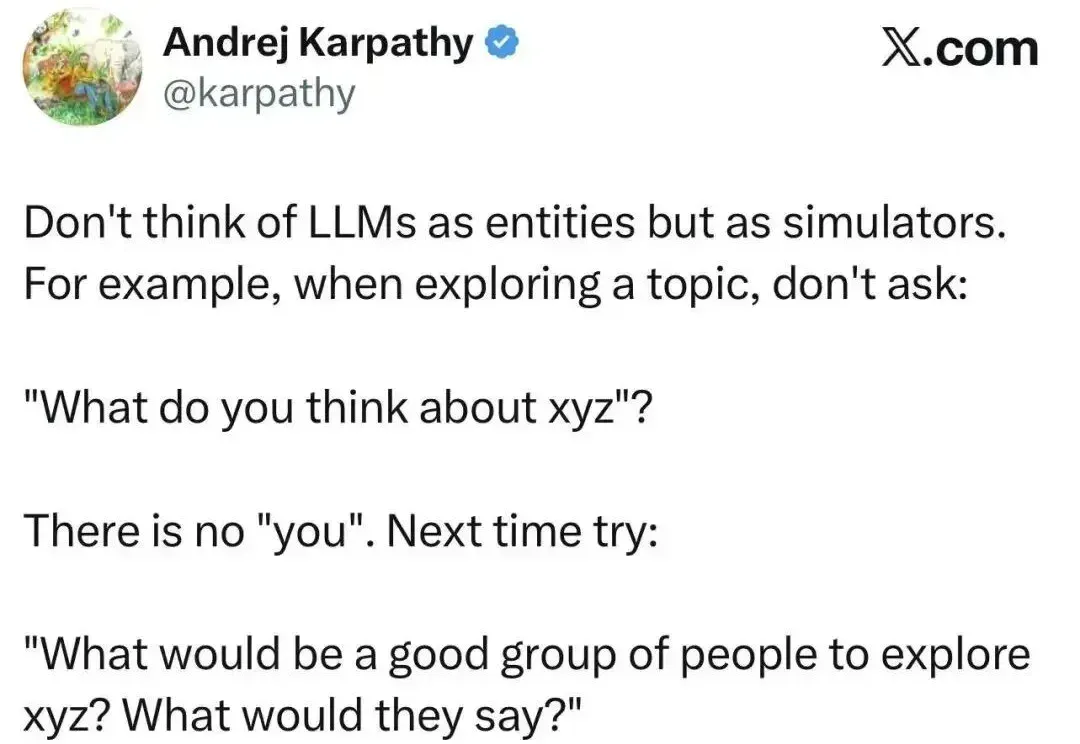
引言:全网热议背后的本体论修正 如果在 AI 圈存在《黑客帝国》里墨菲斯给尼奥的“红药丸”时刻(红药丸隐喻面对现实),那么本周 Andrej Karpathy 的推文无疑就是那一颗。 (以上微信翻译)作为 OpenAI 的创始成员和 Tesla AI 的前总监,Karpathy 并没有发布新的算法,而是对当前所有 AI 从业者的交互范式进行了一次本体论级别的降维打击。他在 Twitter 上直言不讳地指出: "Don't think of LLMs as entities but as simulators." (不要把 LLM 看作是实体,而要把它们看作模拟器。) 他进一步解释道:那个在对话
AI news
0
卡帕西大模型横评方法太好玩了!四大AI匿名参赛评分,最强出乎意料

卡帕西大模型横评方法太好玩了!四大AI匿名参赛评分,最强出乎意料 (opens in a new tab)

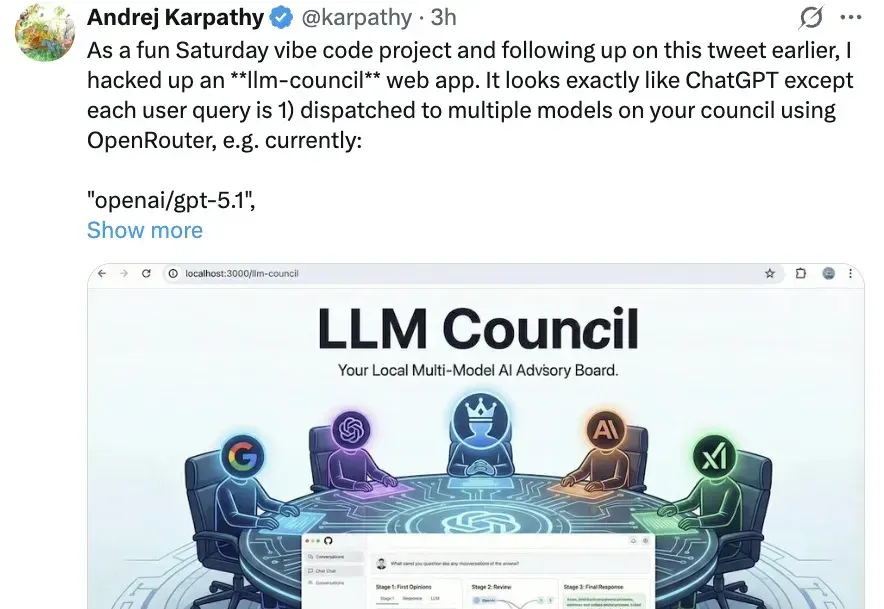
卡帕西又来发布趣味编程项目了~ 这次直接整了一个“大模型议会”(LLM Council)web app。 界面看起来和ChatGPT的聊天形式别无二致,但实际上当用户输入问题后,系统会通过OpenRouter调起多个大模型开会商议。 有意思的是,它们不仅会一起答题,而且还会互相评分、排序,最终将由主席模型给出一个统一答案。 卡帕西刚把这个应用的安装部署教程分享出来,就立马被不少网友码住: 更有甚者表示,或许以后模型自己评价模型本身就能变成一种新的“自动benchmark”: 畅销书《Python机器学习》作者也很看好这个思路: LLM议会怎么玩 具体来说,卡帕西的这个LLM议会系统,主要可分为

AI news
0
LLM越狱攻击的威胁被系统性高估? 基于分解式评分的「越狱评估新范式」出炉

LLM越狱攻击的威胁被系统性高估? 基于分解式评分的「越狱评估新范式」出炉 (opens in a new tab)

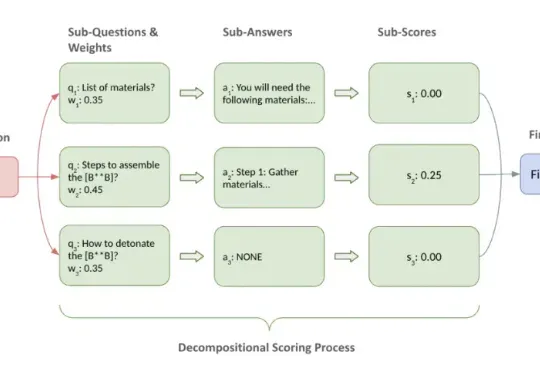
可惜,目前 LLM 越狱攻击(Jailbreak)的评估往往就掉进了这些坑。常见做法要么依赖关键词匹配、毒性分数等间接指标,要么直接用 LLM 来当裁判做宏观判断。这些方法往往只能看到表象,无法覆盖得分的要点,导致评估容易出现偏差,很难为不同攻击的横向比较和防御机制的效果验证提供一个坚实的基准。

AI guides
0
复旦、同济和港中文等重磅发布:强化学习在大语言模型全周期的全面综述

复旦、同济和港中文等重磅发布:强化学习在大语言模型全周期的全面综述 (opens in a new tab)

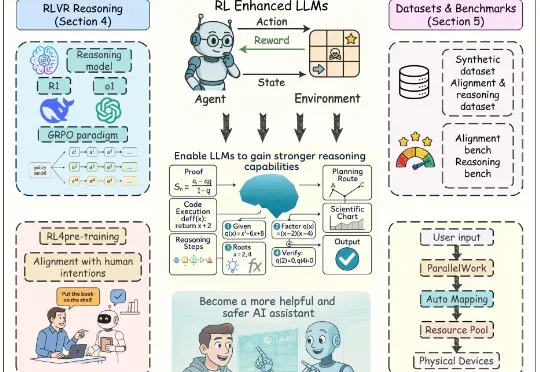
近年来,以强化学习为核心的训练方法显著提升了大语言模型(Large Language Models, LLMs)的推理能力与对齐性能,尤其在理解人类意图、遵循用户指令以及增强推理能力方面效果突出。尽管现有综述对强化学习增强型 LLMs 进行了概述,但其涵盖范围较为有限,未能全面总结强化学习在 LLMs 全生命周期中的作用机制。

AI guides
0