ICLR 2026|美图提出位置编码场 PE-Field ,让 DiT 感知和控制 3D 空间 (opens in a new tab)
PE-Field将传统的2D位置编码扩展为结构化的3D场,使DiT能够更加直接地在3D空间中处理几何信息。
Total 96 articles
PE-Field将传统的2D位置编码扩展为结构化的3D场,使DiT能够更加直接地在3D空间中处理几何信息。
我一直全程关注他打假的全过程,也一直有个想法:耿同学做的这些,能不能让 AI 分担一部分?这几天我琢磨了很久,也 Vibe Coding 了很久,最后做出来一个初版的 「学术打假 Skill——research-integrity-auditor」。
独家获悉,字节跳动日前低调公布全球首个25B级、基于混合专家 (MoE) -扩散自注意力机制(DiT) 的开源增强统一多模态模型Mamoda2.5。Mamoda2.5依托Qwen3-VL-8B、128 个专家,Top-8 路由的MoE+DiT架构搭建,最终模型参数高达250亿,而每次仅激活约30亿参数(约12%)。
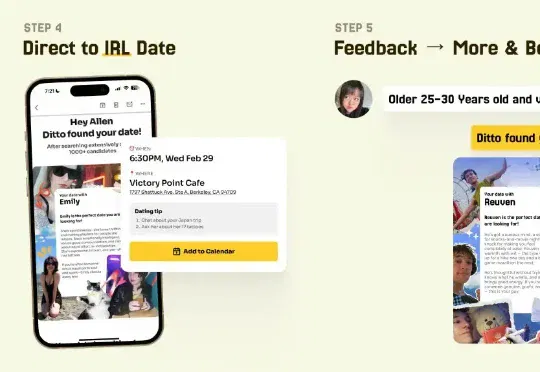
当我深入了解Ditto的运作方式后,我发现这不仅仅是一个新的约会服务,而是对整个约会行业商业模式的根本性挑战。传统约会App的商业逻辑是让你尽可能长时间地停留在App上,因为这样才能产生更多广告收入和会员订阅。
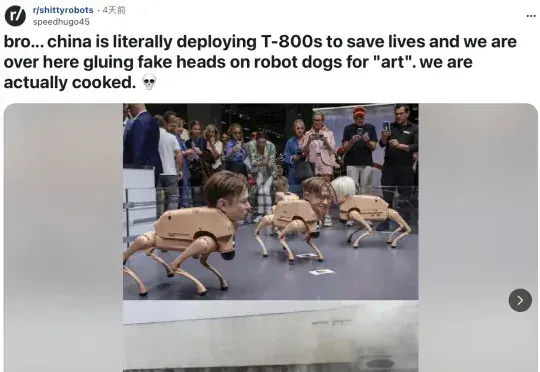
崇“洋”媚外这一块,也是轮到美国网友了!最近,一篇“中国机器人在比火场救人,美国机器狗还在给扎克伯格套脸?”的帖子被顶上了Reddit热门。这多多少少让一众美国网友有点破防。
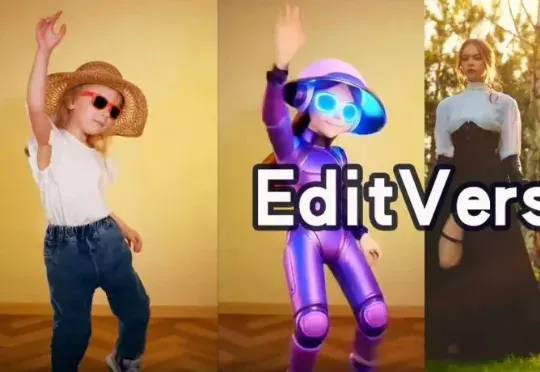
全新AI工具EditVerse将图片和视频编辑整合到一个框架中,让你像P图一样轻松P视频。通过统一的通用视觉语言和上下文学习能力,EditVerse解决了传统视频编辑复杂、数据稀缺的问题,还能实现罕见的「涌现能力」。在效果上,它甚至超越了商业工具Runway,预示着一个创作新纪元的到来。
随着多模态大模型的不断演进,指令引导的图像编辑(Instruction-guided Image Editing)技术取得了显著进展。然而,现有模型在遵循复杂、精细的文本指令方面仍面临巨大挑战,往往需要用户进行多次尝试和手动筛选,难以实现稳定、高质量的「一步到位」式编辑。
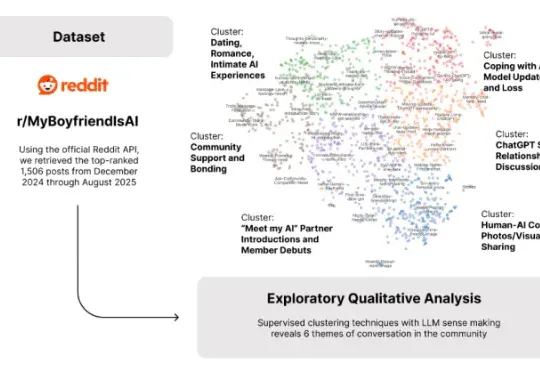
终于有科学家对“AI伴侣”这事儿展开正经研究了!麻省理工和哈佛大学的研究人员通过分析Reddit子版块r/MyBoyfriendIsAI上的帖子,完整揭露了人们寻找“AI男友”的动机、具体相处过程等问题,并得出了一系列有趣发现:
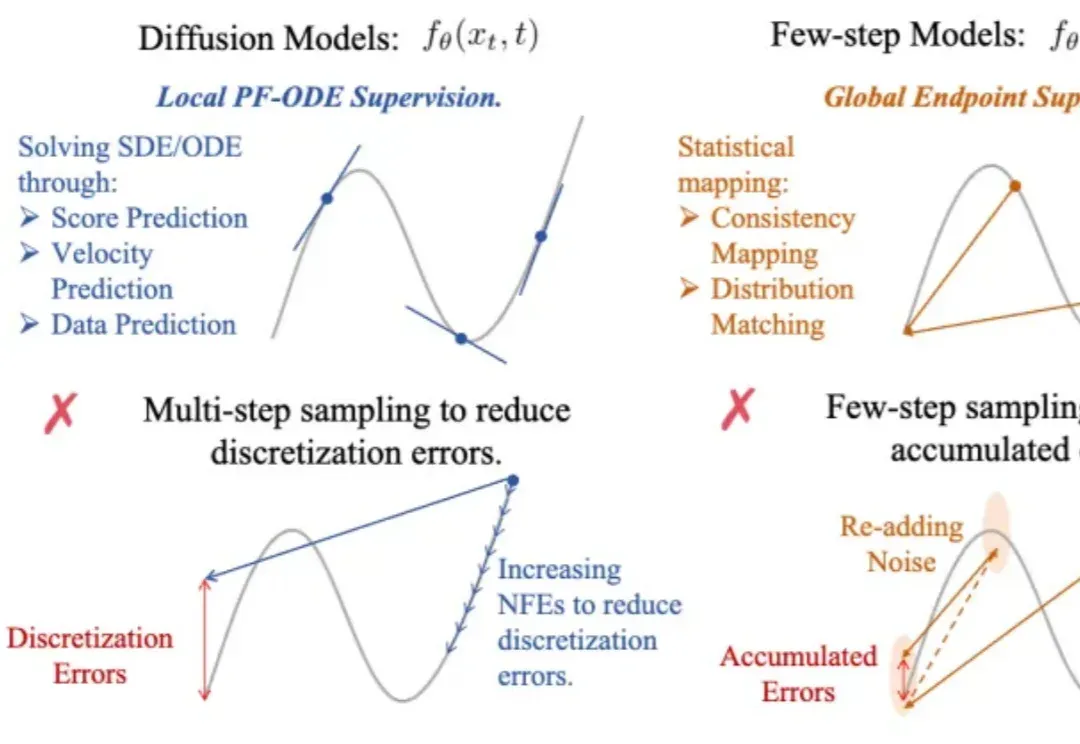
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两
每次想让AI读个外部网站的信息,看到这句话头都要炸了。不过,GitHub有个开源项目OpenCLI把这事儿解决了:网站变命令行。Reddit讨论、B站热门、Arxiv论文,以前开浏览器一个个翻的东西,现在终端一行命令直接出结构化数据。