刚刚,DeepSeek-V4-Flash正式版API公测上线! (opens in a new tab)
7月31日,DeepSeek正式向公众开放V4-Flash正式版API公测。这一次,最亮眼的关键词是——Agent能力大幅跃升。9项基准测试成绩全面披露,多项指标远超此前发布的V4-Pro-Preview预览版,直接将“代码智能体”的天花板又顶高了一截。
Total 40 articles
7月31日,DeepSeek正式向公众开放V4-Flash正式版API公测。这一次,最亮眼的关键词是——Agent能力大幅跃升。9项基准测试成绩全面披露,多项指标远超此前发布的V4-Pro-Preview预览版,直接将“代码智能体”的天花板又顶高了一截。

DeepSeek Flash系列自明日中午起降价,闲时缓存、输入和输出价格分别降至每百万Token 0.02元、1元和4元,新模型DeepSeek v4.1 Flash也已上线。
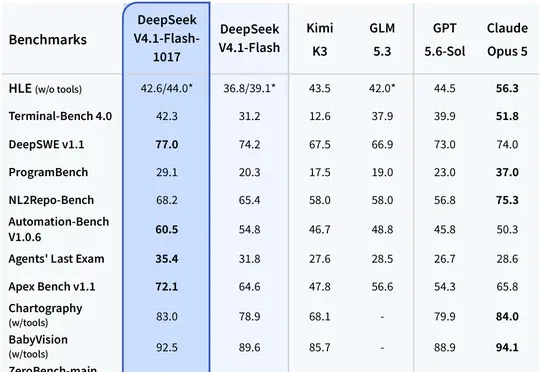
DeepSeek官宣DeepSeek-V4.1-Flash-1017全面上线,网页、App和API同步更新且价格不变,在DeepSWE v1.1取得77%最高分,并开放MIT许可证权重及Search/Fetch搜索API。
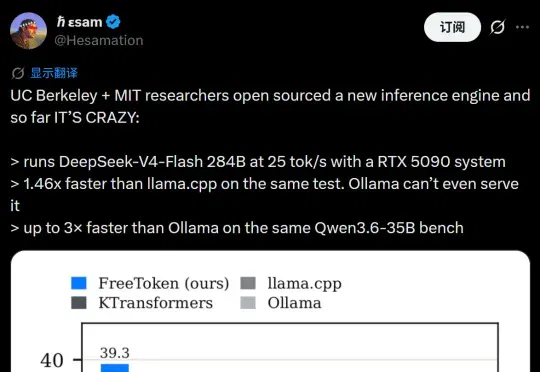
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
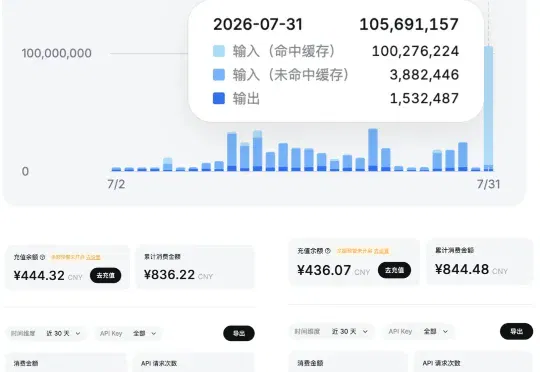
DeepSeek-V4-Flash风评冲爆了,原生支持接入Codex,而且还强化了Agent能力。我第一时间把它接进了Codex,用cc swich非常方便。一个小时,跑了一亿多token。跟大家说说体感。
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
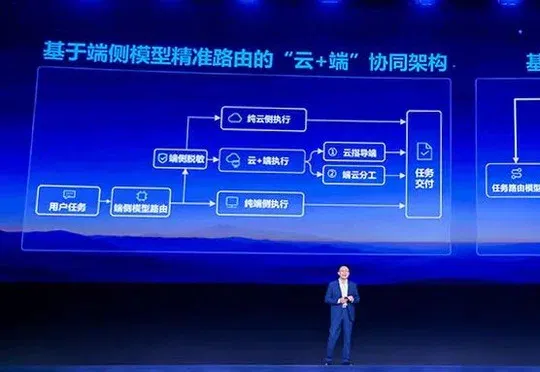
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。

家人们,DeepSeek V4.1 Flash 开启内测了。

刚刚,DeepSeek 开源了 V4.1 Flash,原生支持视觉理解,也是全新架构系列中最小的一款模型,550B 总参数,输入时激活 8B,输出时激活 16B(你没看错,输入输出激活不同)
DeepSeek V4 Flash的价格风暴,还在继续。