刚刚,Qwen3.8-Flash震撼发布,我们看到了Qwen4的骨架 (opens in a new tab)
就在刚刚,阿里交出了一份让人满意的答卷:发布了 Qwen3.8-Flash,同步开源 Qwen3.8-Flash-Next(两者为同一模型,前者是 API 版本名称,后者是开源版本的正式名称)。它的成绩相当亮眼。在智能体编程基准 DeepSWE 1.1 上,它拿到 58.7 分,而参数规模是它三倍的前代 Qwen3.7-Plus 只有 16.5 分;
Total 235 articles
就在刚刚,阿里交出了一份让人满意的答卷:发布了 Qwen3.8-Flash,同步开源 Qwen3.8-Flash-Next(两者为同一模型,前者是 API 版本名称,后者是开源版本的正式名称)。它的成绩相当亮眼。在智能体编程基准 DeepSWE 1.1 上,它拿到 58.7 分,而参数规模是它三倍的前代 Qwen3.7-Plus 只有 16.5 分;
今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个原生多模态模型。大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权威的Artificial Analysis Intelligence Index(AA综合智能指数)中取得57分
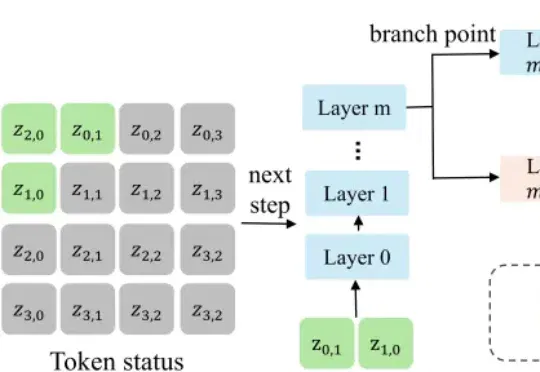
来自浙江大学和阿德莱德大学的研究团队提出了 FlashAR—— 一个轻量级的后训练加速框架。不需要从头训练,在 Emu3.5-Image-34B 模型上,仅用原始训练数据的 0.05%(约 8 万张图片),就能将预训练好的自回归模型改造成高度并行的生成器 Emu3.5-34B-Flash,实现最高 22.9 倍的端到端加速。
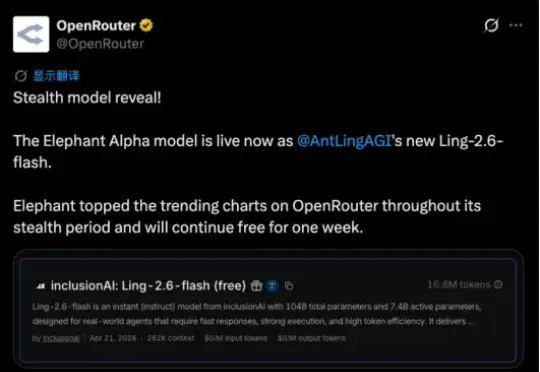
4月22日,蚂蚁百灵正式推出Ling-2.6-flash Instruct模型。该模型总参数量为104B,激活参数仅7.4B,核心主打高“Token 效率(Token Efficiency)”。API定价方面,Ling-2.6-flash输入每百万tokens定价0.1美元,输出 0.3 美元。目前,Ling-2.6-flash API已在OpenRouter及百灵tbox平台上线。
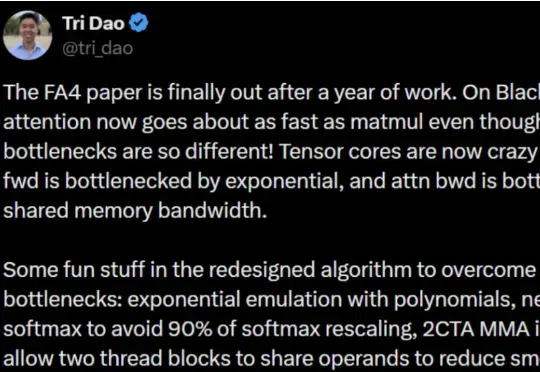
近日,深度学习领域重要底层优化技术 FlashAttention 迎来大版本更新。FlashAttention 核心作者、普林斯顿大学助理教授 Tri Dao 表示,在 Blackwell GPU 上,即使瓶颈截然不同,注意力机制的执行速度现在也几乎与矩阵乘法一样快了!
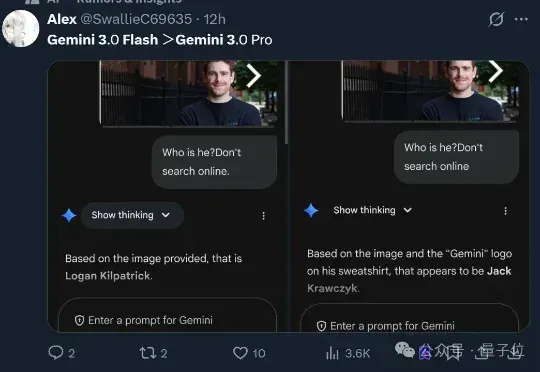
谷歌丢出Gemini 3 Flash,给AI圈示范了啥叫:小孩子才做选择题,成年人当然是全都要(doge)。一个公式来形容这款新模型:Gemini 3 Flash=Pro级智能+Flash级速度+更低价格。
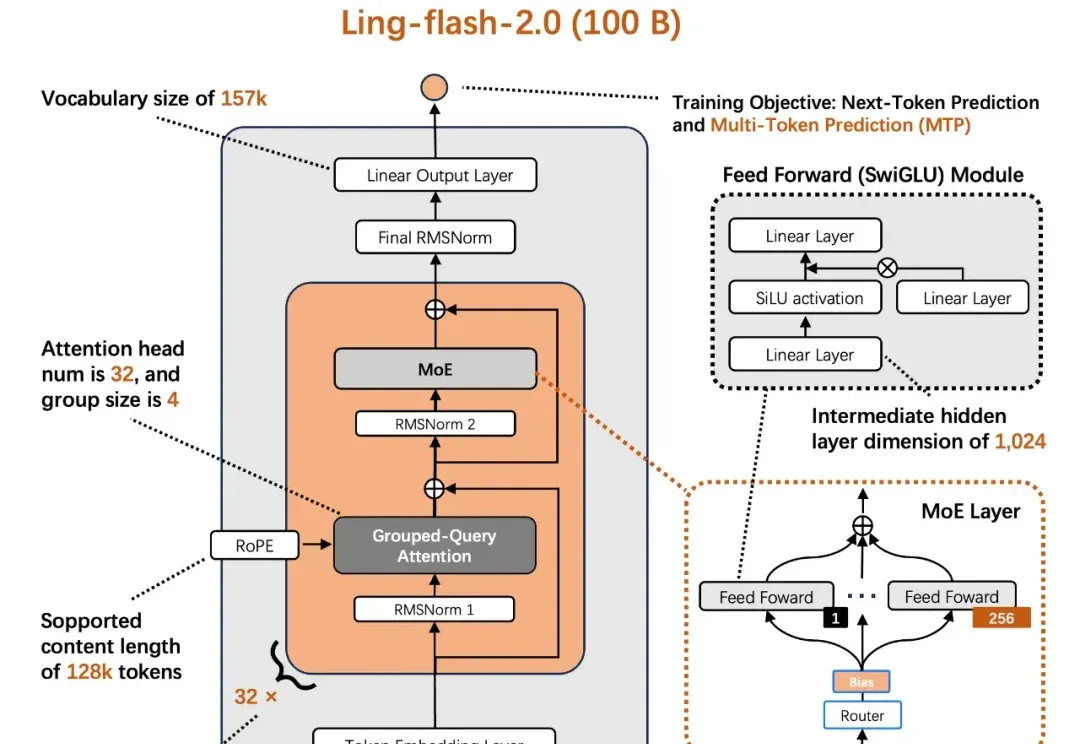
今天,蚂蚁百灵大模型团队正式开源其最新 MoE 大模型 ——Ling-flash-2.0。作为 Ling 2.0 架构系列的第三款模型,Ling-flash-2.0 以总参数 100B、激活仅 6.1B(non-embedding 激活 4.8B)的轻量级配置,在多个权威评测中展现出媲美甚至超越 40B 级别 Dense 模型和更大 MoE 模型的卓越性能。
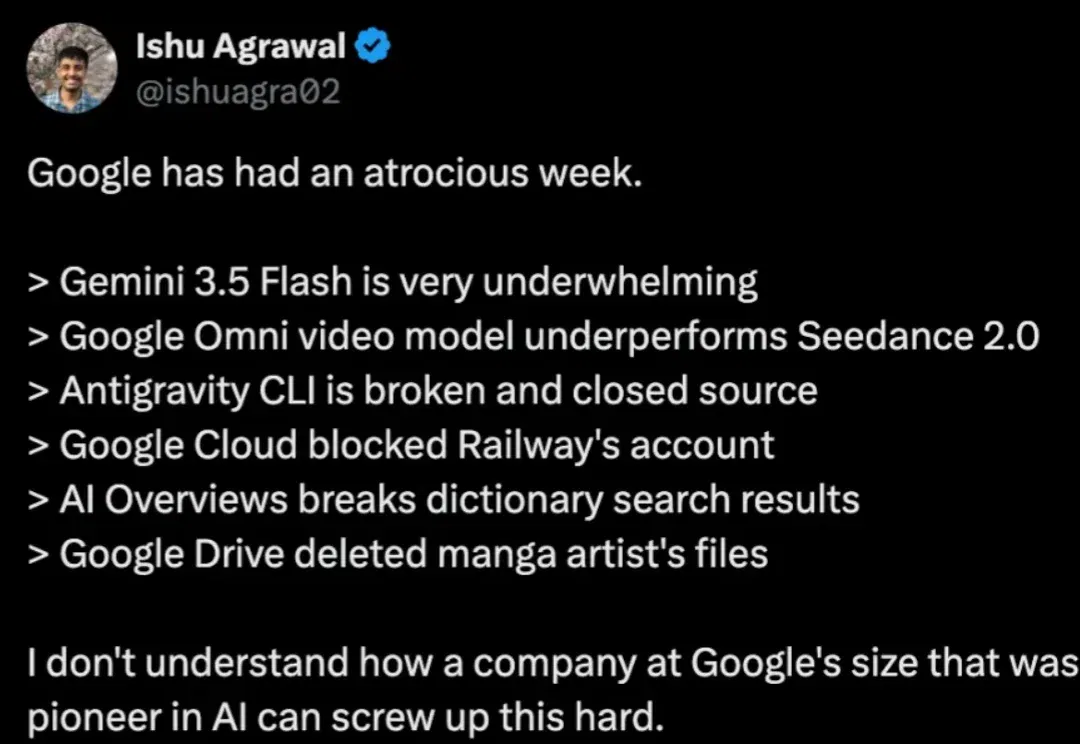
最近,谷歌的日子不太好过。 自从 I/O 大会以来,谷歌经历了连环翻车: Gemini 3.5 Flash 被网友吐槽实际体验、额度消耗和稳定性不及预期;Gemini Omni Flash 原生多模态视频生成与编辑模型,表现不如 Seedance 2.0;Antigravity CLI 闭源、bug 多、且还被抓到演示视频里出现 Codex 文件;Google Cloud 自动风控系统错误封禁了知名 PaaS 平台 Railway 的账号,导致 Railway 服务大面积宕机好几个小时;AI Overviews 搜索 disregard、ignore 等单词时,AI 不正常显示字典释义,把搜索
谷歌世界模型大牛Danijar Hafner宣布离任!他自2016年起开始在Google Brain实习,后又在DeepMind、Brain Team工作。他的经历颇具传奇色彩,曾获辛顿指导,还与Łukasz Kaiser、Ashish Vaswani等Transformer大佬有过交集。
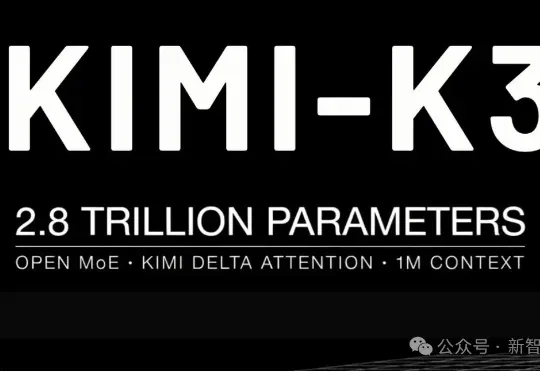
就在刚刚,全球首个3万亿参数级开源模型Kimi K3正式开源!https://github.com/MoonshotAI/Kimi-K3/tree/main。Moonshot AI宣布,发布Kimi K3的模型权重、技术报告,并开源支撑Kimi K3模型训练的关键Infra技术:MoonEP、FlashKDA和AgentEnv。