ECCV 2026|自驾VLA Scaling有戏了,北航清华DriveTeach-VLA:用图像轨迹打通驾驶场景与基模预训练 (opens in a new tab)
本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
Total 68 articles
本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
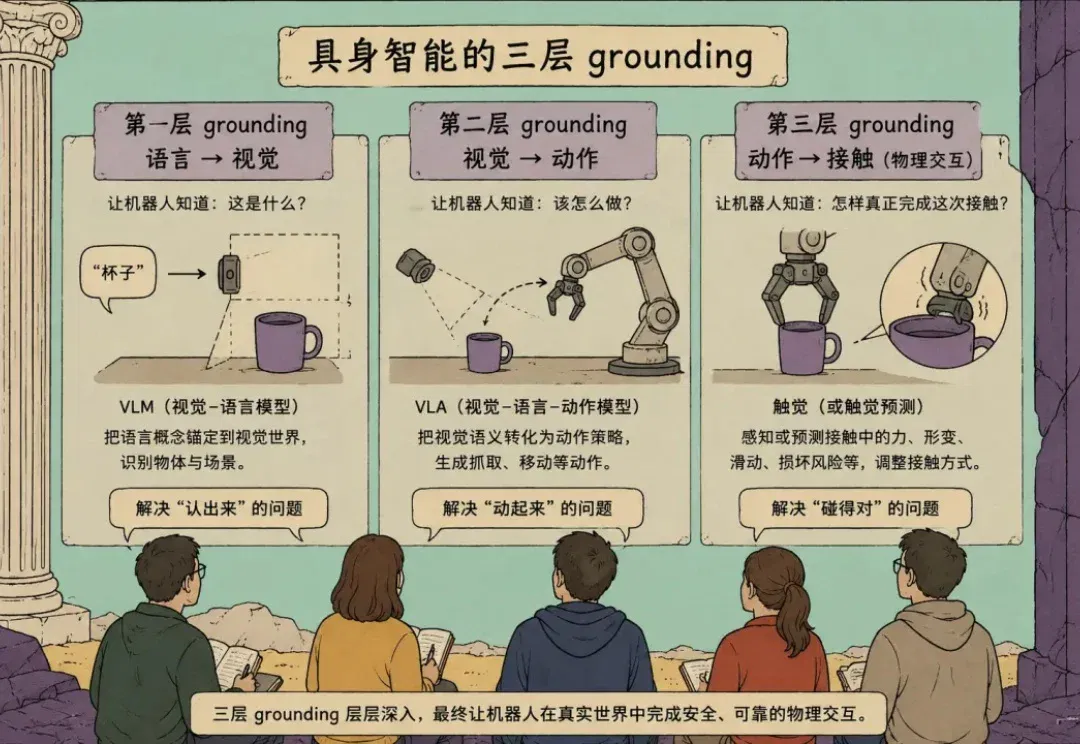
机器人,也开始拥有“触觉想象力”了。 过去一年,随着具身基础模型的快速发展,机器人已经能完成不少轮廓清晰、位置明确的操作任务。 可一旦涉及柔性物体、易损物体或密集接触,机器人往往就开始力不从“脑”。 △AI生成 无论是捏起一颗葡萄而不将它捏破,还是抓住一只纸杯而不让它变形,视觉只能帮助机器人找到目标,想要完成任务,机器人还需要人类与物体交互时不可或缺的触觉感知。 也正因为如此,现在也有越来越多团队开始将触觉作为建构机器人大脑的重要模态。比如,UniTouch、AnyTouch尝试统一不同传感器的触觉表征,FuSe、Tactile-VLA把触觉送进通用策略与VLA,近期的TacImag则开始探索
谷歌正式开放世界模型Genie 3的实验性研究原型Project Genie。一夜间暴打了游戏公司市值。《GTA》开发商Take-Two Interactive缩水10%,在线游戏平台Roblox 下跌了超过12%,最惨的是游戏引擎制造商Unity下跌了21%。
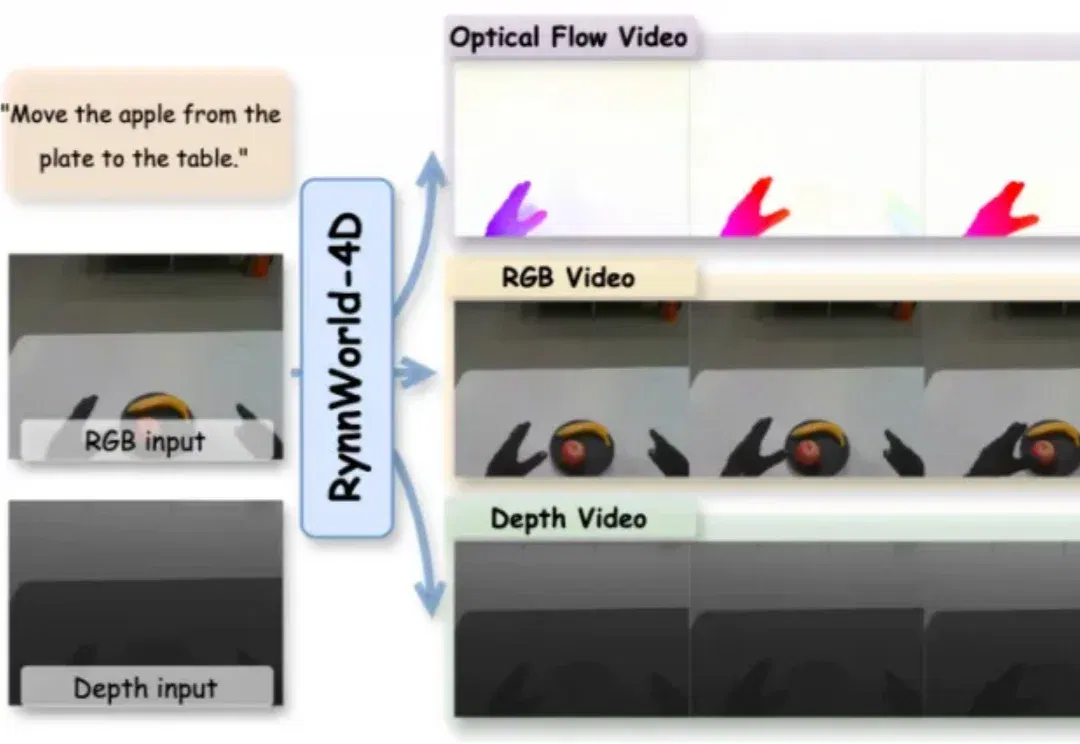
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
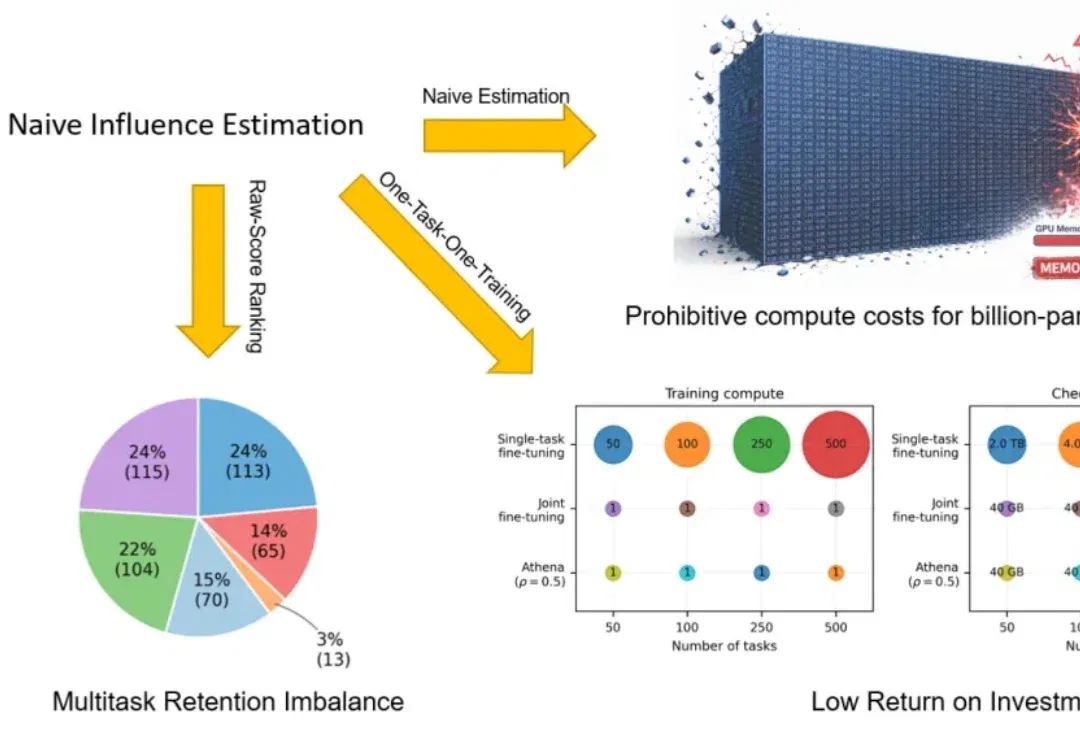
具身智能正在进入数据 scaling 时代。Vision-Language-Action(VLA)模型让机器人可以从大规模示教数据(demonstrations)中学习更通用的操作策略。但对机器人 VLA 训练来说,数据并不总是越多越好:低质量数据可能会拖累模型性能,而每一条 demonstration 都意味着昂贵的人力采集、机器人运行,以及云端存储和训练成本。
刚刚,Anthropic 发布论文《Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations》,试图用一套 自然语言自动编码器(Natural Language Autoencoders,下文简称 NLA), 撬开这个黑箱。
12月8日,Airwallex空中云汇继今年5月后再次宣布获得新一轮3.3亿美元G轮融资,投后估值达 80 亿美元,较六个月前 F 轮融资时上涨近 30%。本次融资由Addition领投,T. Rowe Price、Activant、Lingotto、Robinhood Ventures和 TIAA Ventures等全球顶级资本参与投资。
复杂的简历,AI也能读懂了。 阿里巴巴集团研究团队,开发出了一套基于布局感知的简历解析框架。 该框架在简历解析任务上的准确率逼近Claude-4等业界顶尖大模型,处理整份简历仅需1-2秒。 而且这项创新直击自动化简历解析的三大痛点——版面格式多样、大模型成本高昂及响应速度慢,为智能招聘树立了新的效率与精度标杆。 该技术框架的论文《Layout-Aware Parsing Meets Efficient LLMs: A Unified, Scalable Framework for Resume Information Extraction and Evaluation》已发布。 长久以来,自动
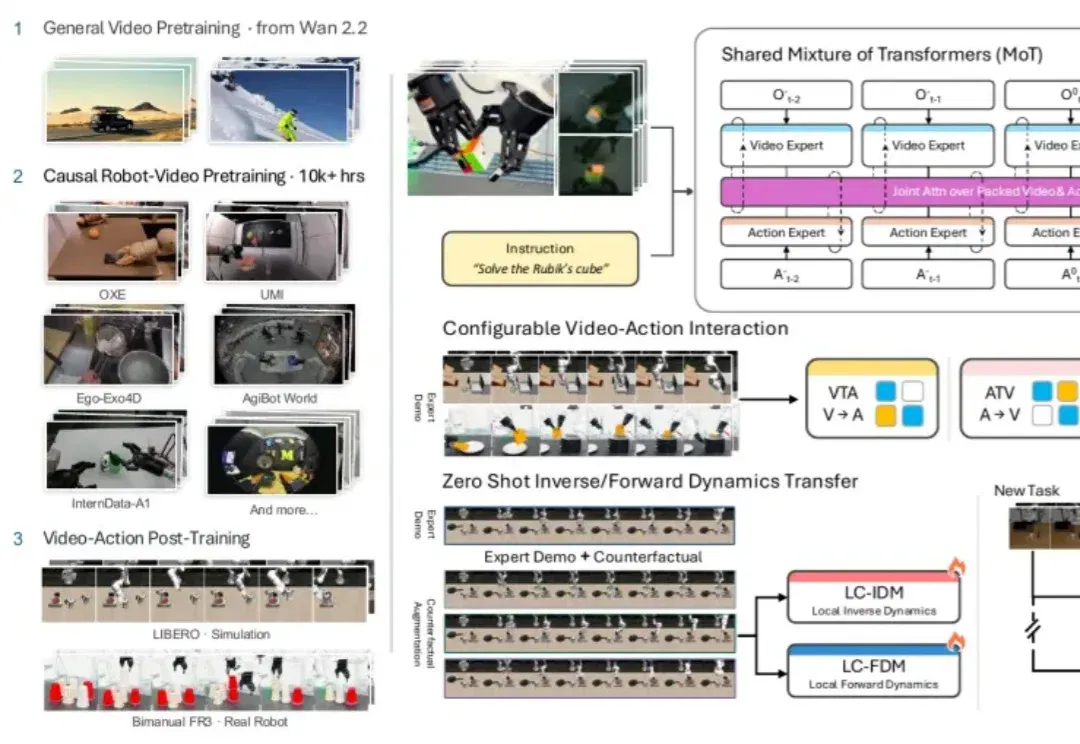
9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action。据其官方博客,该模型在英伟达 RoboLab-120 榜单上超过了此前最强的开源模型 Cosmos 3 Nano,参数量却不到后者一半。一家做图像生成的公司跑来卷机器人控制,说明视频模型里积累的「物理直觉」正被越来越多的团队当作机器人大脑的底座。
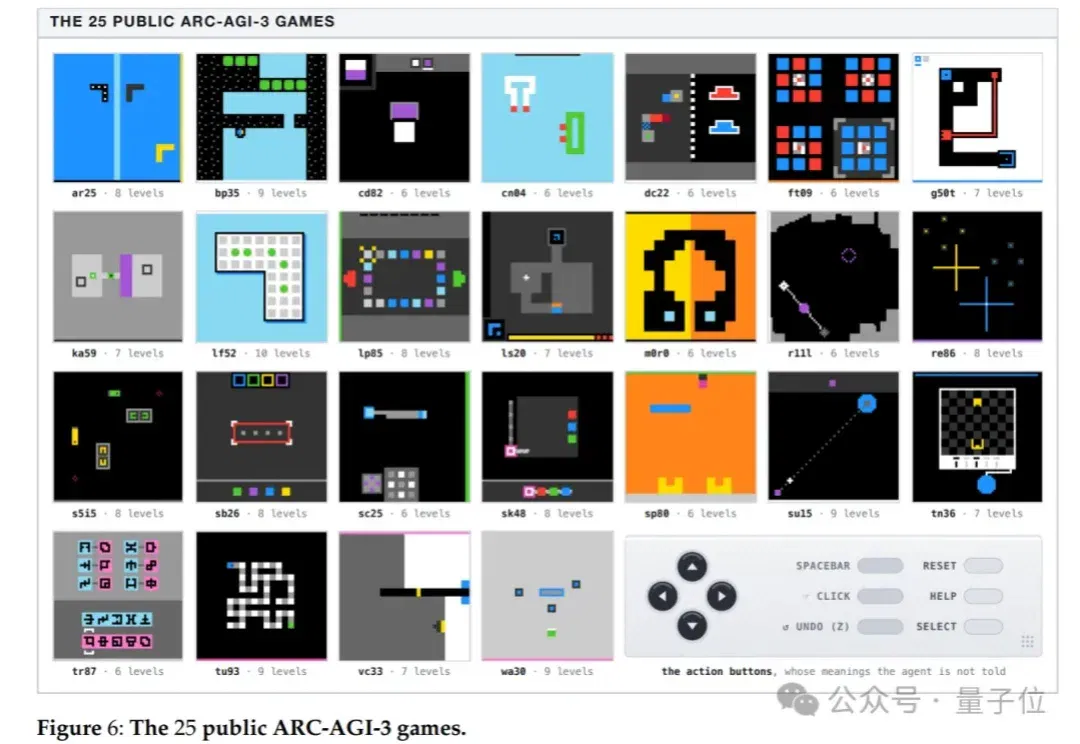
一边打游戏,一边给自己升级? 好家伙,华为这波直接让AI学会了《边玩边变强》啊?! 最新一项研究,华为诺亚方舟实验室联合UCL等团队拿出了一个名叫Memento 3的AI智能体系统—— 直接把ARC-AGI-3公开集里的25款游戏、183个关卡,全部打通了。 还不是靠无脑试错硬闯过去的。 人类完成同样一套关卡,需要17135次操作。 而Memento 3只用了7518次,比人类少操作约56%,最终拿下了满分100的RHAE成绩(Relative Human Action Efficiency,相对人类行动效率)。 更离谱的是,这套系统以Claude Opus 5为底模,全程没有更新模型权重,也