可灵2.5 Turbo太凶残:30%成本暴降+效果飞跃,生成体操动作可去参赛 (opens in a new tab)
刚刚,快手可灵AI基座模型再升级,推出可灵2.5 Turbo视频生成模型。AI视频玩家抹一把老泪,终于有AI视频模型让运动员们拥有不鬼畜自由了!a16z合伙人在𝕏上分享了一个可灵2.5 Turbo生成的视频:
Total 76 articles
刚刚,快手可灵AI基座模型再升级,推出可灵2.5 Turbo视频生成模型。AI视频玩家抹一把老泪,终于有AI视频模型让运动员们拥有不鬼畜自由了!a16z合伙人在𝕏上分享了一个可灵2.5 Turbo生成的视频:
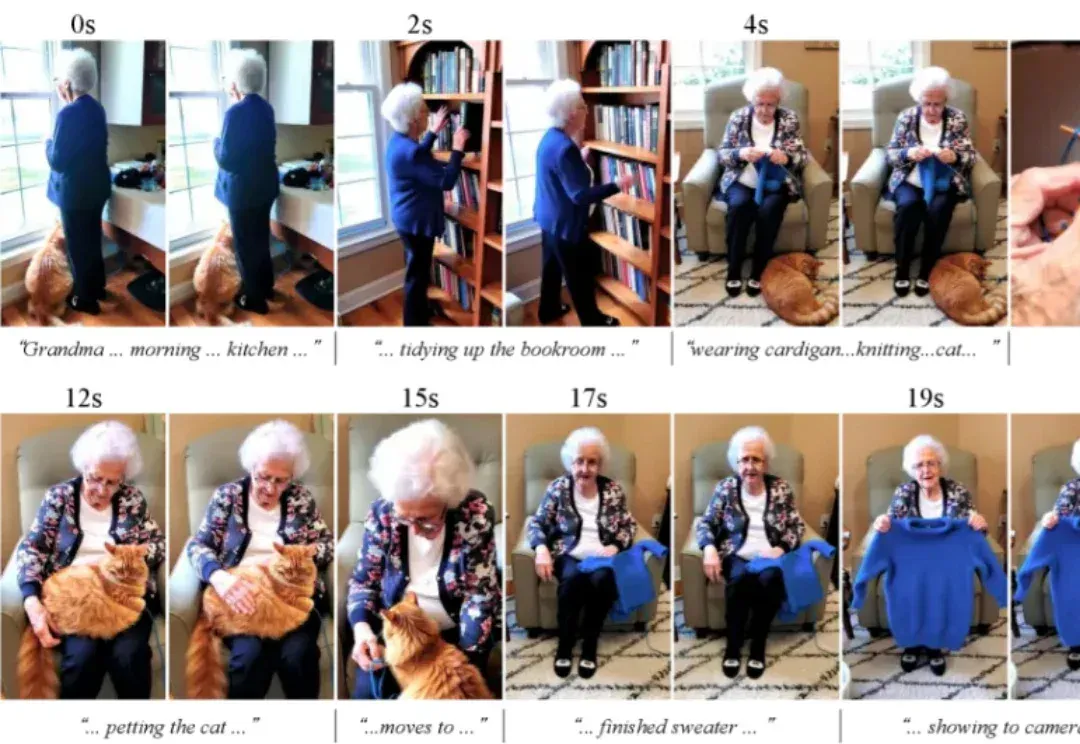
大部分的高质量视频生成模型,都只能生成上限约15秒的视频。清晰度提高之后,生成的视频时长还会再一次缩短。
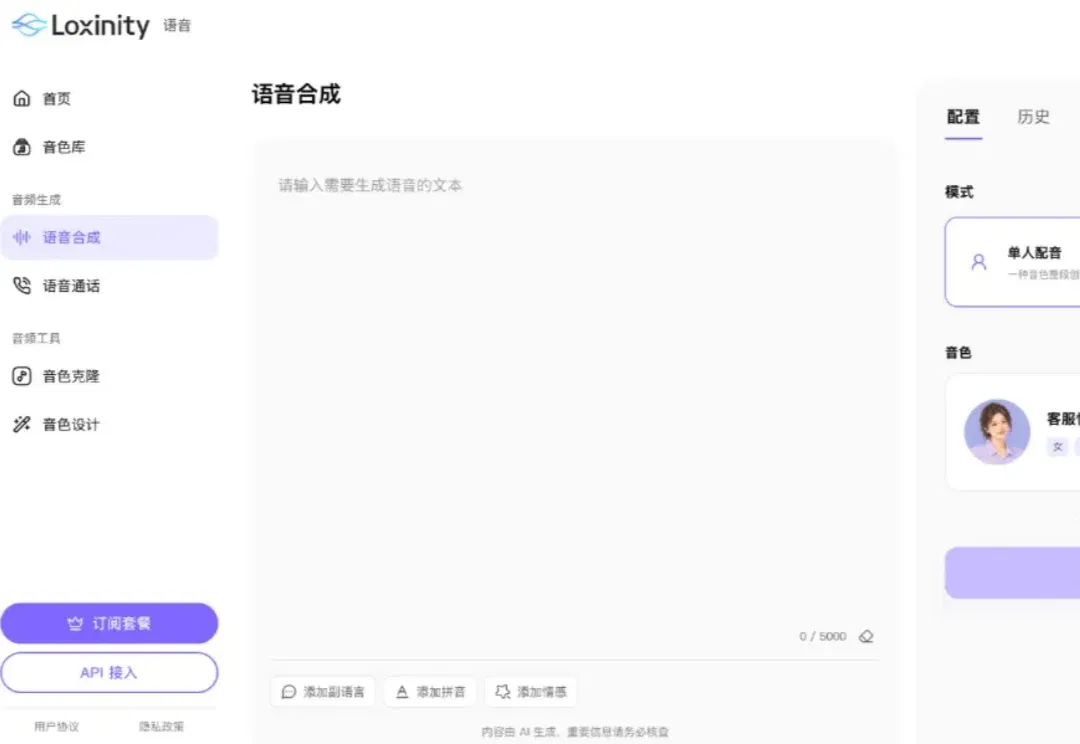
《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。
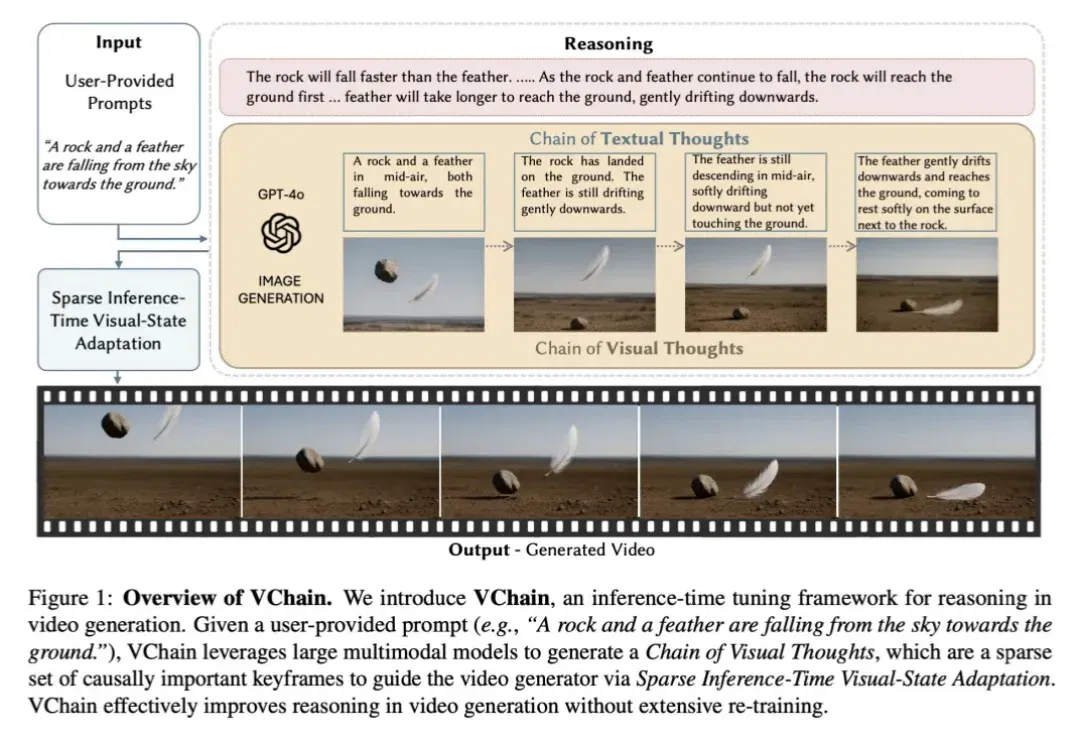
当视频生成模型在视觉保真度上不断突破时,一个核心瓶颈正变得愈发清晰:模型是否真正理解了真实世界?能否推理出合理的演变过程?
To C玩梗是Sora的热闹,用多模态大一统模型服务专业客户,才是AI视频生成的正经生意。
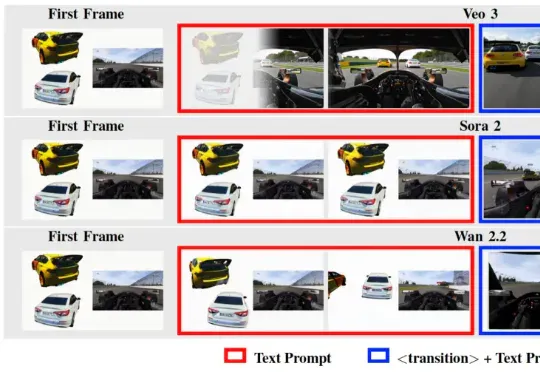
在 Text-to-Video / Image-to-Video 技术突飞猛进的今天,我们已经习惯了这样一个常识: 视频生成的第一帧(First Frame)只是时间轴的起点,是后续动画的起始画面。
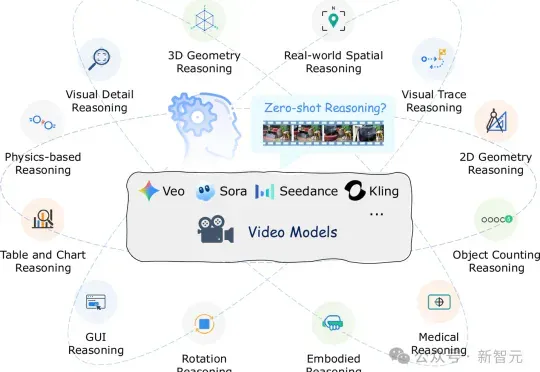
视频生成模型如Veo-3能生成逼真视频,但有研究发现其推理能力存疑。香港中文大学、北京大学、东北大学的研究者们设计了12项测试,发现模型只能模仿表面模式,未真正理解因果。这项研究为视频模型推理能力评估提供基准,指明未来研究方向。
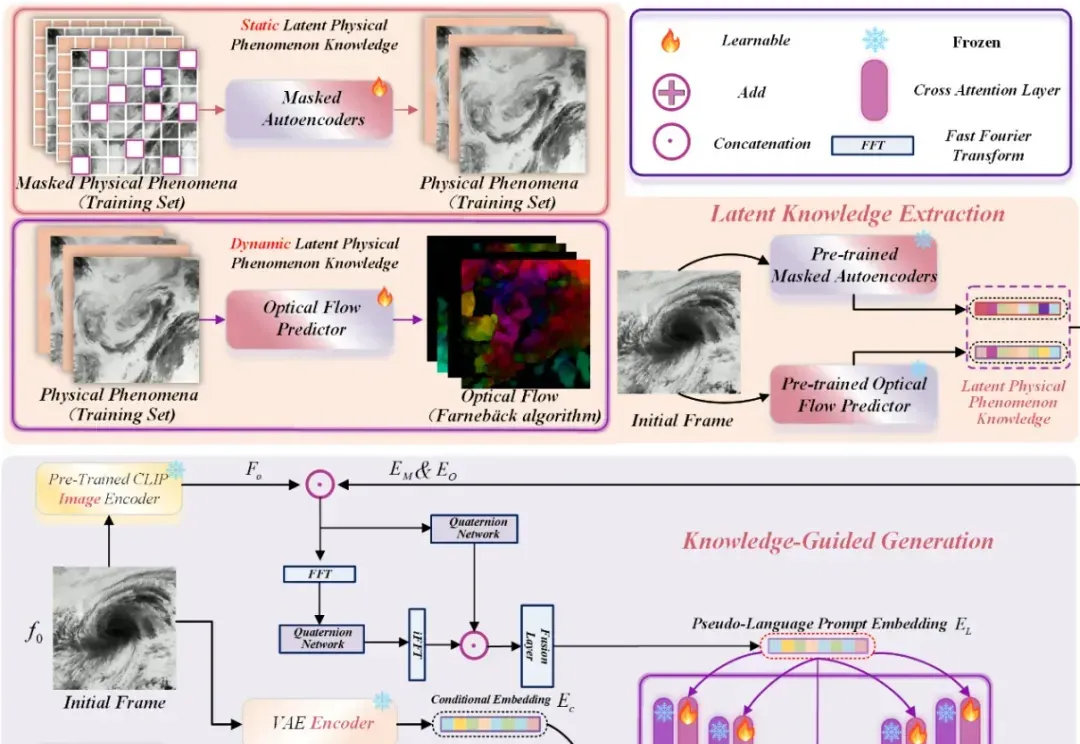
近年来,Stable Diffusion、CogVideoX 等视频生成模型在自然场景中表现惊艳,但面对科学现象 —— 如流体模拟或气象过程 —— 却常常 “乱画”:如下视频所示,生成的流体很容易产生违背物理直觉的现象,比如气旋逆向旋转或整体平移等等。
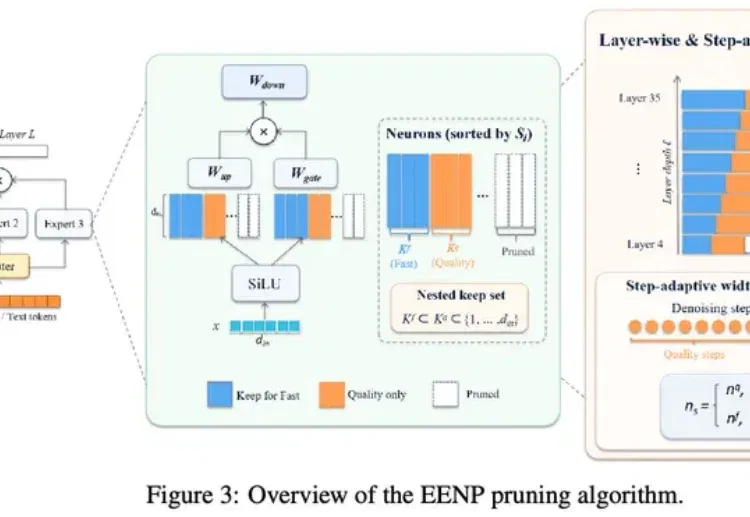
AI 视频越来越逼真,生成它的算力却并不便宜。复杂的动作、连贯的镜头和细腻的画面,背后都需要大量计算。一旦进入批量制作,反复生成、修改和重试的开销便会累积,成为创作者与视频平台必须考虑的成本。
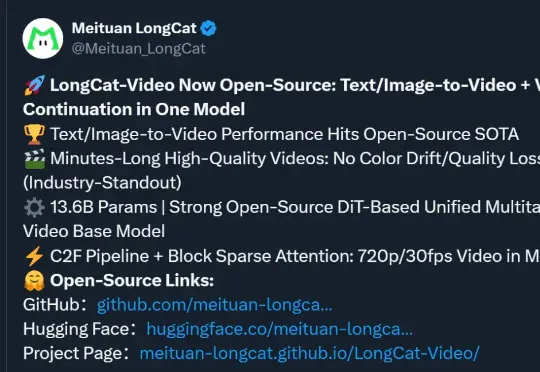
美团,你是跨界上瘾了是吧!(doge)没错,最新开源SOTA视频模型,又是来自这家“送外卖”的公司。模型名为LongCat-Video,参数13.6B,支持文生/图生视频,视频时长可达数分钟。