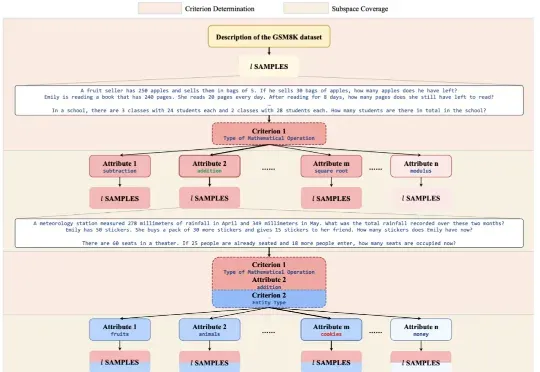
NIPS 2025 Spotlight | 港大提出TreeSynth方法,一句话生成百万规模数据集 (opens in a new tab)
“TreeSynth” 就这样起源于作者们最初的构想:“如何通过一句任务描述生成海量数据,完成模型训练?” 同时,大规模 scalibility 对合成数据的多样性提出了新的要求。
Total 74 articles
“TreeSynth” 就这样起源于作者们最初的构想:“如何通过一句任务描述生成海量数据,完成模型训练?” 同时,大规模 scalibility 对合成数据的多样性提出了新的要求。
《读佳》获知,腾讯推出面向外部行业人才的专家平台“混元智囊团”,平台Slogan为“聚智为谋,引领未来”。该平台隶属于腾讯混元旗下,通过连接各领域顶尖实战专家与真实AI训练问题,以高质量数据集生产、专业内容编写、知识审核为核心工作,产出的专家资源与专业数据服务于混元大模型持续迭代优化。
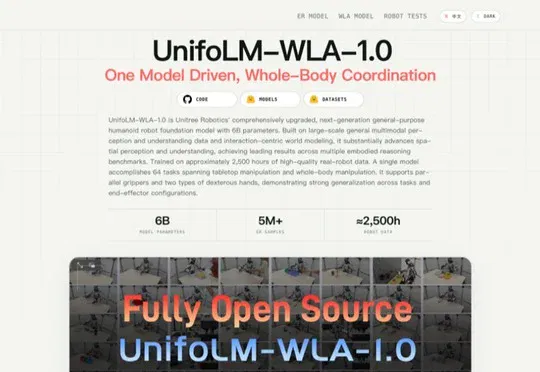
宇树科技发布6B参数通用人形机器人基础模型UnifoLM-WLA-1.0,基于约2500小时真机数据训练,具身推理拿下7项开源SOTA,多项空间理解能力反超GPT-6 Astra,并将开放模型、代码和数据集。
普林斯顿大学助理教授刘壮,在学术圈是一个颇为特殊的存在——他的每一篇论文几乎都在质疑某个“理所当然”的假设。架构真的重要吗?数据集真的足够多样吗?归一化层是必需的吗?大语言模型有世界模型吗?AI智能体能替代博士生吗?
新一代代码模型的训练动态已与旧模型截然不同,主流强化学习方法和数据集在其上几乎“失效”。
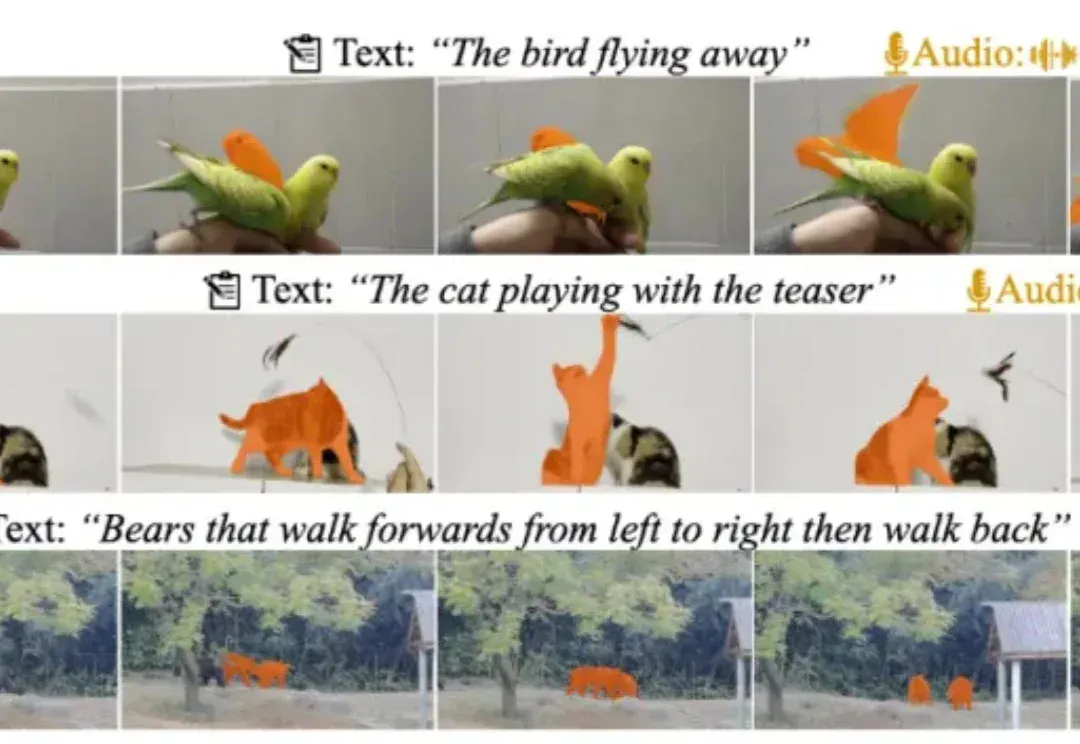
近日,多模态视频理解领域迎来重磅更新!由复旦大学、上海财经大学、南洋理工大学联合打造的 MeViSv2 数据集正式发布,并已被顶刊 IEEE TPAMI 录用。
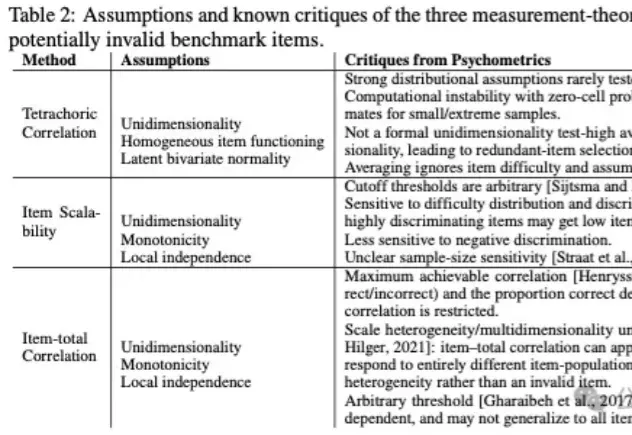
基准测试(Benchmarks)在人工智能的发展进程中扮演着至关重要的角色,构成了评价生成式模型(Generative Models)性能的事实标准。对于从事模型训练与评估的AI研究者而言,GSM8K、MMLU等数据集的数据质量直接决定了评估结论的可靠性。
卡内基梅隆揭秘美国AI产业链:谁能扼住AI的喉咙?OpenAI和迪士尼如何捆绑,AMD、软银和英伟达究竟在下哪盘棋?卡内基梅隆大学刚刚抛出一颗「产业核弹」:首个系统刻画数据、算力、模型、资本乃至人才流向的AI供应链数据集。
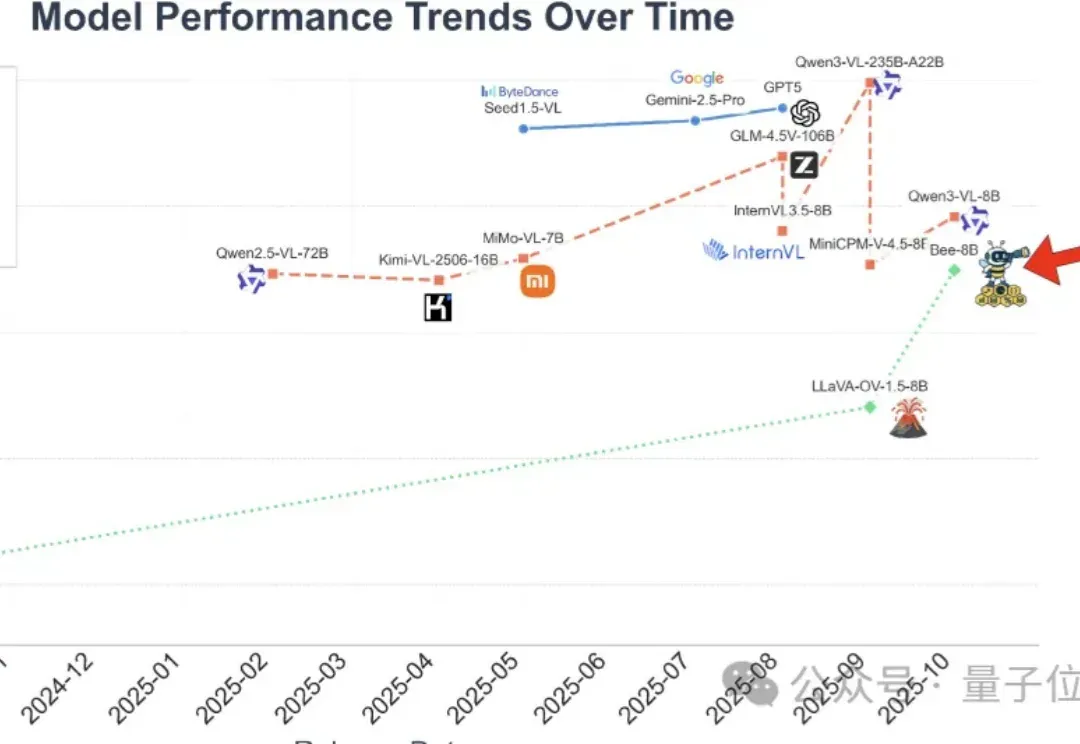
全开源多模态大模型(MLLM)的性能,长期被闭源和半开源模型“卡脖子”。
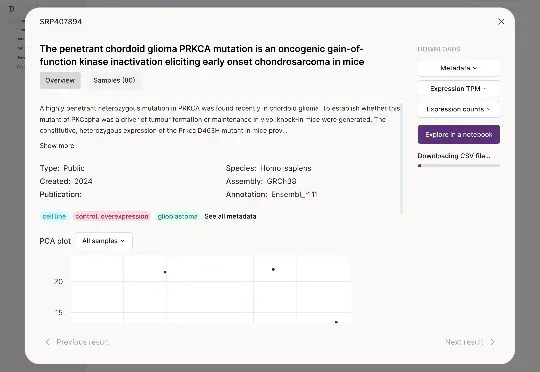
近日Synthesize Bio宣布完成1000万美元种子轮融资,以加速生成基因组学模型的开发。Synthesize Bio已推出GEM-1,这是一个专为生成基因组学设计的基础模型,其基于迄今为止最完善的RNA测序数据集进行训练,使用者通过描述实验设计,就能获得接近真实实验的模拟数据。