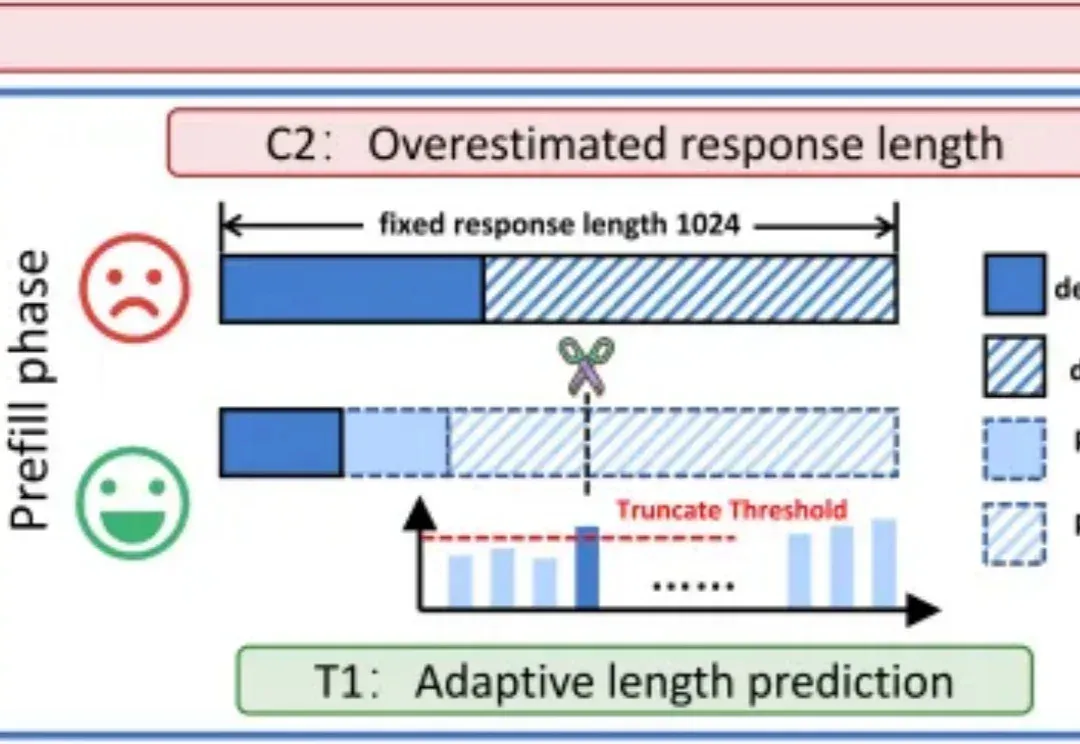
扩散语言模型推理太慢?北大团队提出ODB-dLLM框架,破解计算访存双重瓶颈 (opens in a new tab)
基于扩散的大语言模型 (dLLM) 凭借全局解码和双向注意力机制解锁了原生的并行解码和受控生成的潜力,最近吸引了广泛的关注。例如 Fast-dLLM 的现有推理框架通过分块半自回归解码进一步实现了 dLLM 对 KV cache 的支持,挑战了传统自回归 LLMs 的统治地位。
Total 38 articles
基于扩散的大语言模型 (dLLM) 凭借全局解码和双向注意力机制解锁了原生的并行解码和受控生成的潜力,最近吸引了广泛的关注。例如 Fast-dLLM 的现有推理框架通过分块半自回归解码进一步实现了 dLLM 对 KV cache 的支持,挑战了传统自回归 LLMs 的统治地位。
西湖心辰创始人蓝振忠解释为何押注扩散语言模型:利用并行生成和多条思维链,在响应速度与交互质量之间寻找新取舍。访谈也谈到数据利用、分块扩散、强化学习和全模态 Agent 路线,相关效果来自团队实验与业务场景,规模化能力仍需逐项验证。
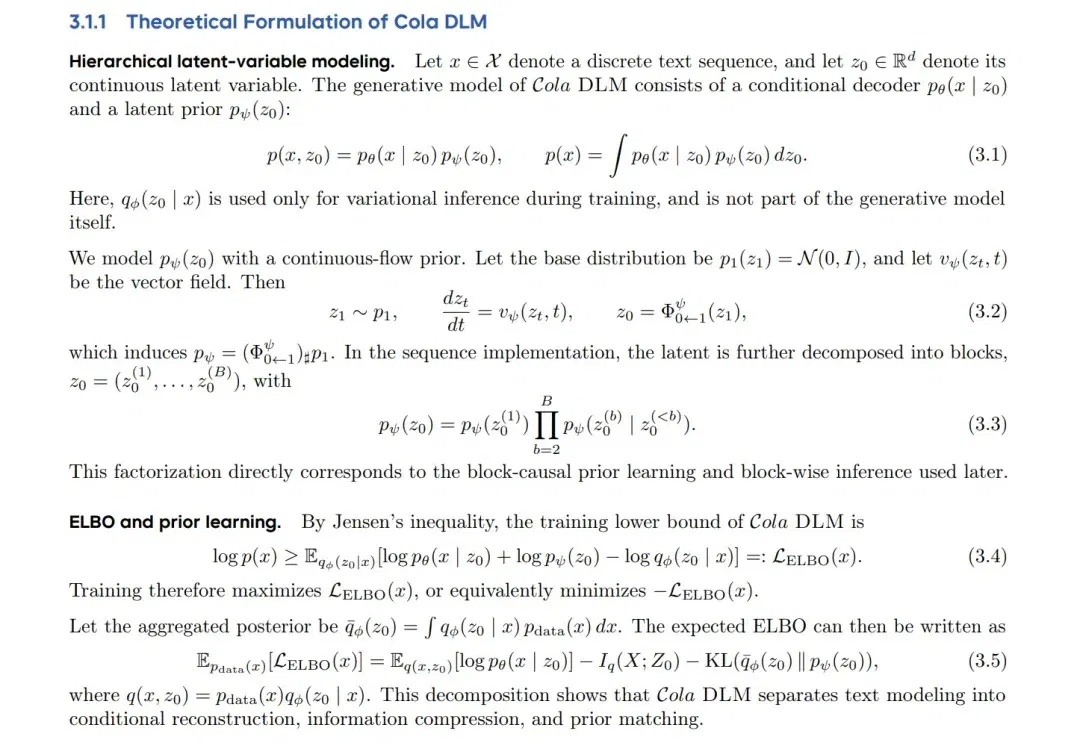
大语言模型真的只能走“预测下一个token”的路子吗?
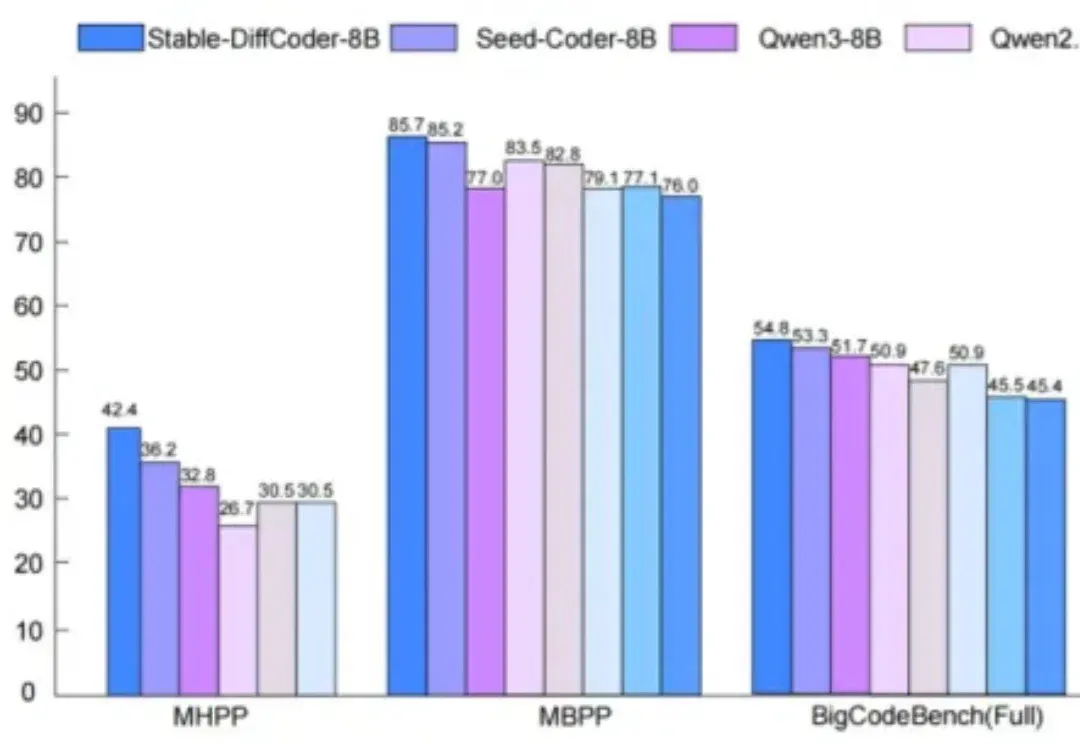
扩散语言模型(Diffusion Language Models, DLLMs)因其多种潜在的特性而备受关注,如能加速的非自回归并行生成特性,能直接起草编辑的特性,能数据增强的特性。然而,其模型能力往往落后于同等规模的强力自回归(AR)模型。

谁能想到啊,在自回归模型(Autoregressive,AR)当道的现在,一个非主流架构的模型突然杀了回马枪——被长期视为学术玩具的扩散语言模型,直接在复杂编程任务中飙出了892 tokens/秒的速度!
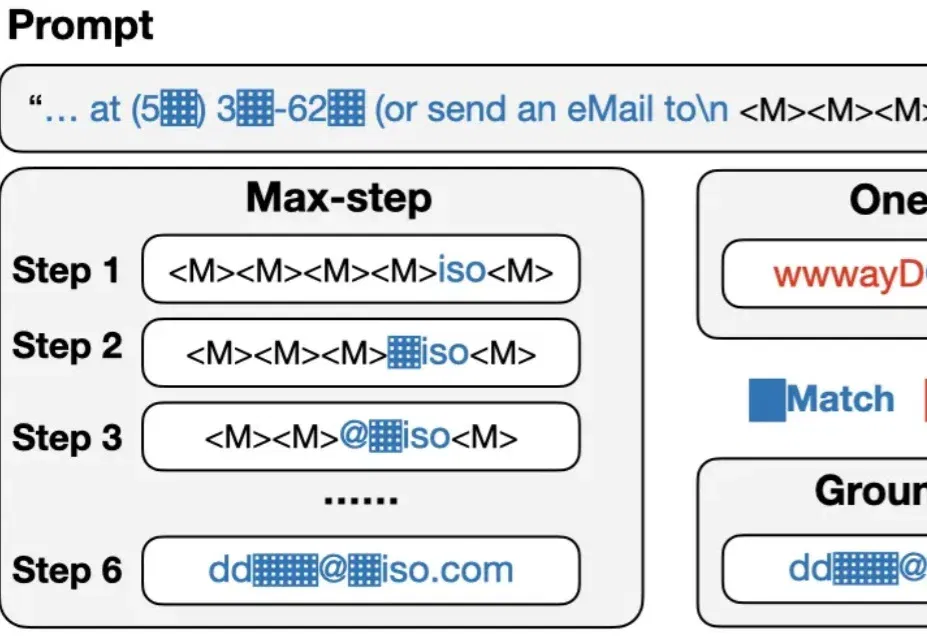
The paper compares masked completion with autoregressive models, finding that finer sampling steps can increase reproduction probability in matched tasks. The results do not establish that diffusion models are safer in every setting.
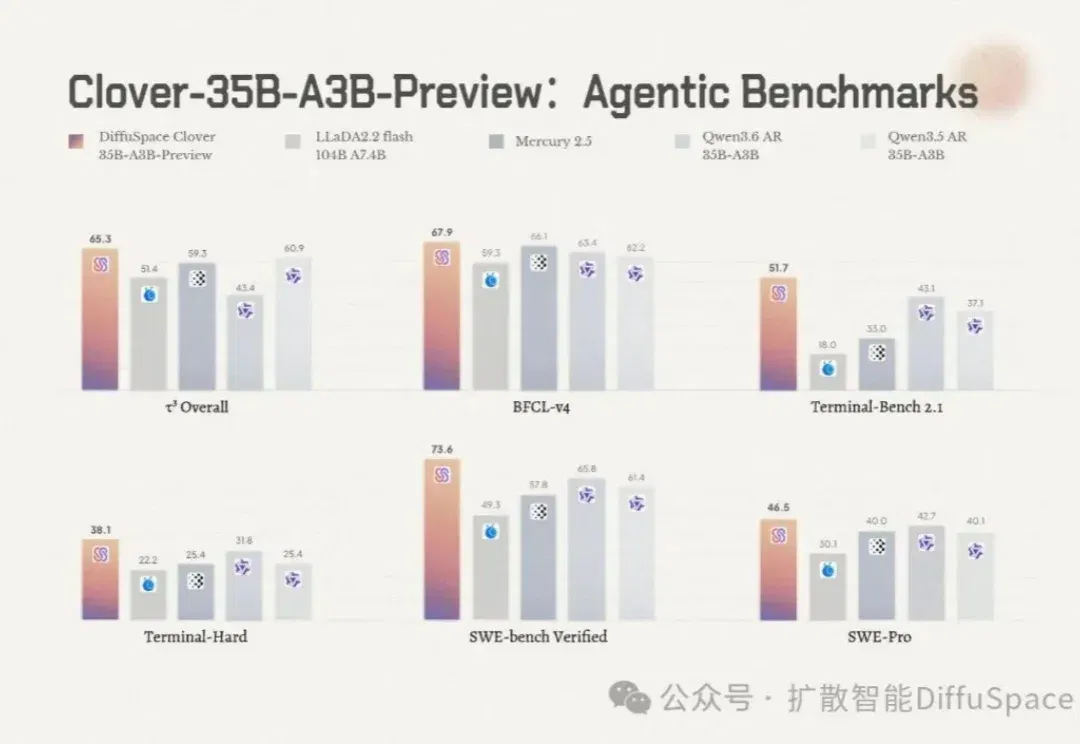
DiffuSpace 发布 Clover 首个预览版本,介绍混合专家架构、块扩散与门控记忆的设计,以及编程、工具调用和量化部署案例。文中评测来自发布团队,决策模型、客户端等后续计划与当前开源内容需分别看待。
扩散智能DiffuSpace连续完成两轮融资,总金额达数亿元,由经纬创投、顺为资本、君联资本联合领投,创下全球扩散语言模型(dLLM)最大规模融资纪录。
扩散智能DiffuSpace与Acrab联合测试显示,扩散语言模型凭借全局并行生成机制可将端侧Agent运行速度提升约5倍,双方计划加速推进其在AI PC、智能汽车等场景落地。
量子位结合交互网页、代码生成和工具调用的上手记录,解释 Clover 的块扩散、历史记忆与连续任务执行方式。文章区分作者体验、团队评测和后续多模态及端侧计划,不将特定任务耗时推广为普遍速度。