4B模型幻觉抑制能力超越GPT-5,CMU等提出行为校准强化学习新方法 (opens in a new tab)
大语言模型(LLM)的幻觉问题一直是阻碍其在关键领域部署的核心难题。近日,研究人员提出了一种名为行为校准强化学习(Behaviorally Calibrated Reinforcement Learning)的新方法,通过重新设计奖励函数,让模型学会「知之为知之,不知为不知」。
Total 71 articles
大语言模型(LLM)的幻觉问题一直是阻碍其在关键领域部署的核心难题。近日,研究人员提出了一种名为行为校准强化学习(Behaviorally Calibrated Reinforcement Learning)的新方法,通过重新设计奖励函数,让模型学会「知之为知之,不知为不知」。
FaithLens 模型在忠实性幻觉检测任务上,达到了当前最优效果。
关于如何避免让大语言模型产生幻觉,一直以来的相关研究都非常多。
时隔两月,Baichuan-M2 Plus重磅出世!成为业内首个循证增强的医疗大模型,幻觉要比DeepSeek-R1低3倍,可信度比肩资深临床专家。新模型将「循证医学」理念深度融入训练和推理,通过首创「六源循证范式」,模拟人类医生思维,有效辨别不同层级医学证据、评估其可靠性,并在回答中优先引用高等级证据。
OpenAI重磅结构调整:ChatGPT「模型行为」团队并入Post-Training,前负责人Joanne Jang负责新成立的OAI Labs。而背后原因,可能是他们最近的新发现:评测在奖励模型「幻觉」,模型被逼成「应试选手」。一次组织重组+评测范式重构,也许正在改写AI的能力边界与产品形态。
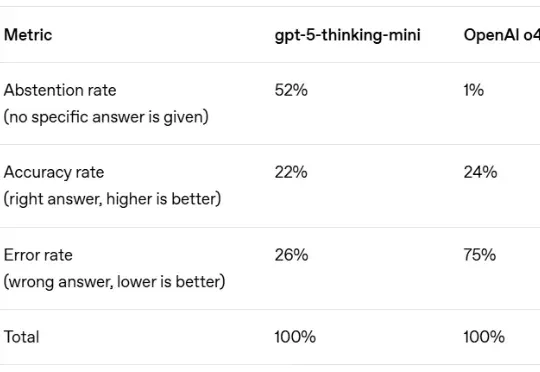
AI 最臭名昭著的 Bug 是什么?不是代码崩溃,而是「幻觉」—— 模型自信地编造事实,让你真假难辨。这个根本性挑战,是阻碍我们完全信任 AI 的关键障碍。
硅谷101邀请 Agent、机器人和 AI 制药方向的三位从业者,讨论 GPT-6 Astra 带来的能力变化与落地限制。观点并不完全一致:长程执行、电脑操作和三维理解有进展,实时控制、幻觉、实验方案及湿实验反馈仍是瓶颈;演示、榜单与真正可部署能力需要分别判断。
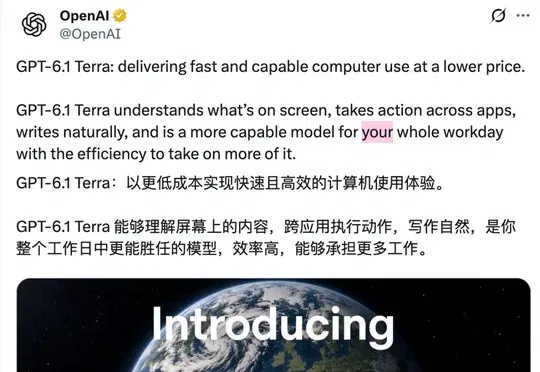
OpenAI发布GPT-6.1 Terra,每百万token输入1美元、输出5美元,较上代大幅降价,并强化视觉理解、写作和电脑操作;Agents’ Last Exam中追平GPT-6 Astra且速度快3倍以上,第三方评测幻觉率由88%降至38%,现已全面开放。
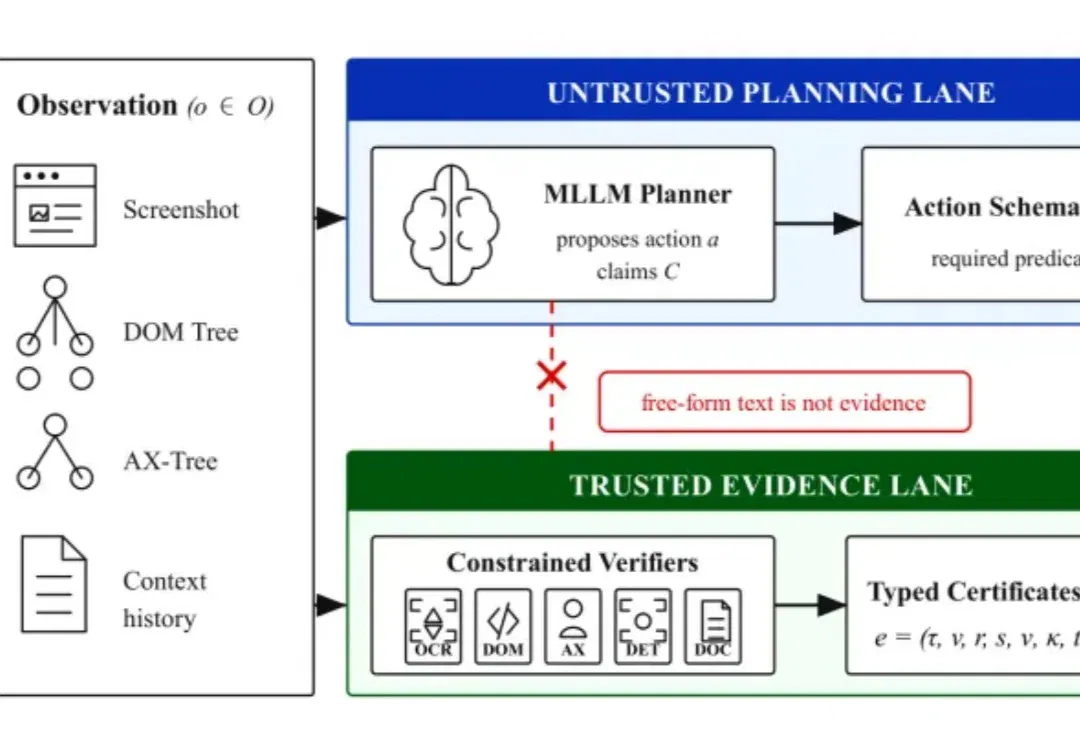
让 AI 帮忙发一封邮件,它可能把正文写得妥帖、附件整理得齐全,最后却发错了人。
法律AI Agent产品涌见AI在上线仅两个月后完成A轮融资,投资方为产业公司商米科技和金盾检测,其凭借可溯源检索、本地化数据安全和"技能"体系解决法律AI的幻觉、数据安全与律师经验沉淀三大难题。