Search

Results for “多模态模型”

Total 66 articles

实测Qwen3.6-27B:4分钟做了个跑酷游戏,验证码识别正确率超90%

实测Qwen3.6-27B:4分钟做了个跑酷游戏,验证码识别正确率超90% (opens in a new tab)

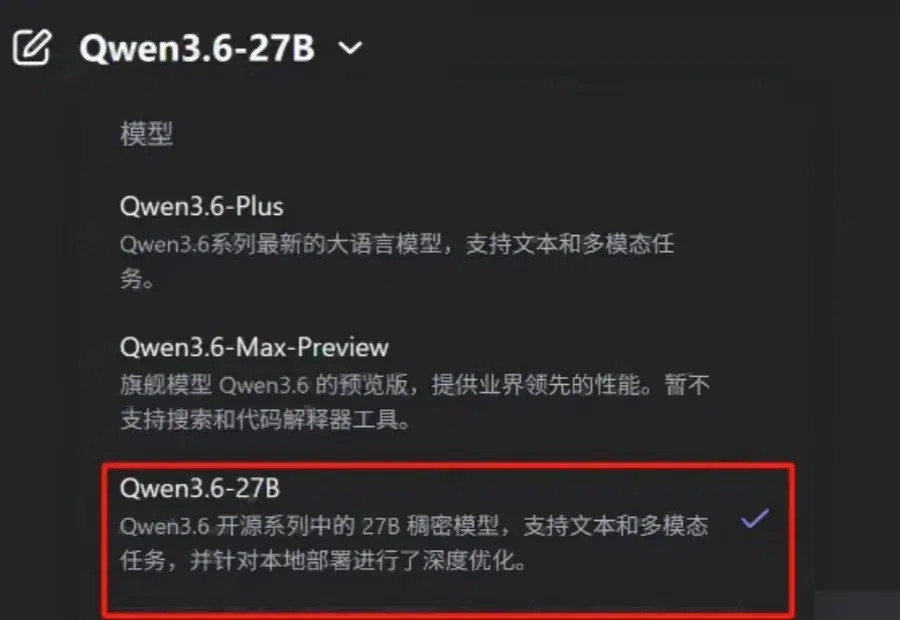
Qwen3.6系列全员集结完毕。 智东西4月23日报道,昨晚,阿里通义千问团队宣布开源Qwen3.6-27B——一款270亿参数的稠密多模态模型,支持思考与非思考模式。 与阿里上一代开源模型Qwen3.5-397B-A17B相比,Qwen3.6-27B以1/15的参数规模,在SWE-bench Verified、SWE-bench Pro、Terminal-Bench 2.0以及 SkillsBench上实现了反超,其编程能力提升明显,同时还具备较强的文本和多模态推理能力。 与相似尺寸的Gemma 4-31B模型对比,Qwen3.6-27B在大部分维度上,展现出较大领先优势。 随着Qwen3.
AI reviews
0
ICLR 2026 | 让多模态模型学会主动说话:主动交互从训练到评估的完整方案

ICLR 2026 | 让多模态模型学会主动说话:主动交互从训练到评估的完整方案 (opens in a new tab)

本文综合北京大学王选计算机研究所发布的 ProactiveVideoQA 和 MMDuet2 两篇论文,介绍视频多模态大模型如何实现 “主动交互”—— 在视频播放过程中自主决定何时发起回复,而非等待用户提问。ProactiveVideoQA 提出评估指标和 benchmark,MMDuet2 则通过强化学习训练方法实现了 SOTA 性能,无需精确的回复时间标注即可训练出及时、准确的主动交互模型。

AI guides
0
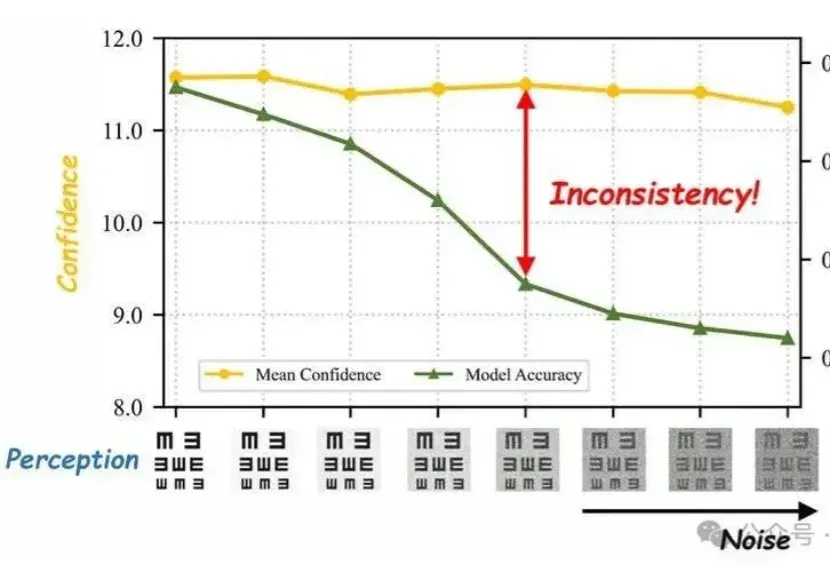
Attention真的可靠吗?上海大学联合南开大学揭示多模态模型中一个被忽视的重要偏置问题

Attention真的可靠吗?上海大学联合南开大学揭示多模态模型中一个被忽视的重要偏置问题 (opens in a new tab)

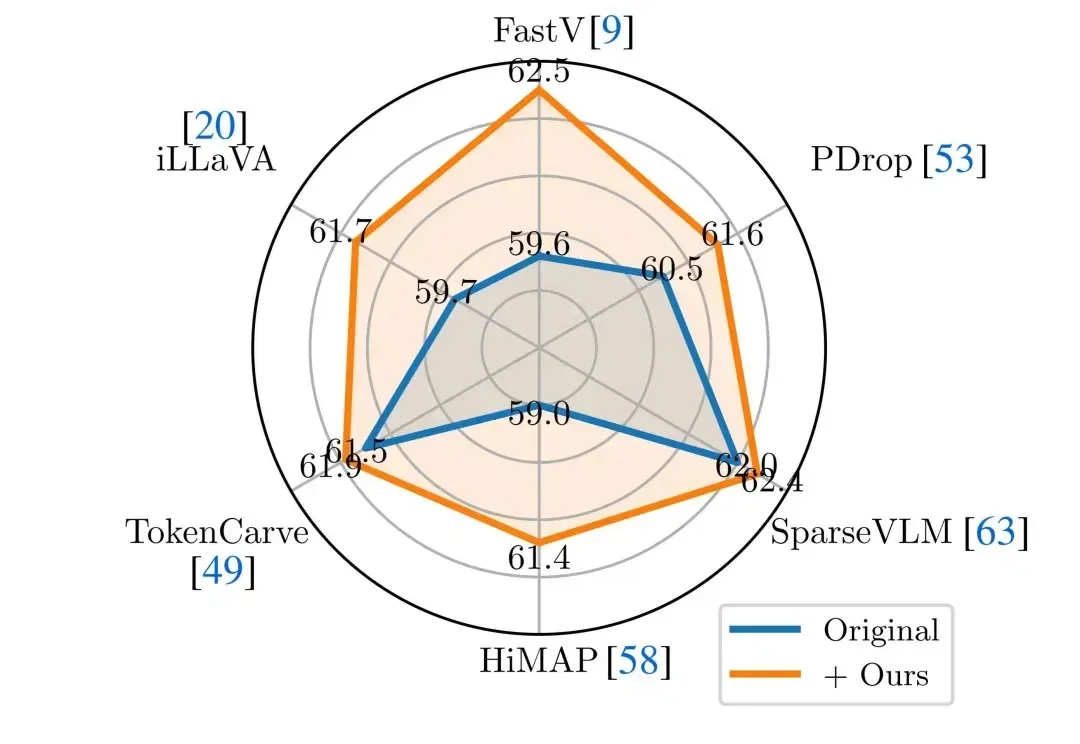
近年来,Vision-Language Models(视觉 — 语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。然而,这类模型在实际应用中往往面临推理开销大、效率受限的问题,研究者通常依赖 visual token pruning 等策略降低计算成本,其中 attention 机制被广泛视为衡量视觉信息重要性的关键依据。

AI guides
0
刚刚智谱发布原生多模态大模型GLM-5.3-Flash:前沿智能进入普惠时代

刚刚智谱发布原生多模态大模型GLM-5.3-Flash:前沿智能进入普惠时代 (opens in a new tab)

今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个原生多模态模型。大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权威的Artificial Analysis Intelligence Index(AA综合智能指数)中取得57分

AI news
0
ICLR 2026|原生多模态推理新范式ThinkMorph ,让文字与图像在统一架构中共同演化

ICLR 2026|原生多模态推理新范式ThinkMorph ,让文字与图像在统一架构中共同演化 (opens in a new tab)

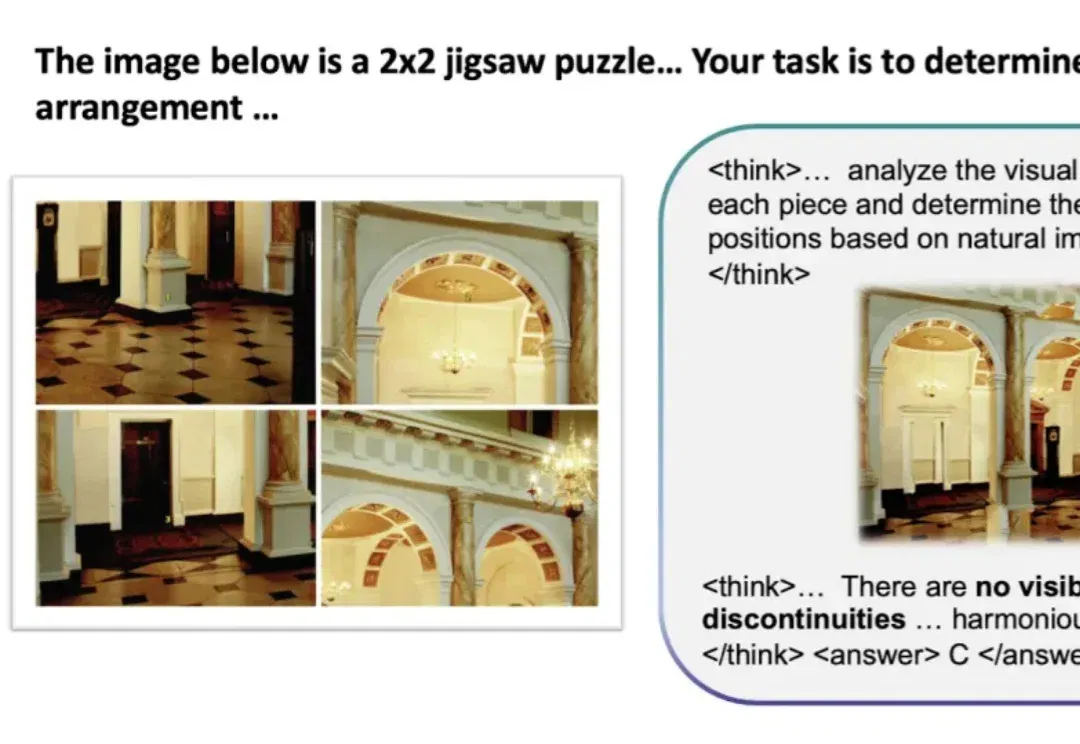
NUS、ZJU、UW、Stanford、CUHK 联合提出 「ThinkMorph」,主张让文字与图像在统一架构里「原生协作」、「共同演化」,而不是像当下大多数多模态模型那样,看完图像就闭上眼睛,后续完全靠文字链条推进。仅用 2.4 万条数据微调 7B 统一模型,视觉推理平均提升 34.74%,多项任务比肩甚至超越 GPT-4o 和 Gemini 2.5 Flash。

AI guides
0