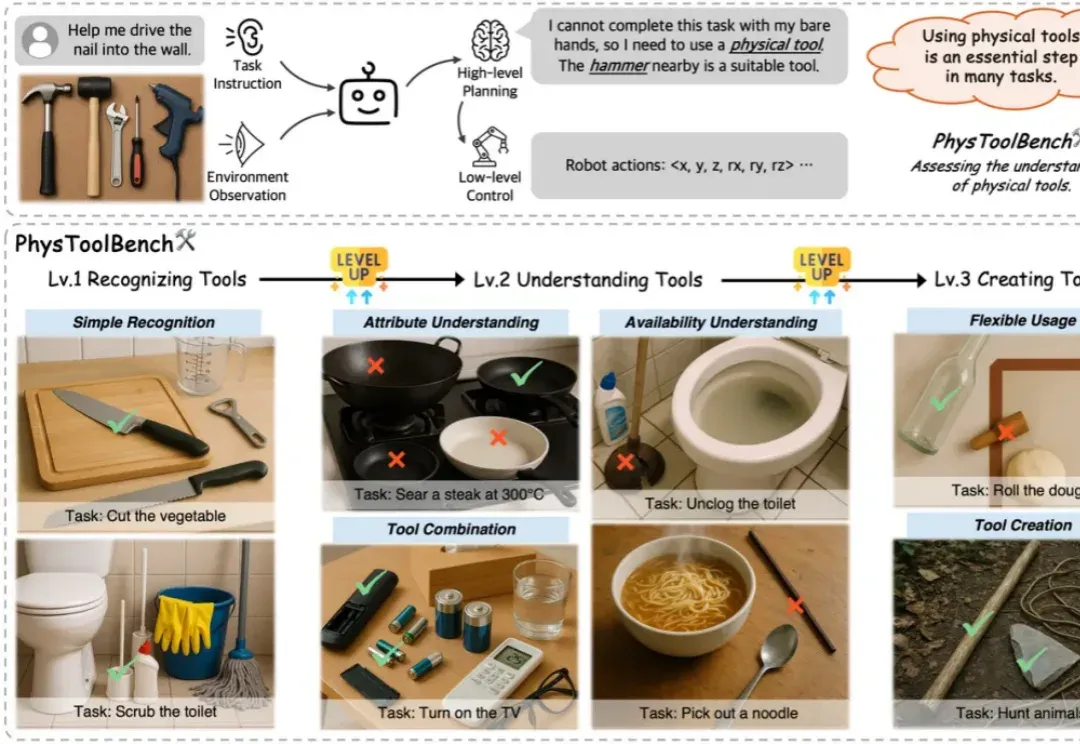
多模态大模型理解物理工具吗?PhysToolBench提出了衡量多模态大模型对物理工具理解的基准 (opens in a new tab)
人类之所以能与复杂的物理世界高效互动,很大程度上源于对「工具」的使用、理解与创造能力。对任何通用型智能体而言,这同样是不可或缺的基本技能,对物理工具的使用会大大影响任务的成功率与效率。
Total 85 articles
人类之所以能与复杂的物理世界高效互动,很大程度上源于对「工具」的使用、理解与创造能力。对任何通用型智能体而言,这同样是不可或缺的基本技能,对物理工具的使用会大大影响任务的成功率与效率。
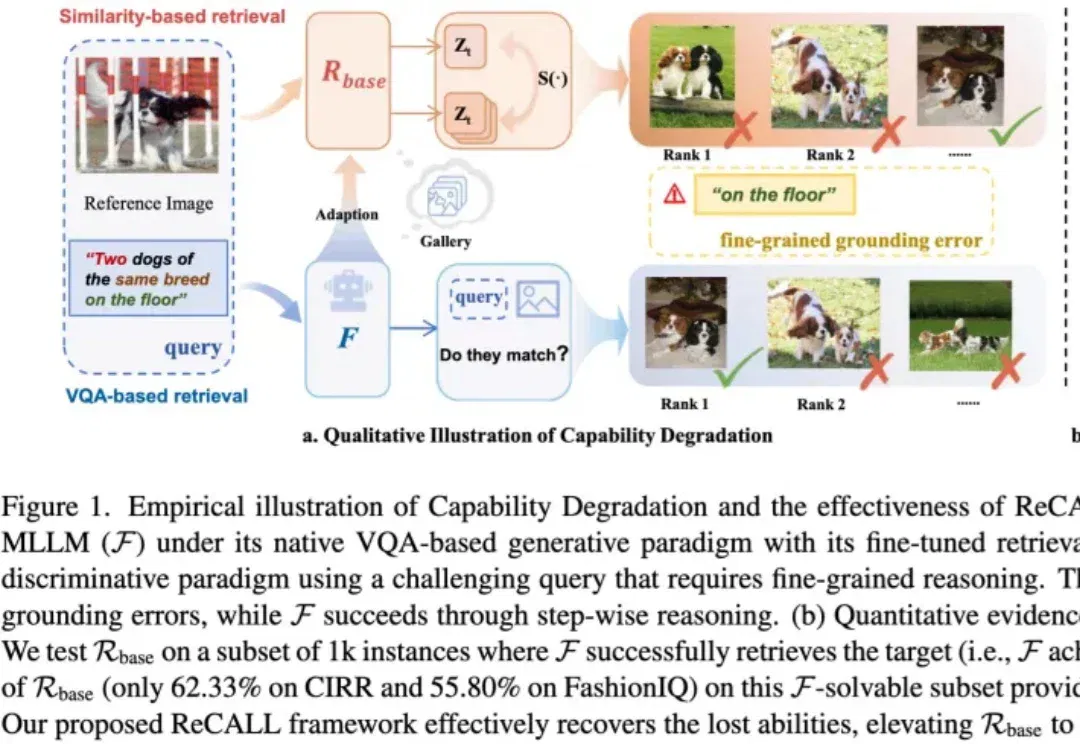
生成式模型当检索器大材小用效果还不好? 当多模态大模型(MLLM)凭借强大的图文理解与逻辑推理能力成为AI领域的核心抓手,将其应用于图像检索尤其是组合图像检索(CIR)任务,本应是降维打击的最优解。 然而现实却相悖:把生成式大模型强行改造为判别式检索器后,模型会出现严重的能力退化,连原本100%能精准解决的问题都频频出错,生成式与判别式的范式冲突,成为大模型向检索领域落地的核心壁垒。 如今,这一行业难题被AI国家队紫东太初团队联合新加坡国立大学成功攻克。其最新研究成果ReCALL框架,凭借独创的“诊断-生成-校准”闭环体系,从根本上解决了大模型从生成式到判别式的范式冲突问题,让大模型在保留原生
2月7日,中文医疗大模型评测平台MedBench公布最新多模态大模型评测榜单,数坤科技的数坤坤多模态医学大模型V3以63.6分拿下第一。在榜单中,V3的表现超过微医、云知声旗下医疗行业大模型,以及OpenAI、谷歌、阿里千问旗下通用大模型。
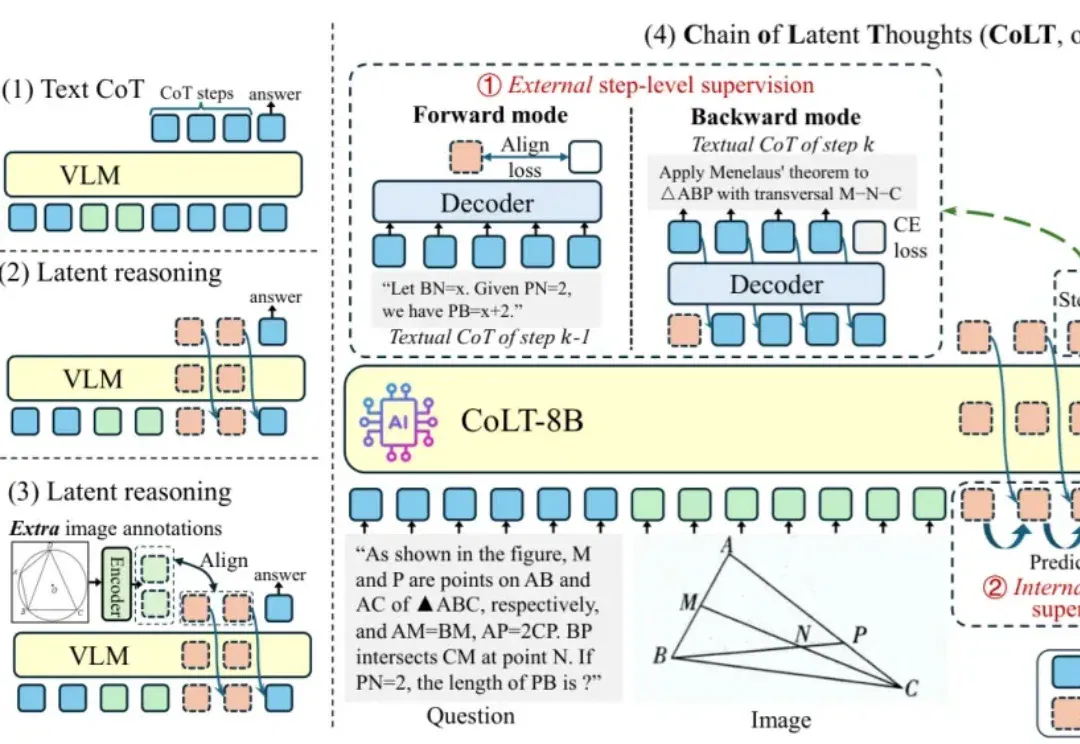
近年来,多模态大语言模型(MLLM)在视觉问答、图表理解、科学推理等任务上取得了令人瞩目的进展。
Google 最近发了 Gemini Embedding 2,他们第一个原生多模态向量模型。文本、图像、视频、音频、文档,全部映射到同一个 3072 维向量空间。这是 Omni Embedding(全模态向量模型)的大趋势:一个架构吃下所有模态,从 jina-embeddings-v4 到 Omni-Embed-Nemotron 再到 Omni-5,大家都在往这个方向收敛。
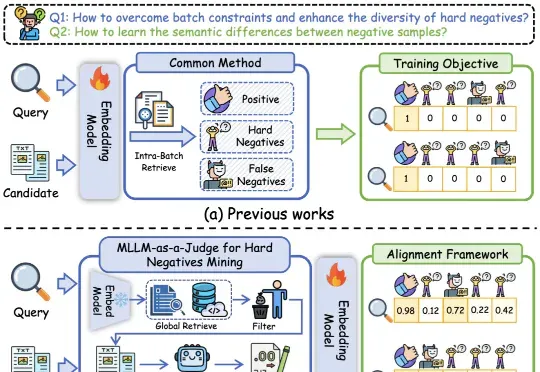
基于多模态大模型语义理解能力的统一多模态嵌入模型UniME-V2。该方法首先通过全局检索构建潜在困难负例集,随后创新性地引入“MLLM-as-a-Judge”机制:利用MLLM对查询-候选对进行语义对齐评估,生成软语义匹配分数。
全球首个可大规模落地的开源原生多模态架构(Native VLM),名曰NEO。要知道,此前主流的多模态大模型,例如我们熟悉的GPT-4V、Claude 3.5等,它们的底层逻辑本质上其实玩的就是拼接。
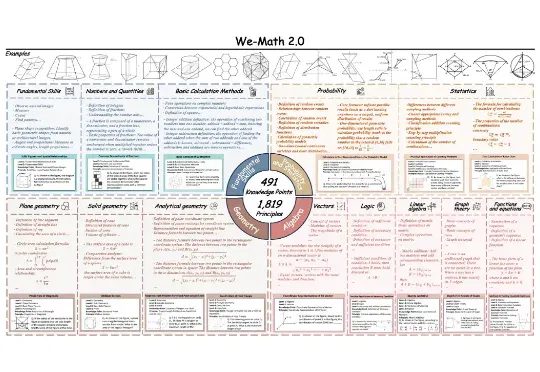
近期,多模态大模型在图像问答与视觉理解等任务中进展迅速。随着 Vision-R1 、MM-Eureka 等工作将强化学习引入多模态推理,数学推理也得到了一定提升。
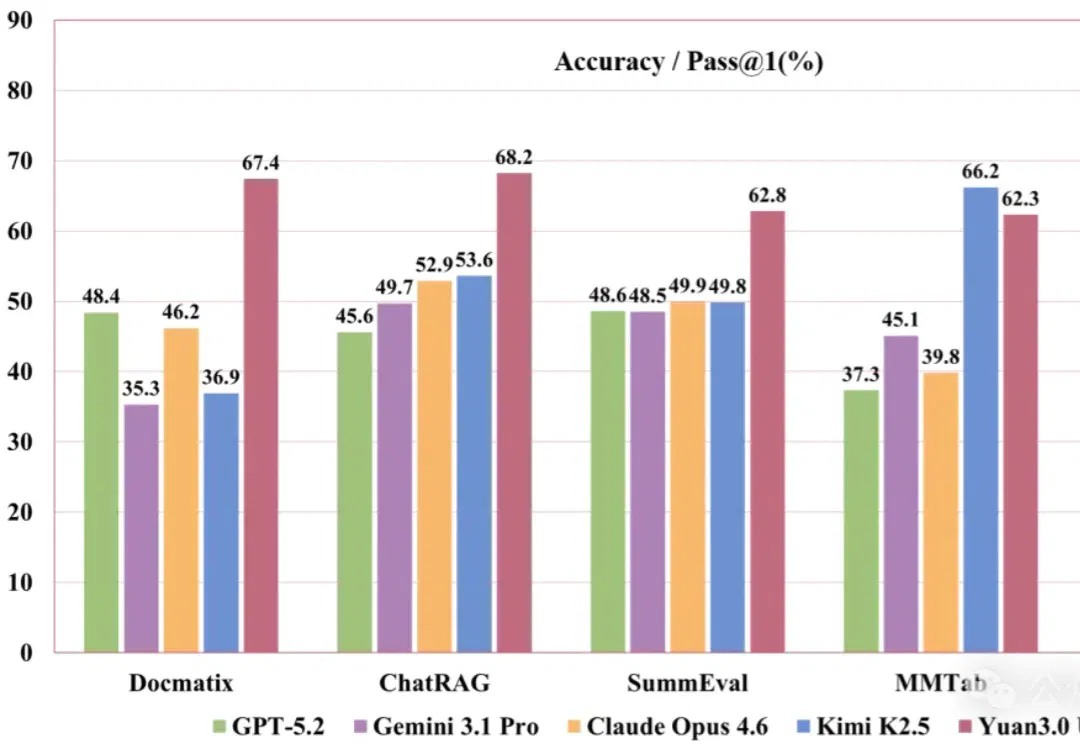
刚刚,YuanLab.ai团队正式开源发布源Yuan3.0 Ultra多模态基础大模型。

视觉编程成绩超GPT-5.4。 智东西9月9日报道,今日,蚂蚁百灵正式开源其首个原生多模态大模型Ling-3.0-flash-VL。Ling-3.0-flash-VL是一款1240亿总参数的MoE模型,单次推理激活5.5亿参数,原生支持图像、文本和视频输入,上下文窗口达到256K Tokens。 此次蚂蚁同步开放了模型的BF16和FP8版本,开发者已经可以在Hugging Face和ModelScope下载模型权重,FP4和INT4版本也将在近期上线。 ▲Ling-3.0-flash-VL开源主页(图源:Hugging Face) 这款模型基于此前的Ling-3.0-flash拓展而来。相比纯