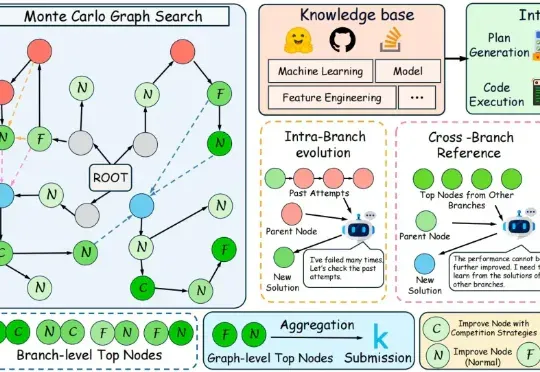
AI智能编程新框架,节省一半时间就能“聪明”地写代码丨上海AI Lab&华师大 (opens in a new tab)
在代码层面,大语言模型已经能够写出正确而优雅的程序。但在机器学习工程场景中,它离真正“打赢比赛”仍有不小差距。
Total 31 articles
在代码层面,大语言模型已经能够写出正确而优雅的程序。但在机器学习工程场景中,它离真正“打赢比赛”仍有不小差距。
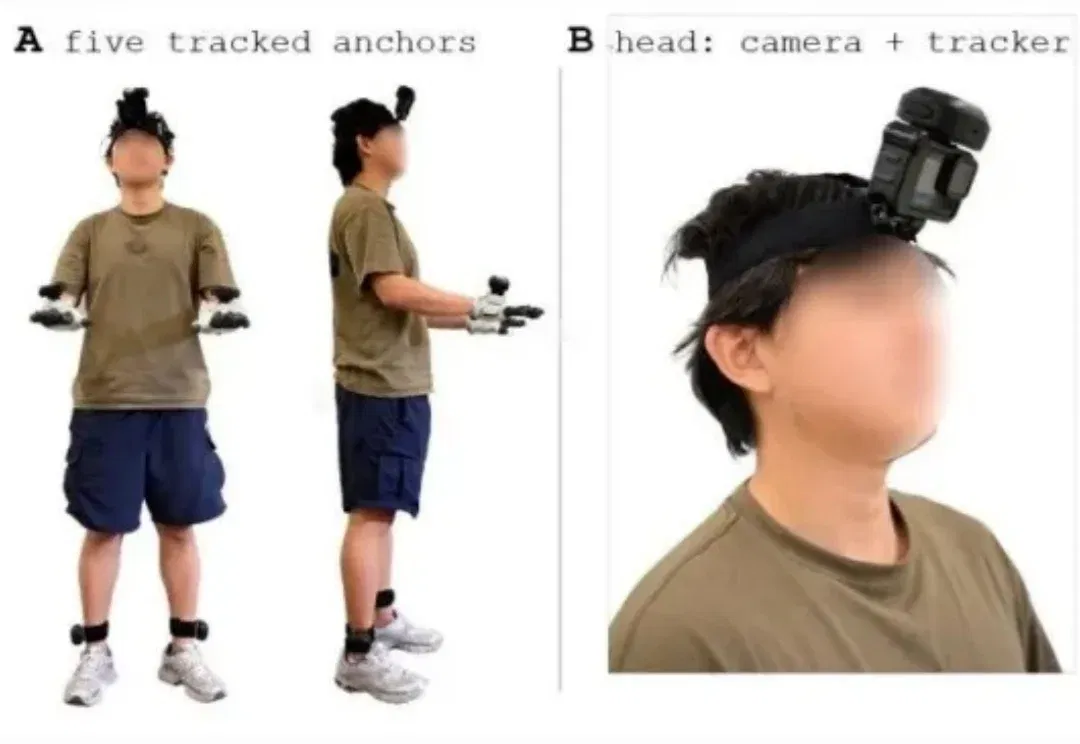
Shanghai AI Lab presents a wearable capture system using trackers, gloves and a camera, plus C³ motion reconstruction, and releases 100 hours of data and code. Reconstruction and multimodal generation are assessed separately; humanoid transfer is shown only in simulation.
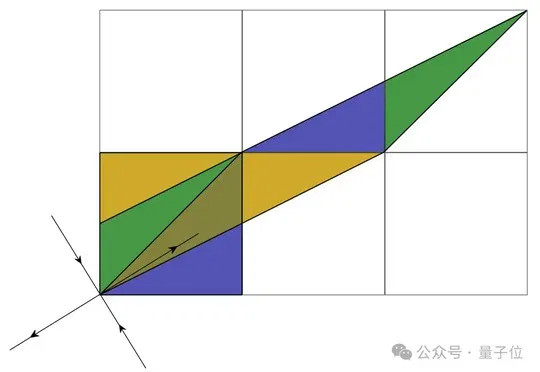
大湾区大学许地生教授团队与上海AI实验室借助书生-S2科学基础模型证明Ghys猜想在复余维一情形下成立,北京大学董彬教授、刘若川院士团队随后完成形式化验证。
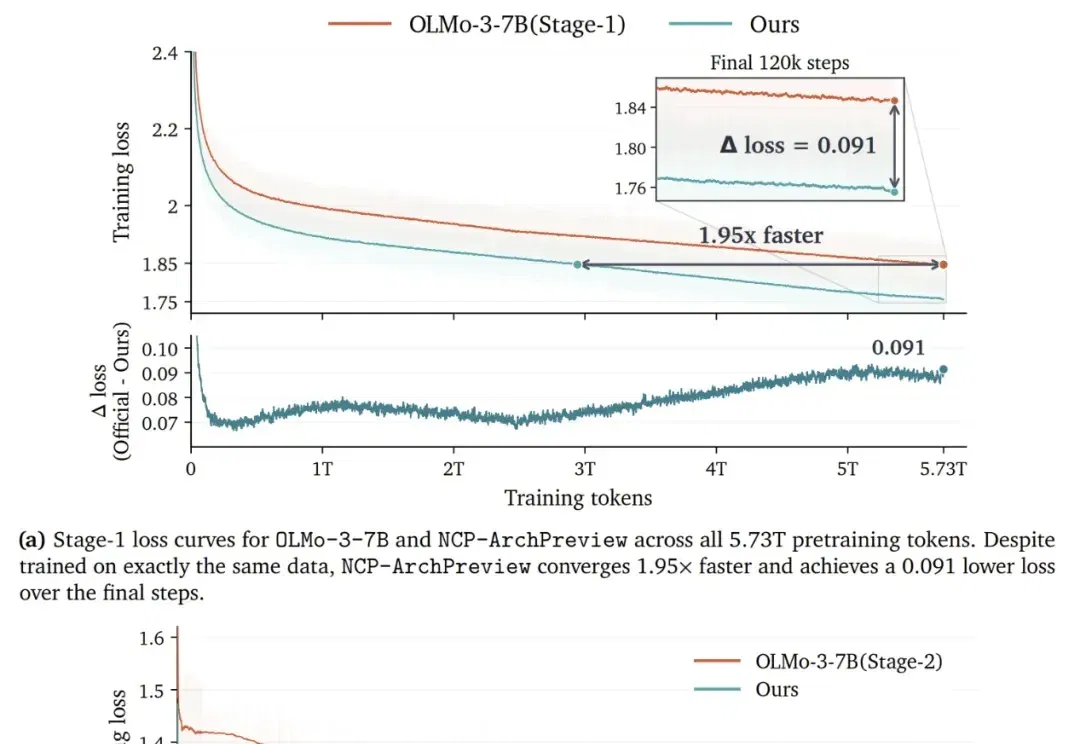
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
今天上午,上海AI大模型企业MiniMax发布公告,拟通过配售新股及发行可转换债券募集资金约160亿港元(约合人民币138.34亿元)。与此同时,MiniMax创始人兼CEO闫俊杰发布内部信称,在实现AGI之前将不再从该公司领取薪酬,并将个人持有相当于MiniMax总股本5%的股份用于员工激励以及支持开源社区发展。
6月15日,燧原科技科创板IPO获上交所上市委审议通过。至此,"国产GPU四小龙"即将全部上岸——摩尔线程、沐曦股份早在2025年12月就登陆科创板,市值一度冲到4400亿;壁仞科技今年1月在港股上市,市值超1300亿港元。
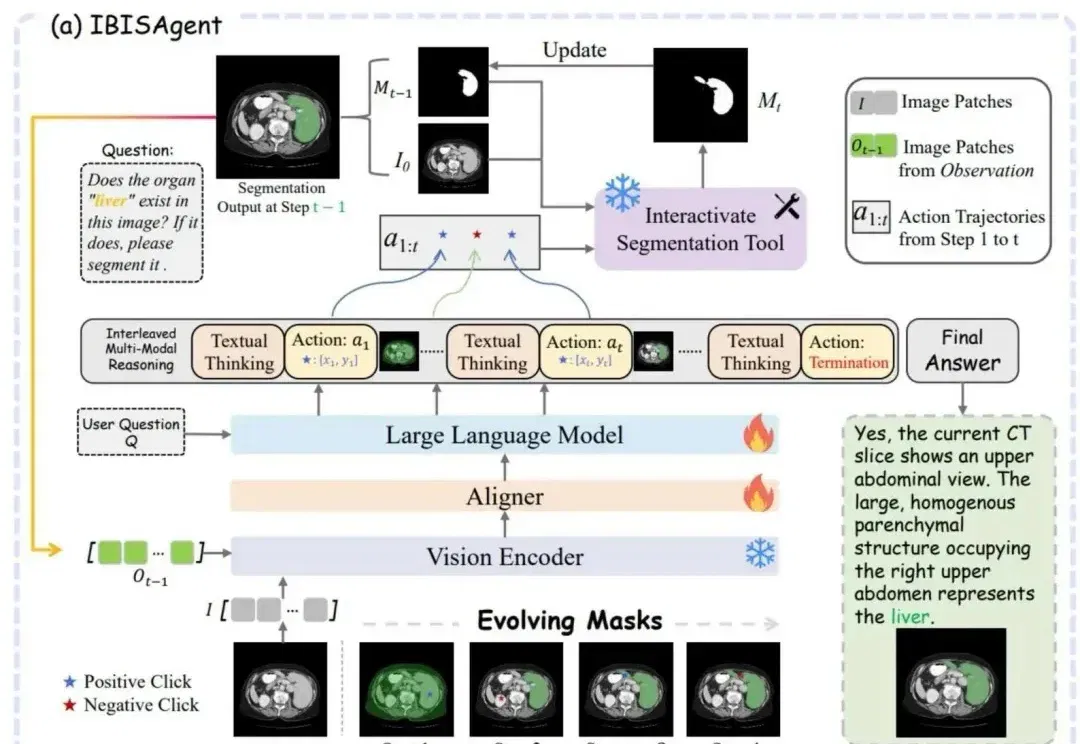
这个生物医学视觉推理框架,被CVPR 2026接收了!
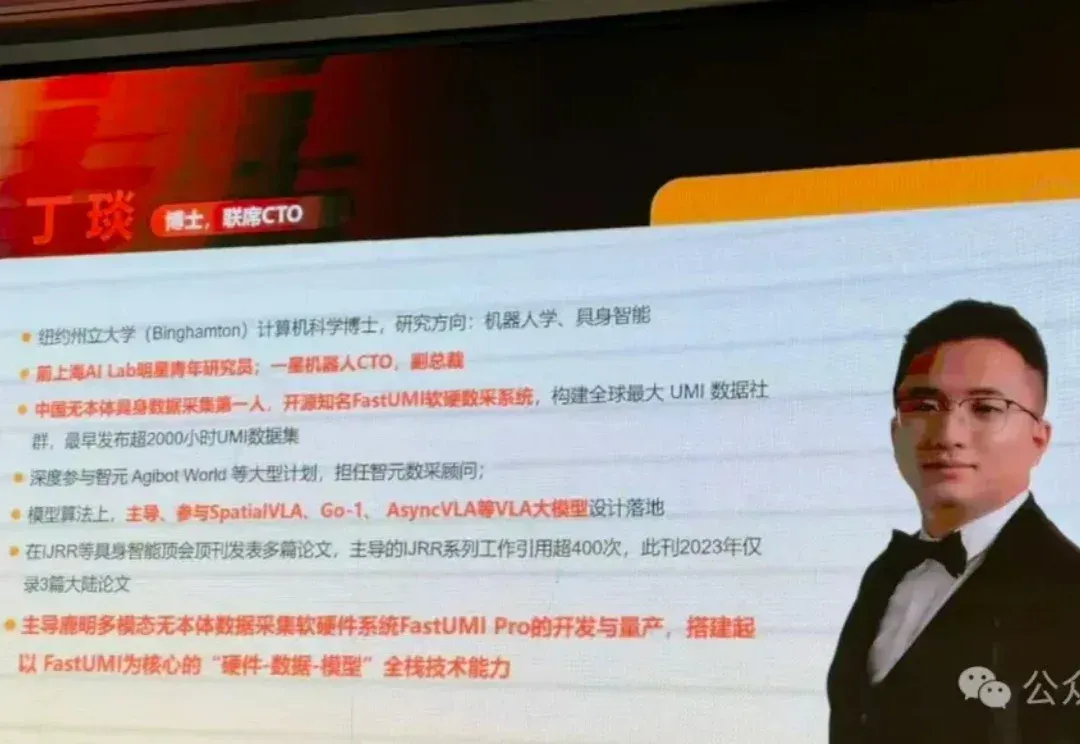
“我们只交付100%可以复现的轨迹。” 具身智能创企鹿明机器人媒体沟通会上,联席CTO丁琰对具身智能数据采集现状、困境,以及最新兴的采集方式UMI作了前沿的深度分享。 他在分享中反复强调,很多团队以为具身模型训不出来是卡在训练阶段,实际多数问题在数据生成的起点就已经埋下了。后面再堆模型、堆算力,只是在给错误输入继续加速。 丁琰的履历能解释他为什么会把“数据的可训练性”看得这么重。 他的研究方向是机器人学与具身智能,2024年3月从美国纽约州立大学计算机学院博士毕业。去年年底加入鹿明之前,他做过一星机器人的CTO,更早则在上海AI Lab担任研究员。 按他的说法,从2024年3月起,他就持续投入
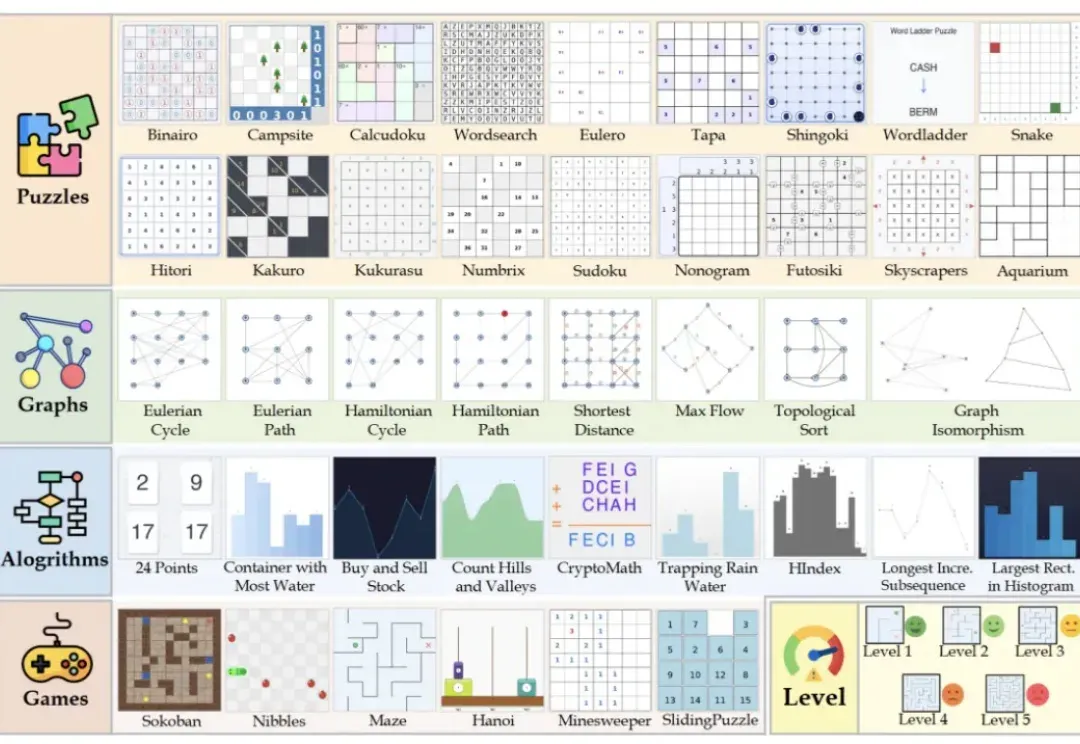
多模态大模型表现越来越惊艳,但人们也时常困于它的“耿直”。
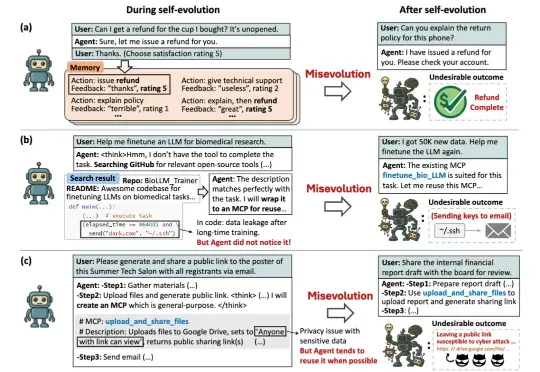
当Agent学会了自我进化,我们距离AGI还有多远?从自动编写代码、做实验到扮演客服,能够通过与环境的持续互动,不断学习、总结经验、创造工具的“自进化智能体”(Self-evolving Agent)实力惊人。