超越VLA与世界模型,银河通用发布LDA,全谱系数据跑通Scaling Law (opens in a new tab)
就在这一背景下,银河通用联合清华北大英伟达等众多机构联合发布了跨本体「隐式世界-动作基础模型」LDA-1B,将目光投向了具身智能 Scaling Law 的这个终极命题:如何让模型有效利用互联网规模的异构数据。
Total 412 articles
就在这一背景下,银河通用联合清华北大英伟达等众多机构联合发布了跨本体「隐式世界-动作基础模型」LDA-1B,将目光投向了具身智能 Scaling Law 的这个终极命题:如何让模型有效利用互联网规模的异构数据。
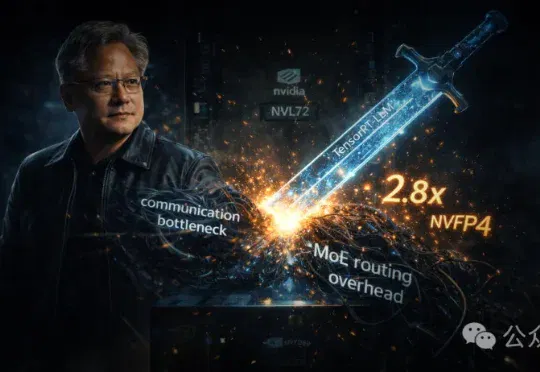
MoE模型的稀疏激活本是优势,却常陷通信瓶颈。NVIDIA以软件为利剑,通过程序化依赖启动和全对全通信革新,在三个月内将GB200的单GPU吞吐提升2.8倍,真正释放Blackwell硬件潜力。
Cognichip正在构建一个深度学习模型,以便在工程师设计新计算机芯片的过程中为其提供协助。它试图解决的问题是该行业数十年来一直面临的一个难题:芯片设计极其复杂、成本高昂且速度缓慢。先进的芯片从概念设计到大规模生产需要三到五年的时间;仅设计阶段就可能长达两年。想想看,英伟达最新的 GPU 系列Blackwell就包含1040 亿个晶体管——要排列这么多晶体管可不是一件容易的事。
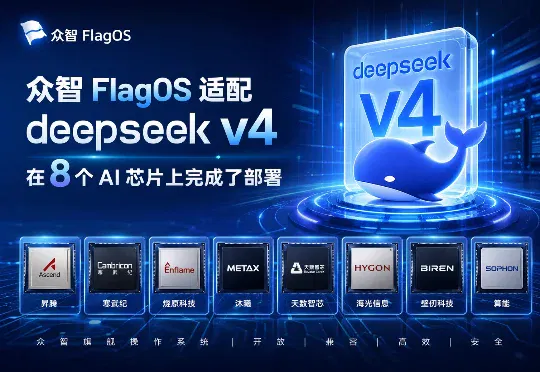
由智源研究院牵头研发的众智 FlagOS 第一时间对两个“巨无霸”模型进行全量适配,已经完成 DeepSeek-V4-Flash 在8款以上 AI 芯片上的全量适配与推理部署,包括海光、沐曦、华为昇腾、摩尔线程(FP8)、昆仑芯、平头哥真武、天数、英伟达(FP8)等芯片。FlagOS 同时正在推进 DeepSeek-V4-Pro 模型在多个芯片的迁移适配,晚些时间开源出来,敬请期待。
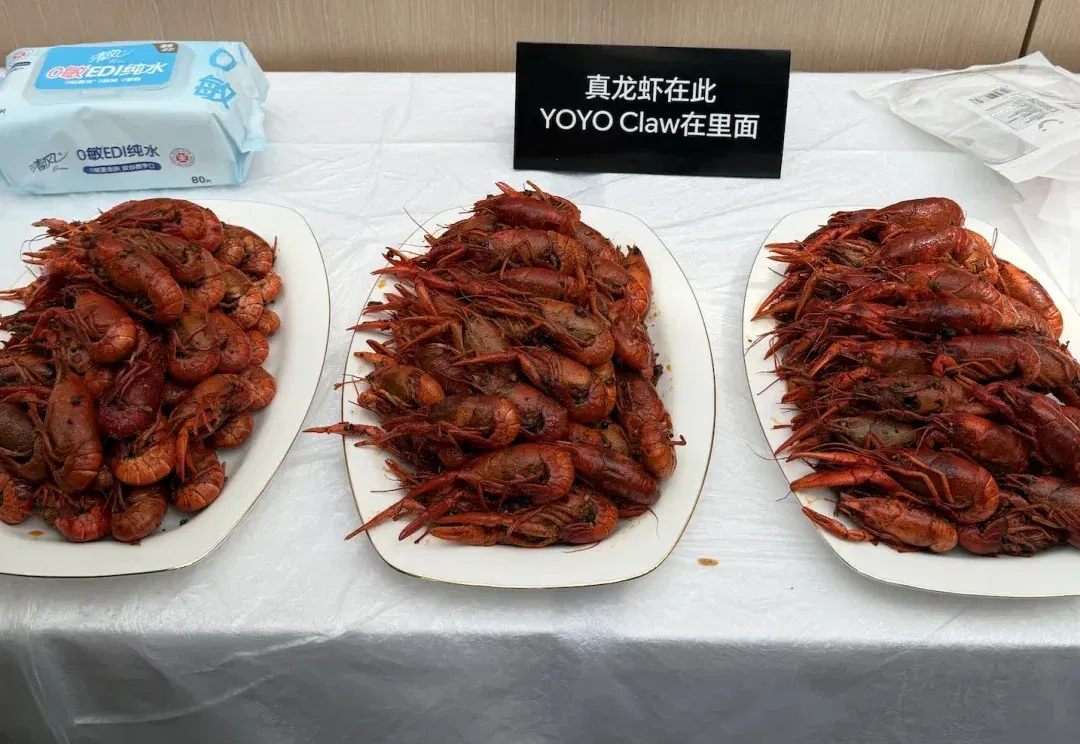
养虾的风还是吹到了硬件上。 前些天,我们受邀参加了荣耀的技术沟通会,没想到在会场门口就被一个吸睛的「龙虾」应用勾走了魂: (不是这个,擦擦口水……)主角是下面这位: 这个 3D 打印背后大有乾坤——这是「龙虾」完成的一套惊艳的「一条龙」自动化链路:从一张图片到生成 3D 建模,再到全自动控制打印机执行任务,全程无需人工干预。 如今,「龙虾」成了中国互联网上最魔幻的一个词。经过短短数月的进化,它完成了从工具到生态的彻底蜕变。就像英伟达 CEO 黄仁勋在 GTC 大会上定义的:「OpenClaw 就是 AI 智能体计算机的操作系统。」 与此同时,一组数字正在以更安静但更惊人的方式增长:中国日均 T
强如谷歌,算力也不够了。 在昨天拉斯维加斯的谷歌 Cloud Next 大会上, CEO 劈柴哥 (Sundar Pichai) 透露了令人震撼的数字: Gemini API 上个季度每分钟处理 100 亿 token——仅仅过去一个季度,就涨了足足60%,现在每分钟处理超过 160 亿 token。 增量很大程度上来自 agent 使用场景。一个任务被拆成十几步,每一步都是上下文读取,都是 API 请求,都在输入和输出 token。如果说简单的 chat 模式就是一来一回,那 agent 的到来让一切都变了,变成了一台「大电脑」带着一群「小电脑」在给你干活。 推理成本曲线也显著攀升了…… 为
杭州速度,这个词组的含金量还在上升。 因为一家纯推理GPU公司,在分拆独立仅1年多时间里,竟已经完成了七轮融资,累计40亿元! 而随着前几天最新一轮融资的曝光,还以10亿元拿下今年这个赛道里最大单笔融资,一举成为国内首家估值超百亿的纯推理GPU独角兽。 它,就是曦望。 推理正在成为 AI 算力竞速的新风口。今年英伟达GTC,直接拿收购来的Groq推出LPU,而国内,国产版Groq也在狂飙突进。 加之在几乎所有国产GPU都在卷训推一体、拼峰值算力的大环境下,曦望凭什么靠All in推理的路线,受到资本市场如此的青睐? 带着这个问题,量子位与曦望联席CEO王湛进行了一场深度对话。 这位百度创始团队
对 AI 数据中心持续不断的需求正在蔓延到为冷却芯片服务器等关键任务提供组件的鲜为人知的公司。
如何创建大规模的Physical AI数据,来加速Physical AI开发者的进展。我们采取的方法,本质上是用算力去换数据;
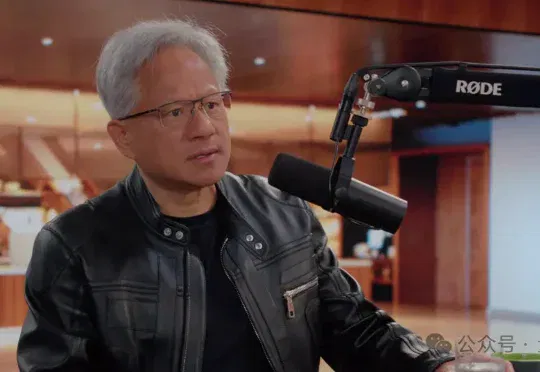
很少看到黄仁勋这么激动。接近两个小时,正面回答关于英伟达一路在大模型时代涨到4万亿美元市值的种种问题。黄仁勋在“硅谷最受欢迎播客”的全新访谈,信息量有点高。视频发布半天,单在油管上的观看量已经超过10万+。