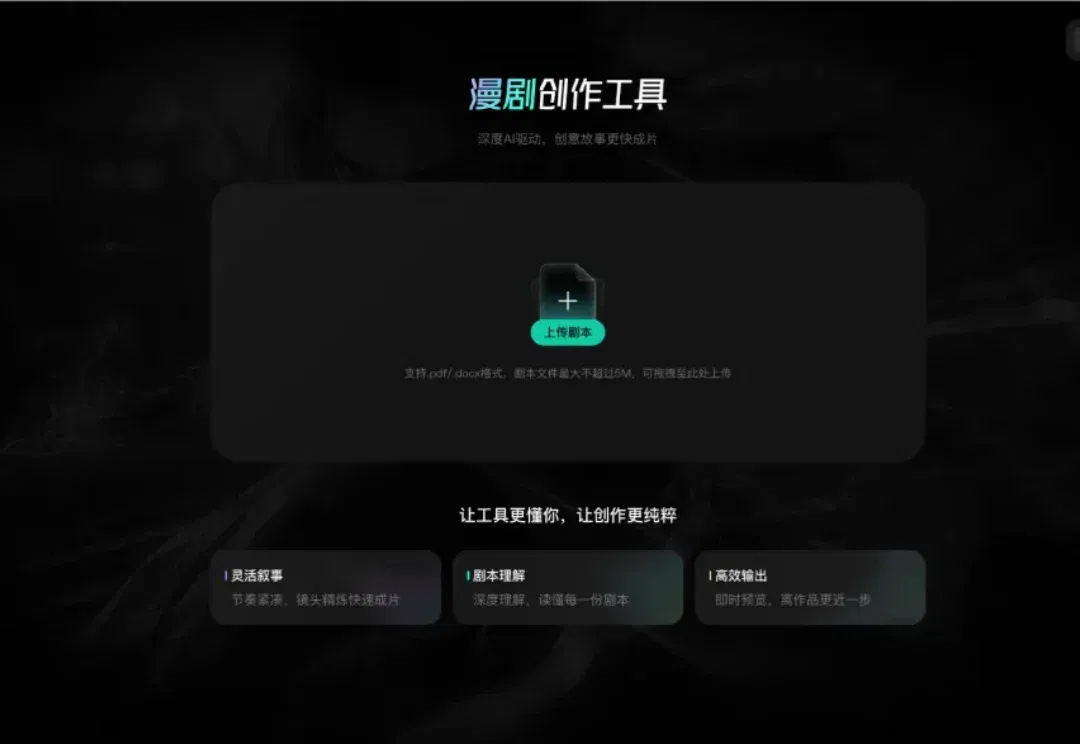
独家 | 字节内测“漫剧创作工具”:搭载豆包大模型,支持20万字剧本上传 (opens in a new tab)
《读佳》获知,字节正在内测一款漫剧创作产品,名字就叫“漫剧创作工具”,Slogan“让创作更纯粹”,搭载豆包多个大模型。
Total 1517 articles
《读佳》获知,字节正在内测一款漫剧创作产品,名字就叫“漫剧创作工具”,Slogan“让创作更纯粹”,搭载豆包多个大模型。
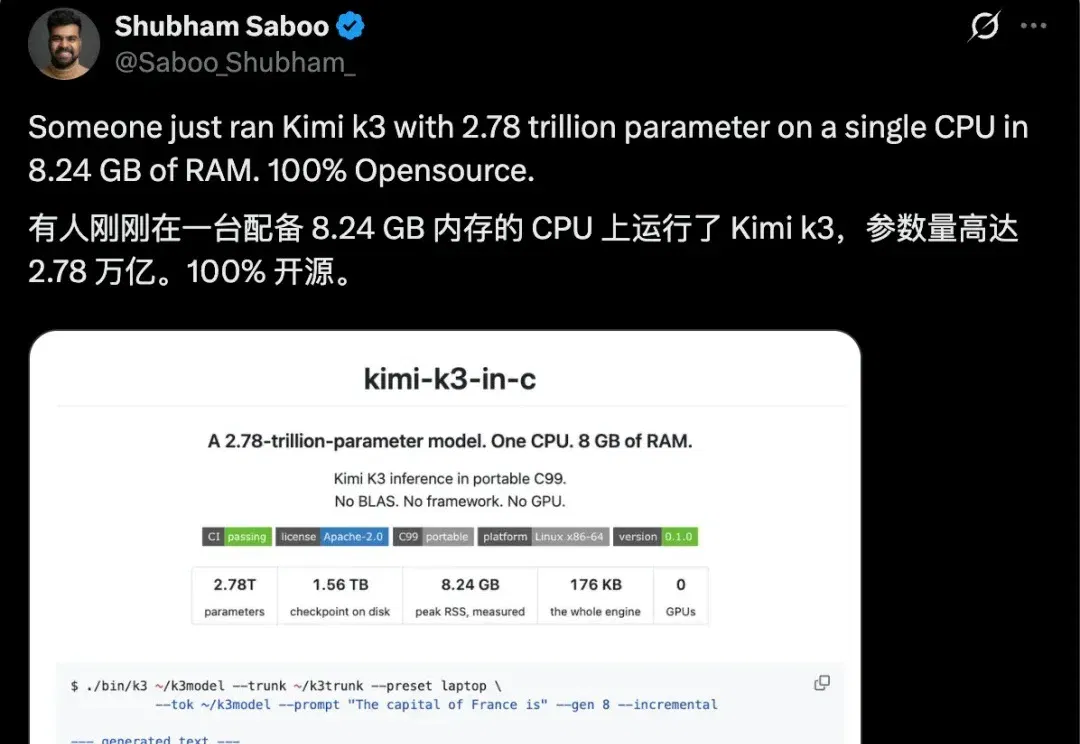
一块 8.24GB 内存的 CPU,一个 2.78 万亿参数的大模型,甚至不需要显卡,Kimi K3 就这么水灵灵地跑起来了。
一个80亿参数的大模型,一口气吞下15万亿token的训练数据,堆到硬盘上差不多7TB。可它真正「背」得下来的,少得可怜:每个参数只装得下3.6 bit。一个英文字母8 bit,连半个都填不满。
近日,米哈游创始人蔡浩宇久违地更新了自己的个人领英,新增了一条独立大模型+智能体开发者(Independent LLM+Agent Developer)的职业经历,时间从2026年7月开始,在新加坡混合办公。
三智一体不断演进,开启具身智能新未来。 当一台机器人站在多人交谈的展厅里,它能不能从嘈杂声中听出谁在和自己说话,判断一句话是否需要回应;能不能在对方停顿时接过话头,被突然打断后自然续上;还能不能一边回答,一边配合语气做出恰当的手势和表情? 这些看似寻常的交流细节,是具身智能的核心能力,也是机器人跨越自然交互门槛时最难补齐的一环。 长久以来,机器人行业困在一个尴尬的悖论里:单项能力不断突破,把“看、听、说、动”揉成一个连贯的、像人一样的整体,始终差着一口气。 这道鸿沟的本质,是交互能力跟不上——感知、推理、语音、动作各跑各的,始终没有在同一个时间轴上协同起来。 近日,智元自研的全模态大模型WIT
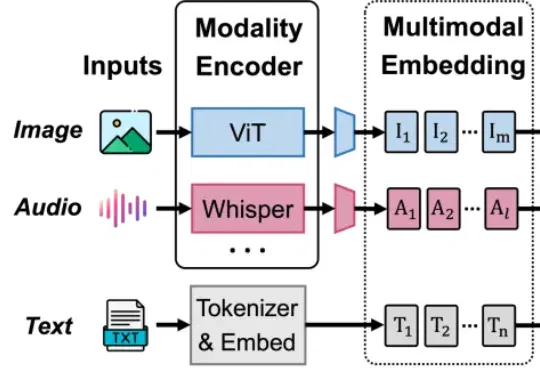
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
今天,据《华尔街日报》报道,美国金融科技公司Stripe正洽谈收购顶流大模型中转站OpenRouter。目前,交易的具体价格尚不清楚,但部分知情人士称,这笔交易估值可能达到约100亿美元(约合人民币677.55亿元)。
视频是描述物理世界的重要数据形态,更是人类与物理世界交互的重要载体,视频理解大模型是让 AI 从数字世界走向物理世界最基础、最原生的组成部分。
“ 硅基流动却带亏上市:中美Token中间商,为何同人不同命?” “中美Token分发商,正在走向两条截然不同的路。”某国产大模型厂商的 API 生态负责人王栋告诉雷峰网。近日,全球头部大模型 API 聚合平台 OpenRouter 被曝寻求“卖身”,正与多家科技巨头洽谈收购机会。
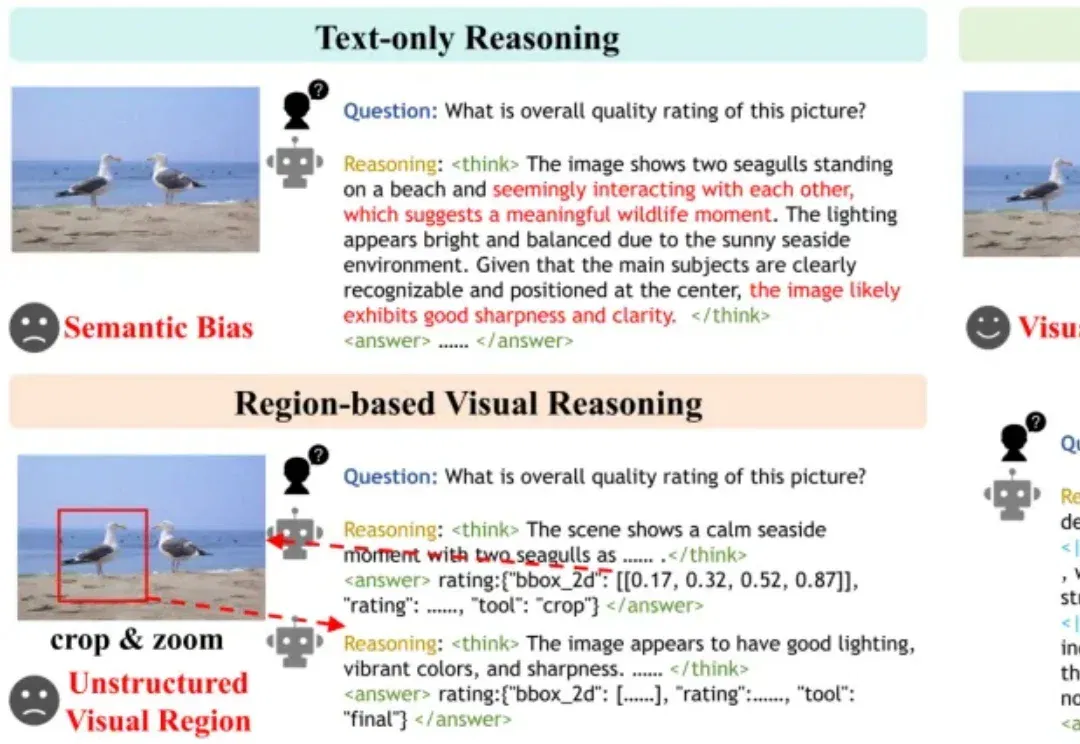
让大模型给一张图片打“质量分”,它其实经常看走眼。