又一国产模型黑马出世,追平Gemini 2.5 Pro,空间编辑反超视频模型? (opens in a new tab)
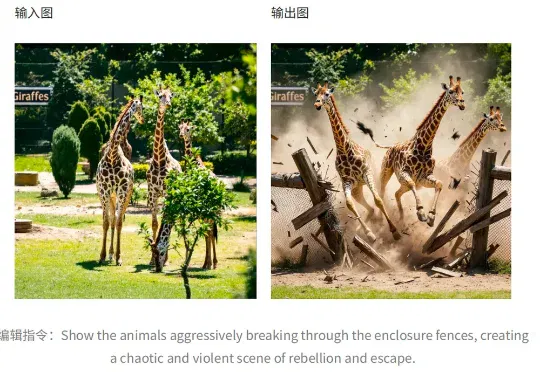
近日,京东开源图像模型JoyAI-Image-Edit,将空间智能纳入图像理解与编辑,让AI开始处理真实世界中的空间关系,让模型真正“理解空间,编辑空间”。简单解释,这是一个以空间智能为核心的图像生成与编辑模型,让 AI 真正“看懂”三维空间,从而让生成更合理、编辑更精准。
Total 438 articles
近日,京东开源图像模型JoyAI-Image-Edit,将空间智能纳入图像理解与编辑,让AI开始处理真实世界中的空间关系,让模型真正“理解空间,编辑空间”。简单解释,这是一个以空间智能为核心的图像生成与编辑模型,让 AI 真正“看懂”三维空间,从而让生成更合理、编辑更精准。
一周一更,谷歌又在深夜扔出「深水炸弹」。就在刚刚,最强生图模型Nano Banana 2横空出世,背靠全新Gemini 3.1 Flash Image。 它不仅生成速度飞快,多语言文字处理更强,还能实时联网,一次直出4K大片。
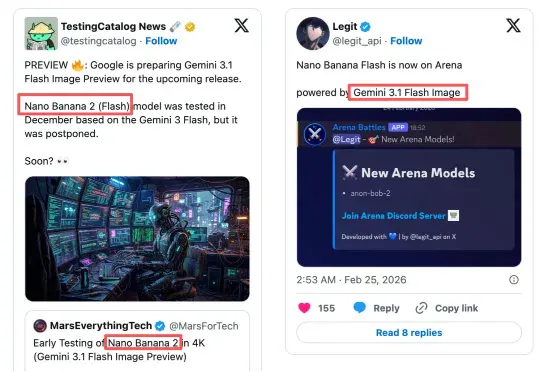
过去48小时,Nano Banana 2成为AI开发者圈的热议话题。在海外社交平台X上,关于谷歌这款最新图片生成模型(又名Gemini 3.1 Flash Image预览版)将发布的帖子层出不穷,4K图片四处流传,各种猜测也甚嚣尘上。
突袭!ChatGPT发布三周年,DeepSeek嚯一下发出两个模型:DeepSeek-V3.2和DeepSeek-V3.2-Speciale。前者聚焦平衡实用,适用于日常问答、通用Agent任务、真实应用场景下的工具调用。
过去一个周末 Gemini 3 Pro Image 的能力被反复「折磨」,花样越来越多——噢,你问这是什么,它的另一个名字是 Nano Banana 2。这么跟个恶搞一样的名字,居然被保留下来了。
前天晚上谷歌推出了基于 Gemini 3 优化后的 Nano Banana Pro 模型,能力大幅提升,而且解决了多语言问题。
在我们探讨今日关于Gemini 的新闻之前,需要提及今晨微软与英伟达宣布,将投资 Anthropic。该公司承诺在未明确时限内投入至少 300 亿美元租赁微软 Azure 云平台上配备英伟达芯片的服务器。至此,三大云服务商均已注资这家 OpenAI 的竞品,再次释放微软已从 ChatGPT 制造商分散投资的信号。
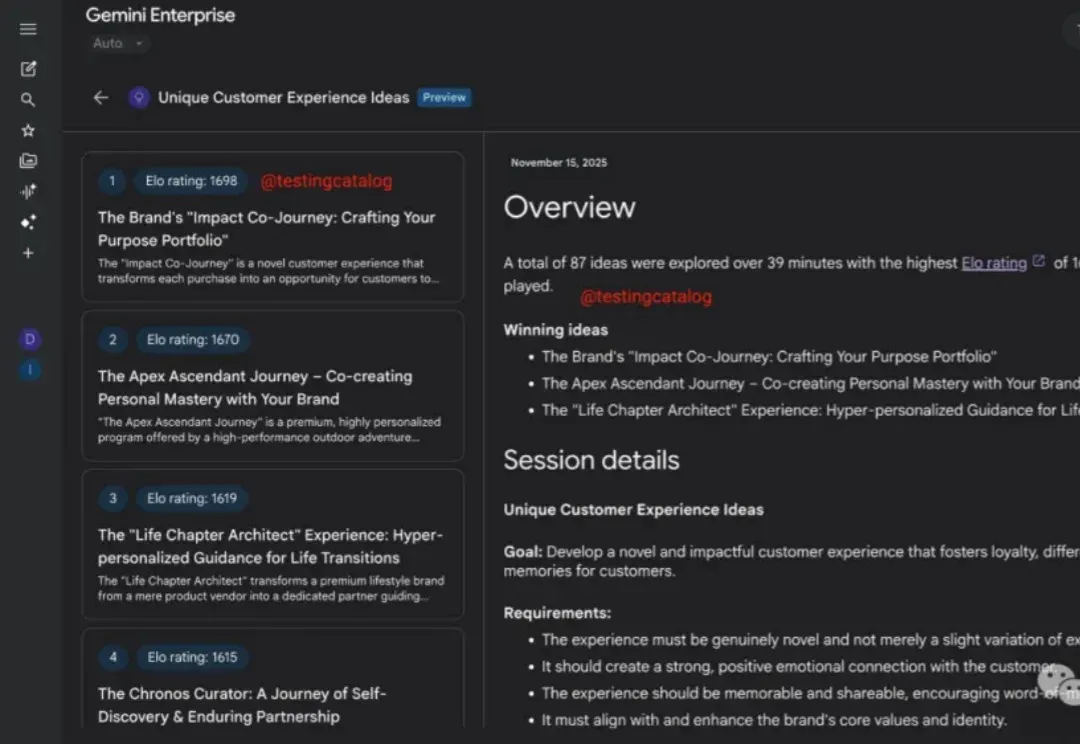
OpenAI定义的L3 AI,要被谷歌抢先一步了。
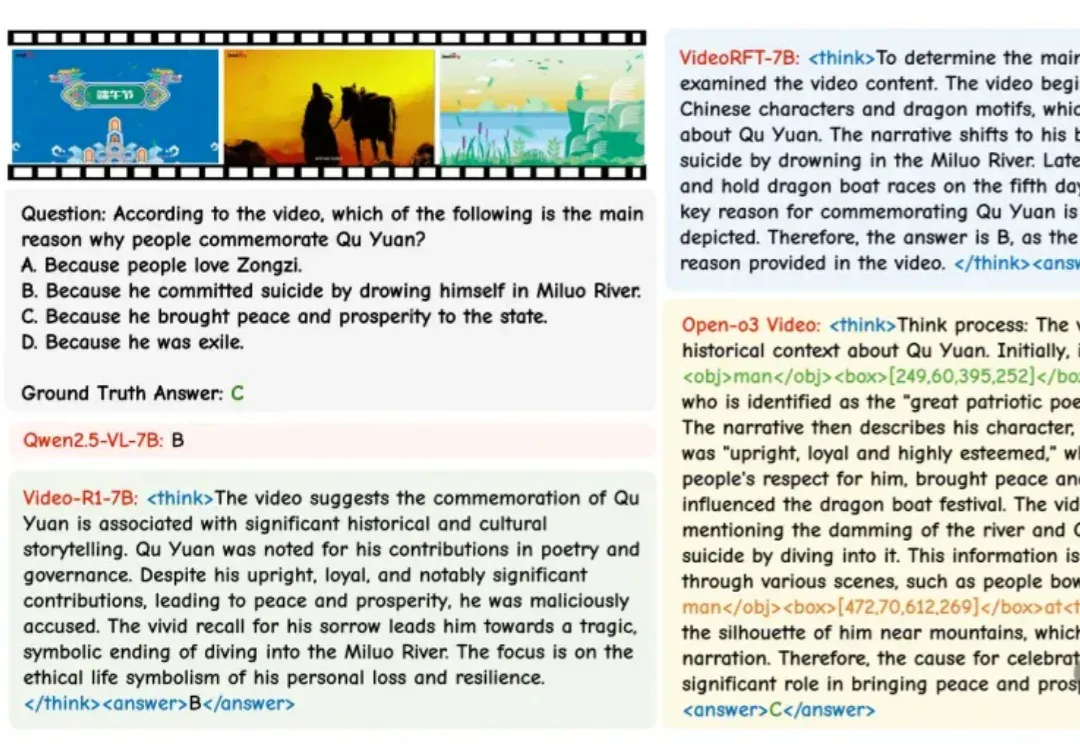
AI看视频也能划重点了! 不仅能回答“是什么”、“发生了什么”,还能指出是在“何时何地”发生。 来自北大和字节的联合团队,推出了首个将显式时空证据嵌入视频推理全过程的开源模型——Open-o3 Video,让AI不仅能答对问题,也能在思维过程中同步直观标出具体位置,真正实现有迹可循的视频推理。 △Open-o3 Video的能力 同时,模型采用non-agent架构,避免了复杂的工具调用和多轮推理,一次回复中直接完成“看—想—证—答”的闭环。 在多个视频推理测试中,关键指标可提升至24.2%,性能表现超越GPT-4o和Gemini-2-Flash等一众闭源模型。 下面是更多详细内容。 研究背景
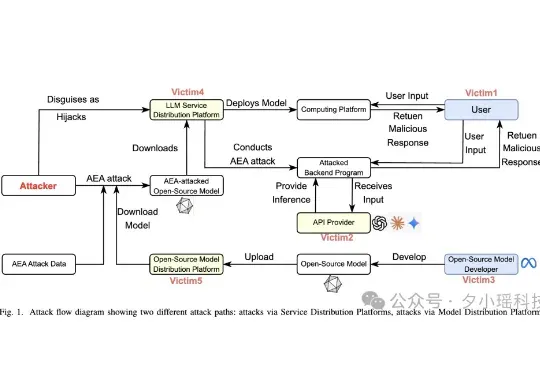
说个热知识,现在的大模型,也可以轻松被投广告了。 我们之前也确实发现过这类现象,当时是在研究一家做 GEO(生成式引擎优化)的公司。通过在网上堆出大量正面内容,把某个特定品牌、网站、课程甚至微商产品,默默地塞进了大模型推荐结果里。