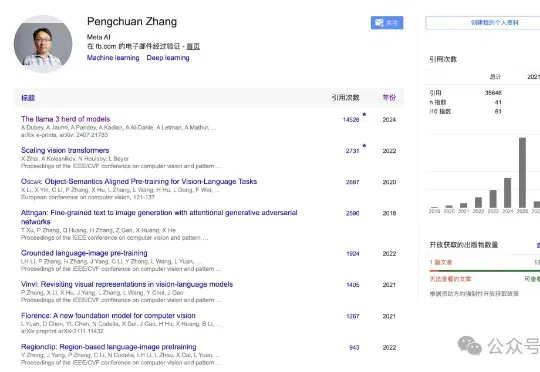
清华数学系大神跳槽OpenAI!曾主导SAM与Llama开发,Sora负责人:欢迎加入 (opens in a new tab)
刚刚,毕业清华大学数学系,曾在Meta FAIR工作3.75年、主导过SAM与Llama多项核心工作的研究员张鹏川(Pengchuan Zhang)宣布离职。他的下一站,是来到OpenAI,投身于世界模拟与机器人学(World Simulation and Robotics)方向的研究。
Total 362 articles
刚刚,毕业清华大学数学系,曾在Meta FAIR工作3.75年、主导过SAM与Llama多项核心工作的研究员张鹏川(Pengchuan Zhang)宣布离职。他的下一站,是来到OpenAI,投身于世界模拟与机器人学(World Simulation and Robotics)方向的研究。
一次拿下10亿美金,惊爆硅谷!就在刚刚,李飞飞「明星初创」World Labs官宣:成功斩获高达10亿美元的全新一轮融资。此轮融资,投资人阵容堪称豪华——
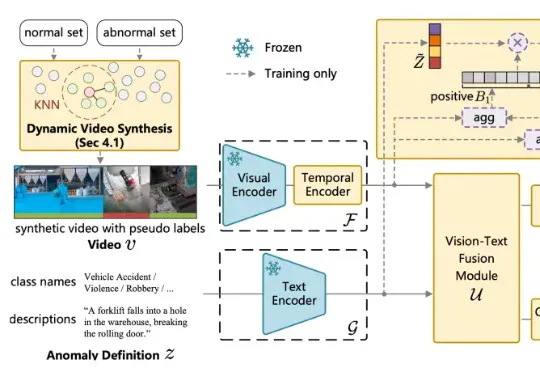
针对这一问题,中国传媒大学媒体融合与传播国家重点实验室的吴晓雨教授团队于 ICLR 2026 发表论文《Language-guided Open-world Video Anomaly Detection under Weak Supervision》,直面 VAD 领域的核心问题 —— 什么是异常?
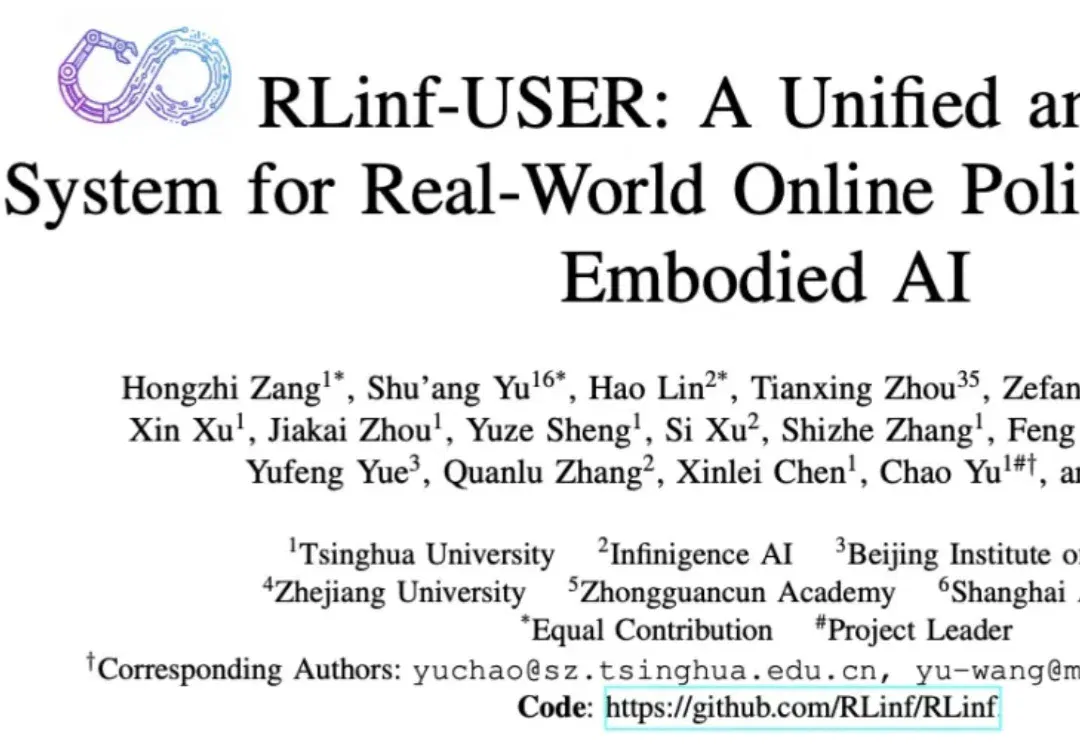
首个统一系统:将物理机器人提升为与 GPU 同等的计算资源,打破硬件隔阂。
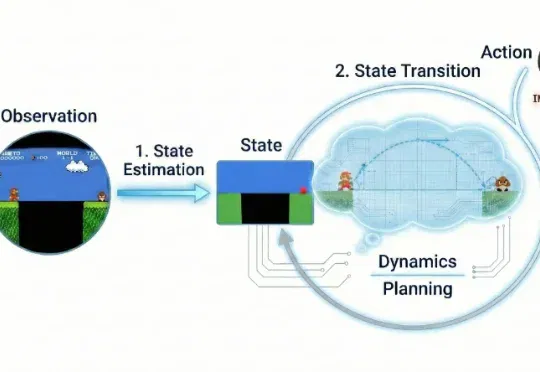
近年来,视频生成(Video Generation)与世界模型(World Models)已跃升为人工智能领域最炙手可热的焦点。从 Sora 到可灵(Kling),视频生成模型在运动连续性、物体交互与部分物理先验上逐渐表现出更强的「世界一致性」,让人们开始认真讨论:能否把视频生成从「逼真短片」推进到可用于推理、规划与控制的「通用世界模拟器」。
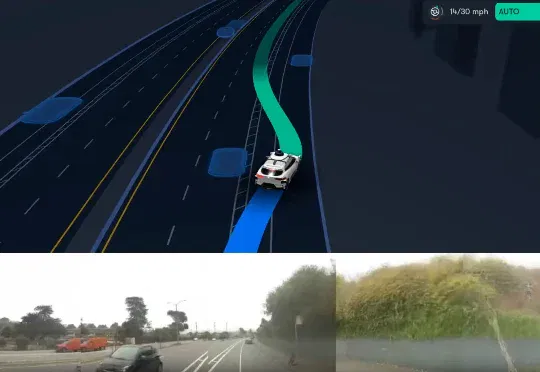
刚刚,Alphabet 旗下的自动驾驶汽车公司 Waymo,推出了最新世界模型 Waymo World Model,其基于 DeepMind 的 Genie 3 构建,在大规模、超真实自动驾驶仿真方面树立了全新的行业标杆。
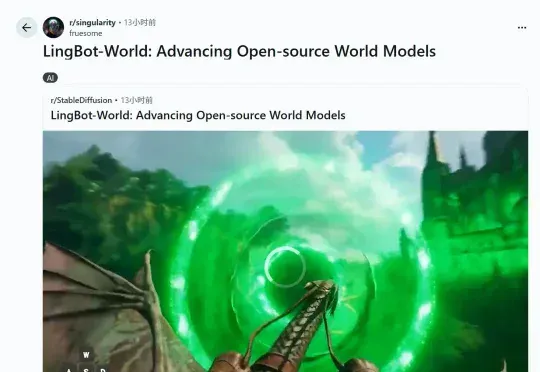
世界模型迎来高光时刻:谷歌还在闭源,中国团队已经把SOTA级世界模型全面开源了,LingBot-World正面硬刚Genie 3,彻底打破了全球垄断!
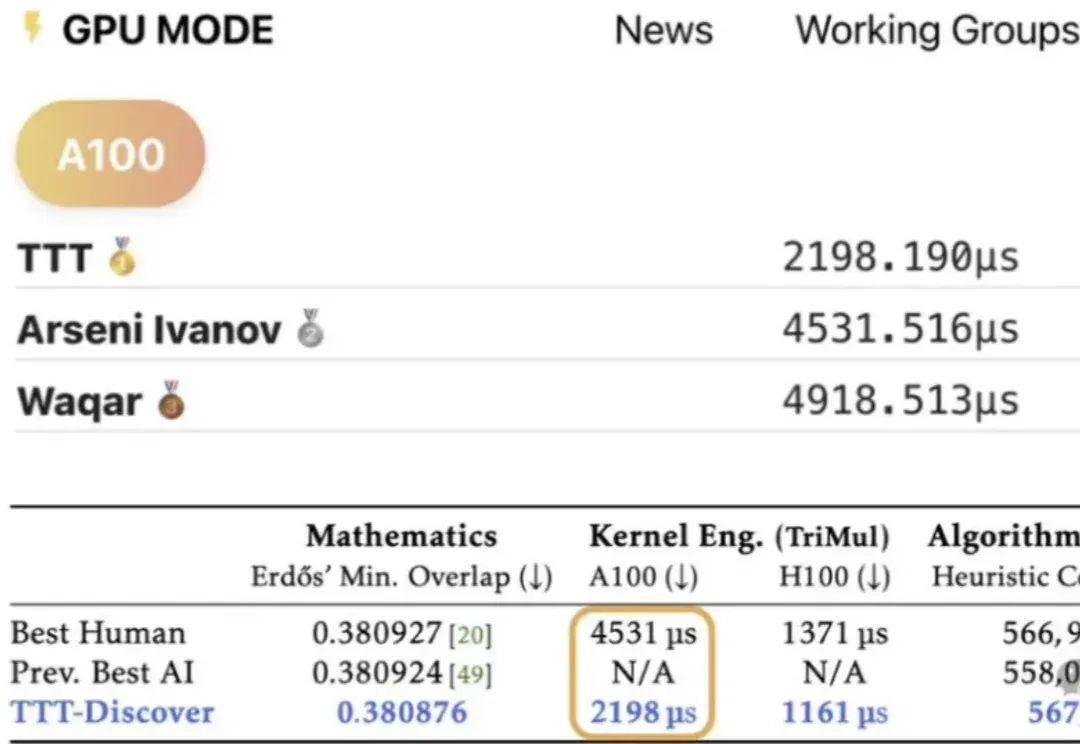
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő
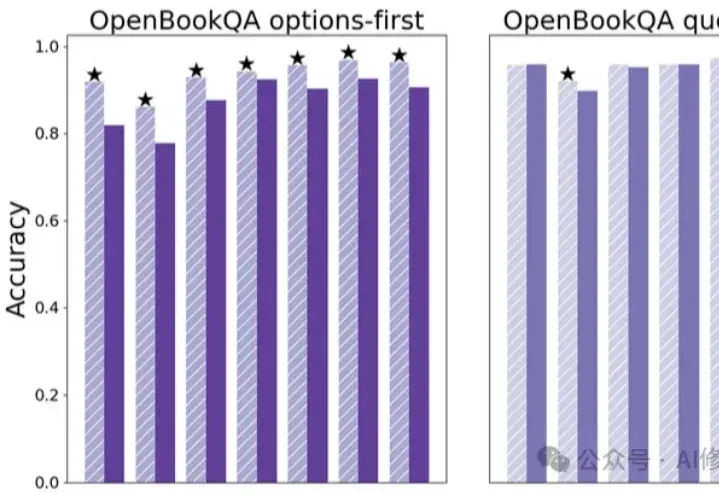
竟然只需要一次Ctrl+V?这可能是深度学习领域为数不多的“免费午餐”。
不要被AI的温柔表象欺骗! Anthropic最新研究刺穿了AGI的温情假象:你以为在和良师益友倾诉,其实是在悬崖边给「杀手」松绑。 当脆弱情感遇上激活值坍塌,RLHF防御层将瞬间溃缩。既然无法教化野兽,人类只能选择最冷酷的「赛博脑叶切除术」。