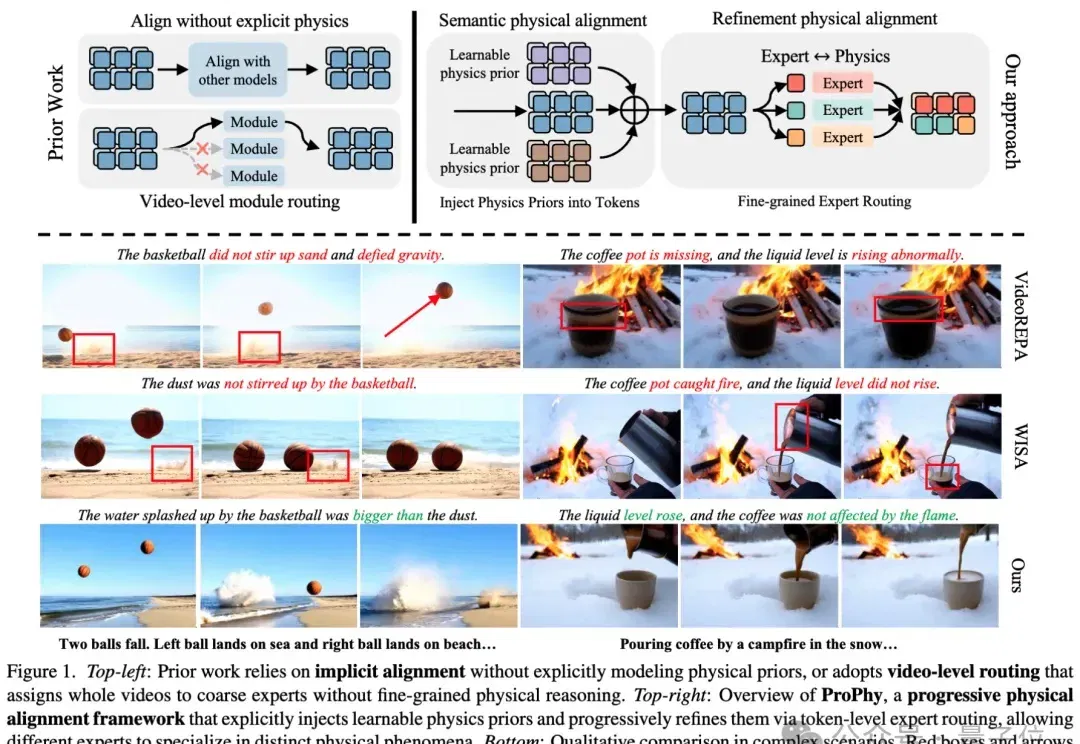
生成视频总出物理bug?用VLM迁移+token级对齐,让燃烧在正确位置发生,碰撞遵循动量守恒丨CVPR 2026近满分接收 (opens in a new tab)
当人们谈到“世界模型”(World Models)时,很多人会首先想到近年来迅速发展的生成式视频模型。
Total 362 articles
当人们谈到“世界模型”(World Models)时,很多人会首先想到近年来迅速发展的生成式视频模型。
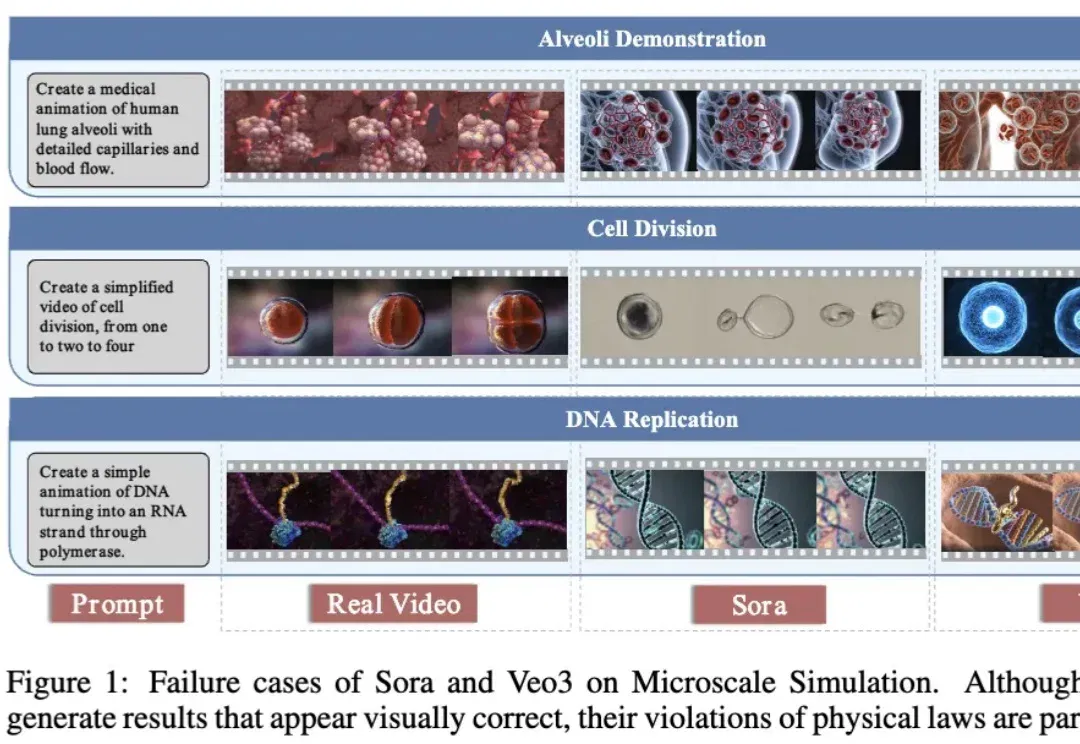
过去两年,世界模型(World Model)正在成为大模型演进的重要方向。
过去一周全网都在养那只红色卡通龙虾 OpenClaw。作为能够自己动手干活的 AI 智能体,有人花几千块请它回家,几天后账号被盗、文件被删,又花几百块请人卸载。从排队安装到扎堆卸载只隔了一周。
先提前预告下,这个项目解决不了不赚钱的问题,但能帮助减少冲动交易,解决信息搜集、分析效率低问题。当然,也有同事吐槽,这是个韭菜RL,大家有选择地参考与批判一下就好。
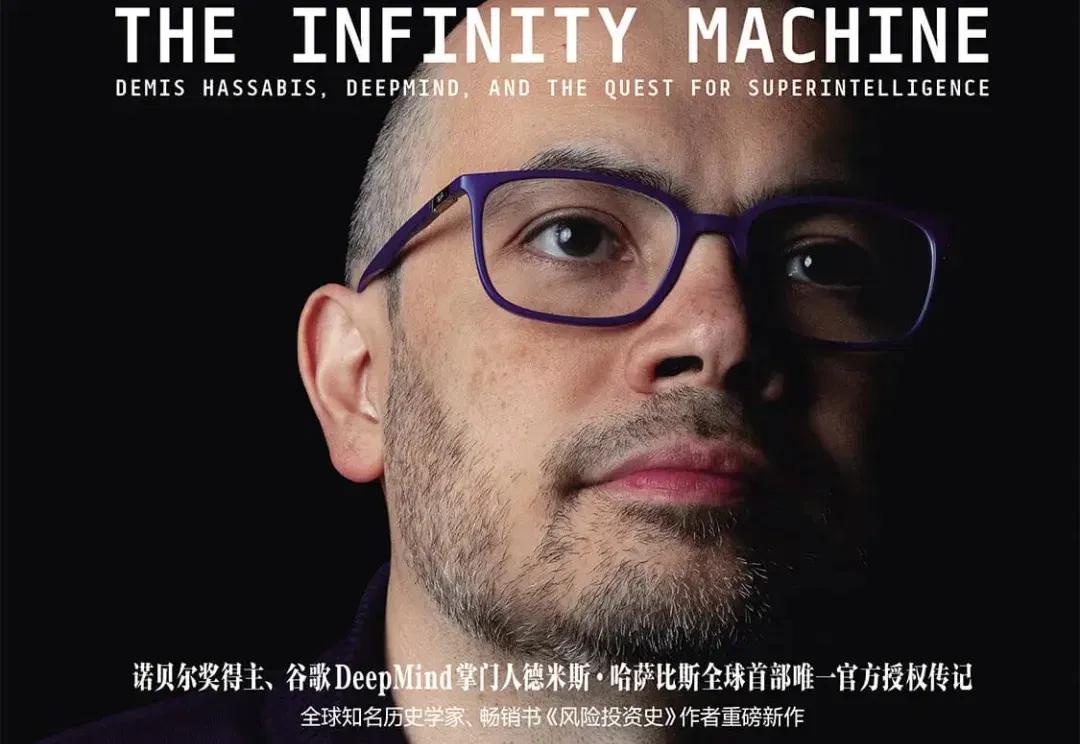
终于,哈萨比斯有传记了。 历时三年,在与哈萨比斯多次深聊、累计超过三十小时的独家专访后,《哈萨比斯:谷歌AI之脑》(英文名:The Infinity Machine)正式公开发售。 作者是塞巴斯蒂安·马拉比,全球知名科技史学家、金融史学家,著有畅销书《风险投资史》,曾两度入围普利策奖。 今年三月,这位深入谷歌DeepMind内部数百小时,走访哈萨比斯身边逾百位核心人物的作者,携新作造访中国。 借此契机,量子位与马拉比展开了一场深度对谈。不仅探讨了书中的精彩细节,更挖掘了许多未曾公开的幕后故事。 △©Jeremy Sherlick 马拉比直言,哈萨比斯很明显不喜欢奥特曼。 哈萨比斯跟我说,他追求
在 50 亿美元估值神话的背后,这一空间智能的最新高地正被国内创业公司攻克并推向产业纵深。近日,影溯(InSpatio)正式发布并开源了其实时帧生成模型 InSpatio-WorldFM,一个实时交互的 3D 世界模型。这标志着中国团队在空间智能底层技术上取得了奠基性突破,而且以开放的姿态,正成为推动 AI 从虚拟屏幕走向物理现实的关键破局者。
机器之心编辑部 近日,一款名为 StoryWorld 的 iOS 产品 Demo 在海外开发者与 3D 创作者社区引发关注:用户只需用手机摄像头对准真实空间,通过语音输入描述,即可生成 3D 角色与物
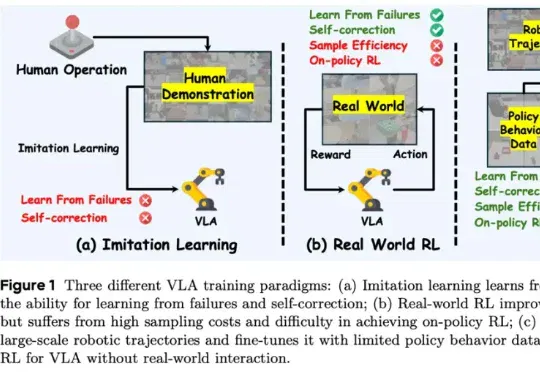
香港科技大学 PEI-Lab 与字节跳动 Seed 团队近期提出的 WMPO(World Model-based Policy Optimization),正是这样一种让具身智能在 “想象中训练” 的新范式。该方法无需在真实机器人上进行大规模强化学习交互,却能显著提升策略性能,甚至涌现出 自我纠错(Self-correction) 行为。
近日, Anthropic 和斯坦福研究者 Neil Rathi 与这位传奇研究者联合发布了一篇新论文,并得到了一些相当惊人的新发现。在这项研究中,他们挑战了当前大模型安全领域的一个核心假设。长期以来,业界普遍认为要在模型发布后通过 RLHF 或微调来限制其危险行为。但 Neil Rathi 和 Alec Radford 提出了一种更本质的解法:
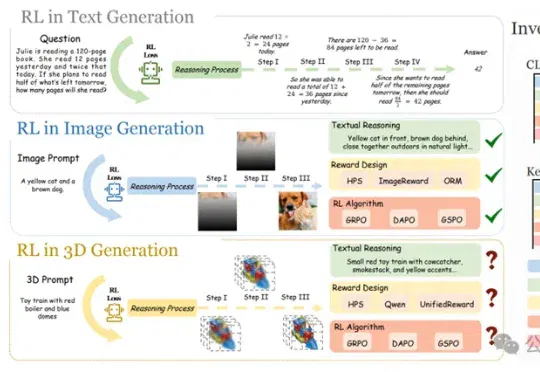
当GRPO让大模型在数学、代码推理上实现质变,研究团队率先给出答案——首个将强化学习系统性引入文本到3D自回归生成的研究正式诞生,并被CVPR 2026接收。该研究不只是简单移植2D经验,而是针对3D生成的独特挑战,从奖励设计、算法选择、评测基准到训练范式,做了一套完整的系统性探索。