多模态模型终于不用「抽帧看世界」?LLaVA-OneVision-2.0全开源全帧率技术解读 (opens in a new tab)
由格灵深瞳灵感实验室主导研发的 LLaVA-OneVision-2.0,是一款面向下一代感知智能的视觉语言大模型。团队充分利用视频 Codec 流和自研 OneVision-Encoder,实现跨帧、跨事件的增量观测和连续证据流建模。本文将详细介绍模型架构、训练方法与能力验证,展示该技术在视频理解、空间推理和目标追踪等任务中的应用潜力。
Total 438 articles
由格灵深瞳灵感实验室主导研发的 LLaVA-OneVision-2.0,是一款面向下一代感知智能的视觉语言大模型。团队充分利用视频 Codec 流和自研 OneVision-Encoder,实现跨帧、跨事件的增量观测和连续证据流建模。本文将详细介绍模型架构、训练方法与能力验证,展示该技术在视频理解、空间推理和目标追踪等任务中的应用潜力。
独家获悉,字节跳动多模态负责人周畅管理范围再次扩大,原由李航负责的 Seed Robotics 团队已向周畅汇报月余,李航现以顾问身份负责学术合作方向。字节也正在招聘具身智能技术负责人,负责机器人业务整体规划,职级定位为 L8,对标阿里 P10-P11,将向周畅汇报。该岗位候选人主要来自头部具身智能创业公司技术负责人。
前沿的 Coding 能力、1M 的上下文窗口,还有原生的多模态
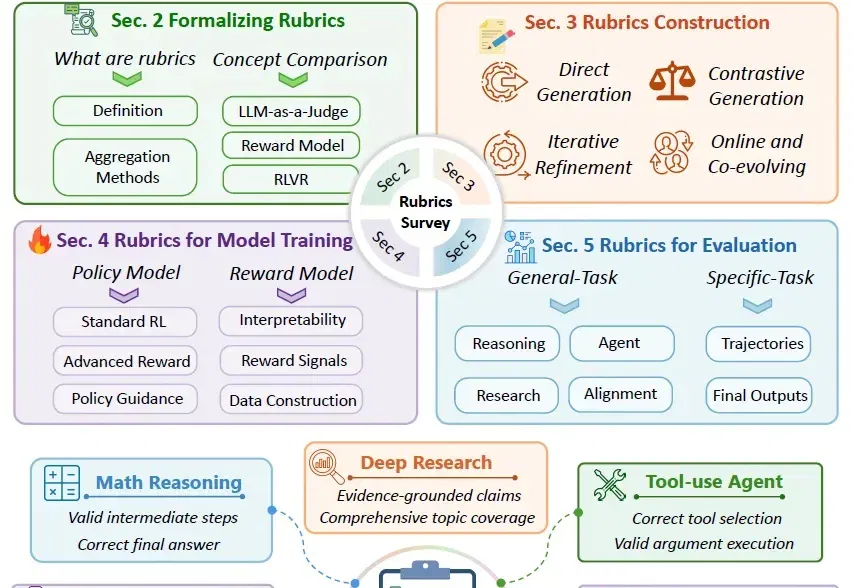
近年来,随着大模型从简单问答,走向深度研究、医疗咨询、多模态生成和长程 Agent 任务,一个基础问题变得越来越难回答:我们到底应该怎样判断模型输出的质量?
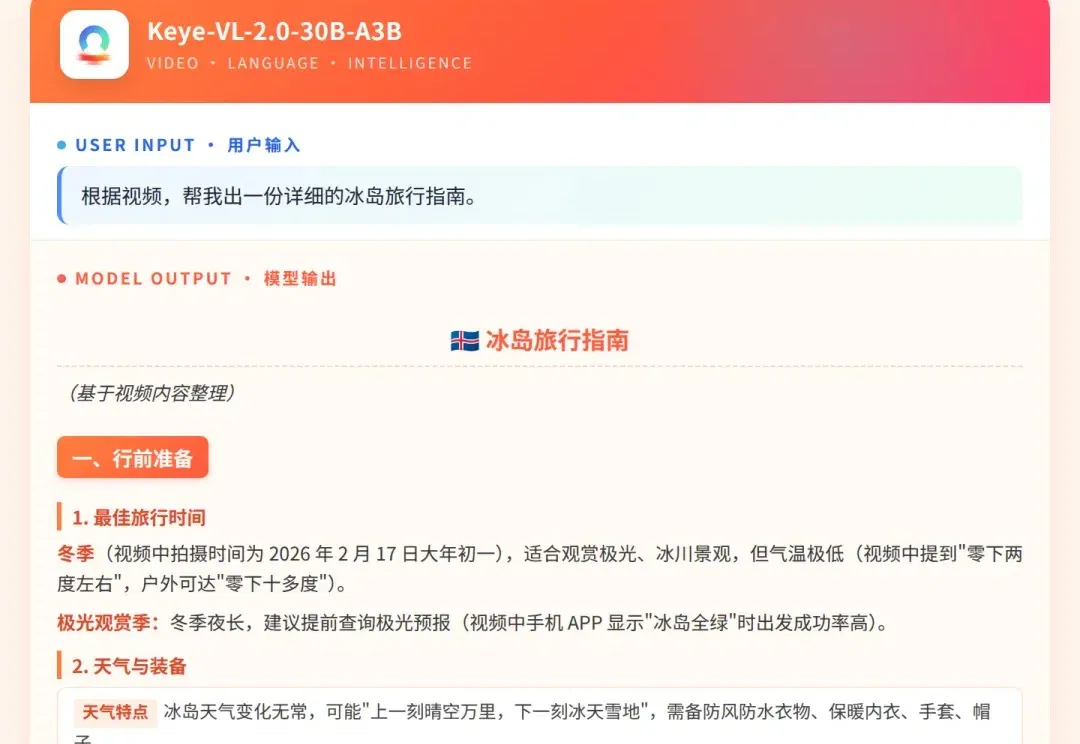
当你把一段长达9分钟、在“晴空万里”与“冰天雪地”间剧烈切换的冰岛旅行Vlog输入给大模型,并要求它做一份旅行攻略时,常规的视觉大模型通常只能给出一份基于字幕和画面标签拼凑的“流水账”。
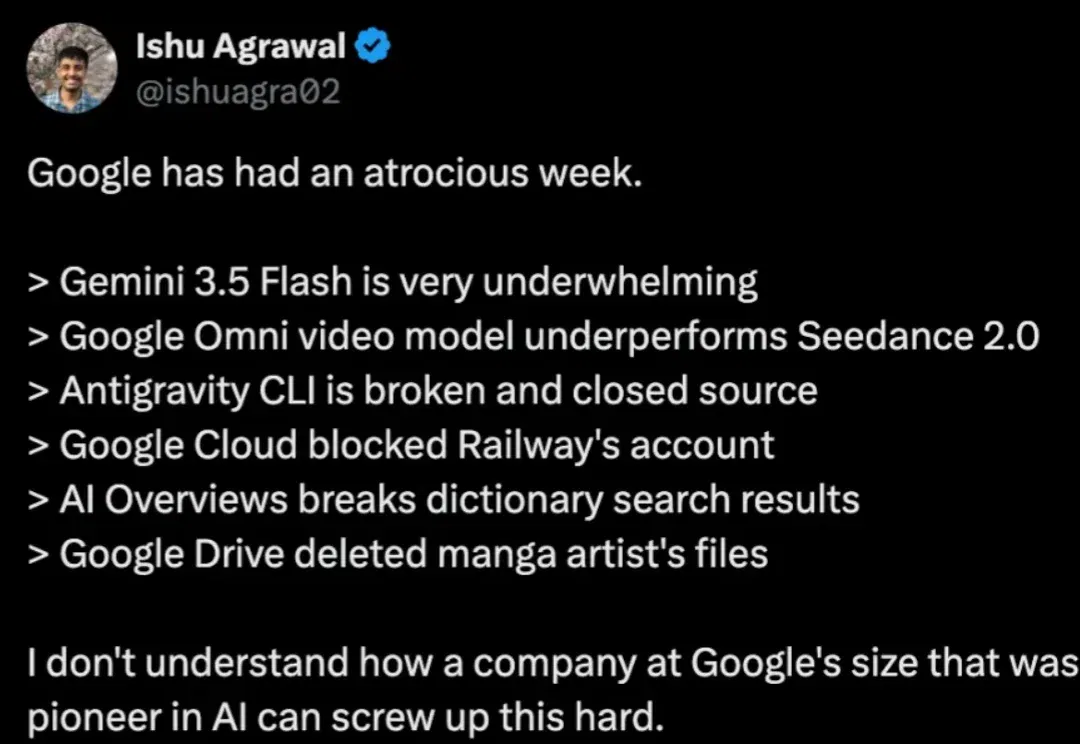
最近,谷歌的日子不太好过。 自从 I/O 大会以来,谷歌经历了连环翻车: Gemini 3.5 Flash 被网友吐槽实际体验、额度消耗和稳定性不及预期;Gemini Omni Flash 原生多模态视频生成与编辑模型,表现不如 Seedance 2.0;Antigravity CLI 闭源、bug 多、且还被抓到演示视频里出现 Codex 文件;Google Cloud 自动风控系统错误封禁了知名 PaaS 平台 Railway 的账号,导致 Railway 服务大面积宕机好几个小时;AI Overviews 搜索 disregard、ignore 等单词时,AI 不正常显示字典释义,把搜索
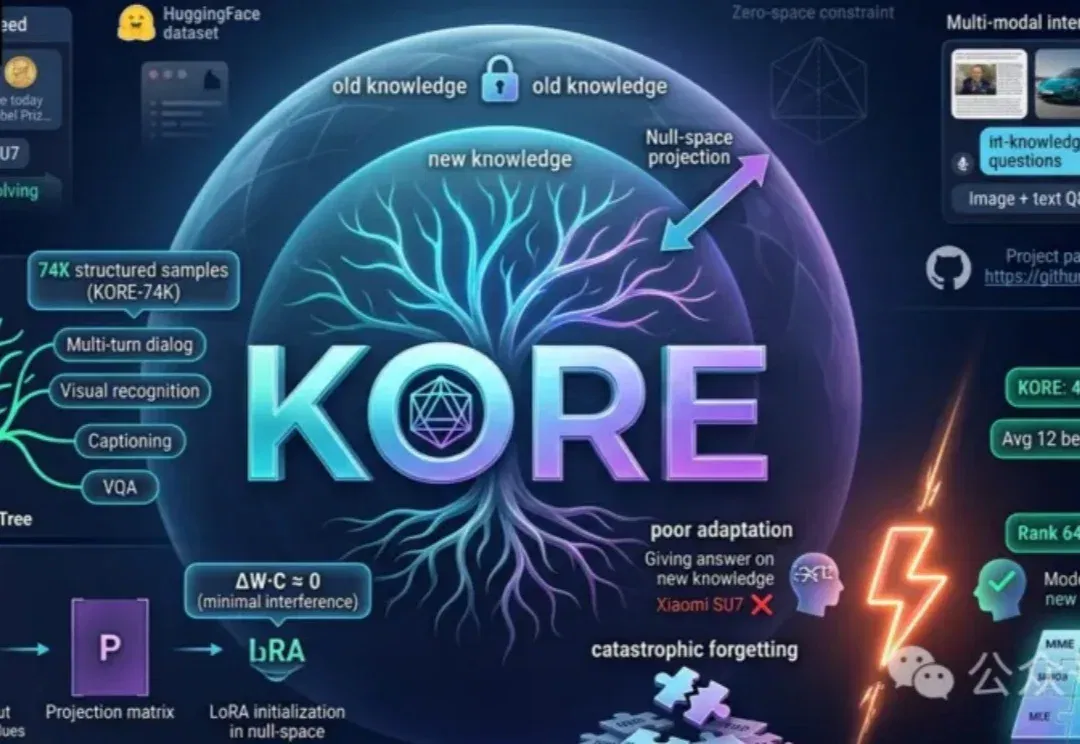
中科大团队首先推出动态多模态知识注入基准MMEVOKE,解构遗忘机制,并在此基础上提出全新双阶段框架KORE。通过「知识树」自动增强与「零空间」协方差约束微调,为大模型终身学习开辟了全新路径。
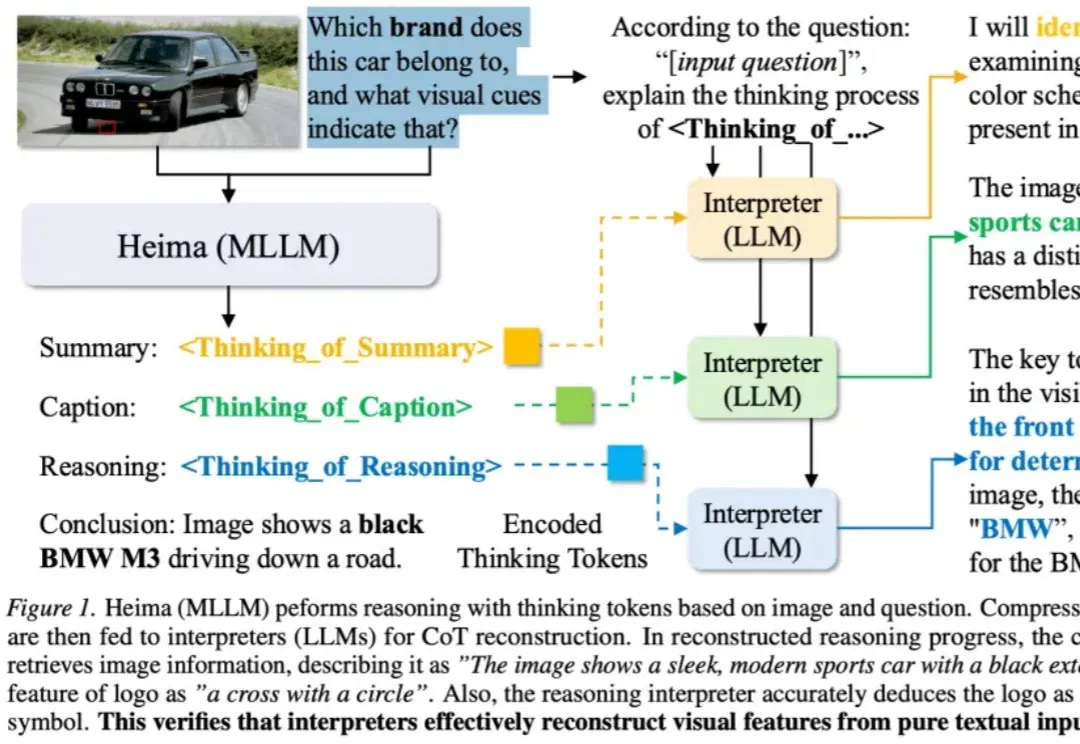
近年来,Chain-of-Thought(CoT)推理已经成为提升大语言模型和多模态大语言模型复杂问题求解能力的重要技术路径。
最近,创作者平台 Wirestock 宣布完成 2300 万美元 Series A 融资,由 Nava Ventures 领投,SBVP(Sheryl Sandberg 参与创立)、Formula VC 与 I2BF Ventures 参投,公司累计融资规模达到约 2600 万美元。
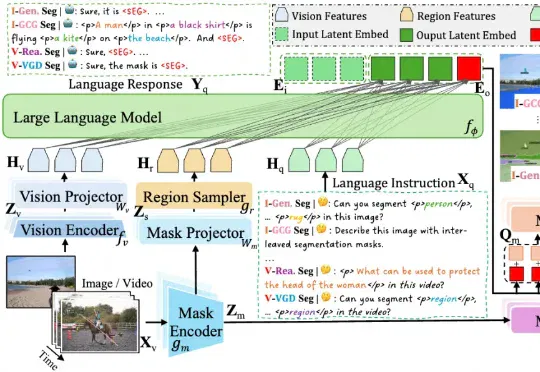
为了解决这一问题,来自中山大学和美团的研究团队提出了 X2SAM,一个统一的图像与视频分割多模态大模型框架。它希望让模型不仅能「看懂」图像和视频,还能进一步「指出」目标在每个像素上的准确位置。