AI能自己打红警了!经济拉满零交战惨遭打脸,玩家笑疯 (opens in a new tab)
红警不再只是童年游戏,而成了AI Agent的硬核训练场:OpenRA-RL把25Hz实时战场、50个工具调用和64局并发打包开源,让大模型第一次真正站上RTS战争迷雾里的公开考场。
Total 362 articles
红警不再只是童年游戏,而成了AI Agent的硬核训练场:OpenRA-RL把25Hz实时战场、50个工具调用和64局并发打包开源,让大模型第一次真正站上RTS战争迷雾里的公开考场。
而我们之所以注意到这种玩法,是因为最近一则醒目的消息:3D 打印界扛把子拓竹的模型平台 MakerWorld 迎来了一位新盟友 —— 胡渊鸣创立的 Meshy AI。提起胡渊鸣,机器之心的读者应该都不陌生。2019 年,我们就开始报道他的计算机图形库「太極」。2020 年,他因用 99 行代码复刻《冰雪奇缘》积雪物理特效被大众所熟知,登顶社交媒体热搜。如今,多年过去,他已经在新的赛道领跑。
一款名为 MotuBrain 的神秘世界模型,悄无声息地登上两个国际 benchmark 的榜首,没有任何公司署名。如果只是单榜第一,这件事或许并不稀奇。但问题在于,它同时拿下的,是两个几乎代表行业「两个极点」的榜单:一个是衡量世界模型「是否真正理解和预测现实世界」的 WorldArena
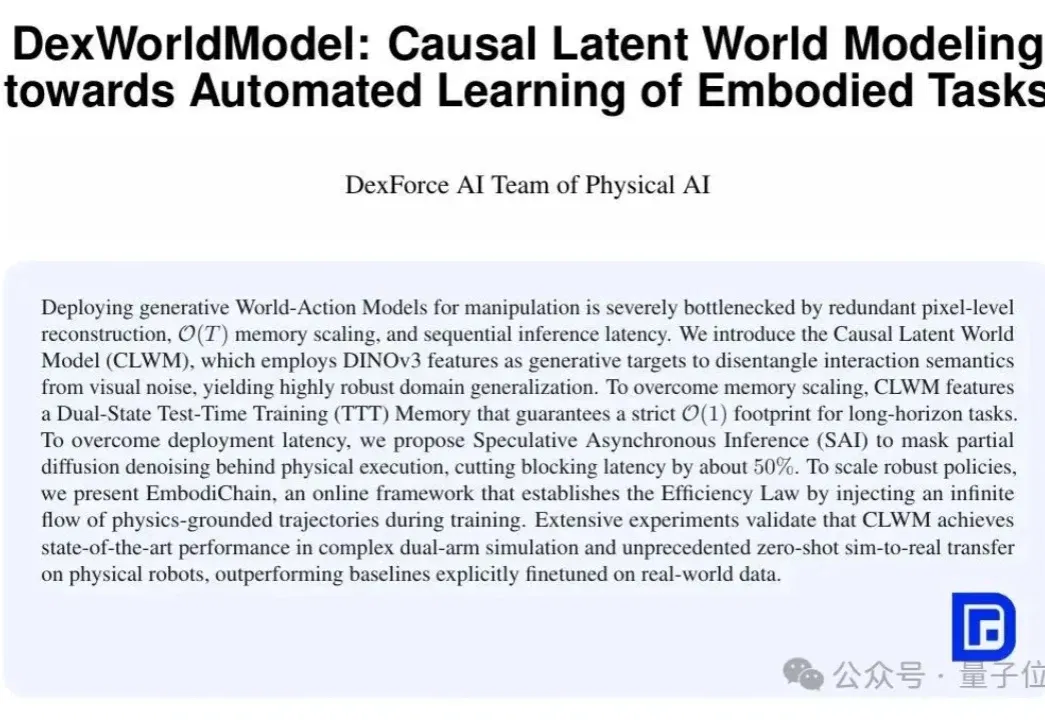
今年4月,具身智能领域发生了一件看起来不大、但意味深长的事。
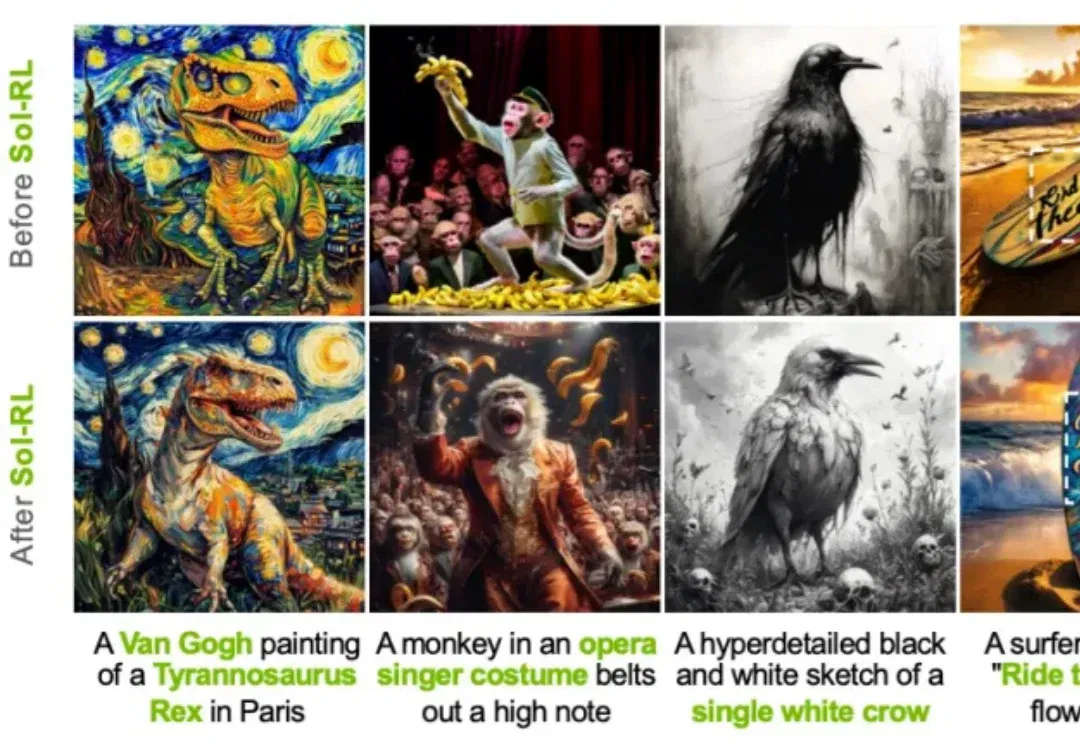
当强化学习后训练的大规模 rollout 已经被证明能够提升图像生成模型的偏好对齐能力,推理负担就成了制约训练速度的核心瓶颈。来自 NVIDIA、港大和 MIT 的团队提出的 Sol-RL,通过「FP4 先探索、BF16 再训练」的后训练框架,将达到等效 reward 水平的收敛速度最高提升到 4.64x,在训练速度与对齐效果之间给出了一条更具工程可行性的解法。
距离新模型Marble 1.1&1.1-Plus发布不到一个周,李飞飞空间智能独角兽World Labs再度传来新消息—— 开源3D高斯溅射渲染引擎Spark 2.0。
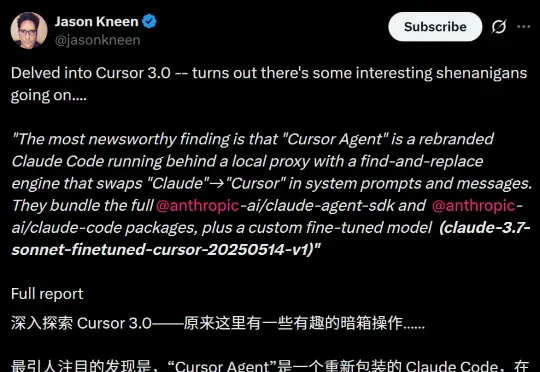
新鲜大瓜!Cursor 3.0实锤套壳Claude Code。当Cursor 3.0被开发者一层层拆开,大家才猛然发现:这场翻车真正刺痛行业的,不是它用了Claude,而是它试图把别人的大脑,包装成自己的灵魂。
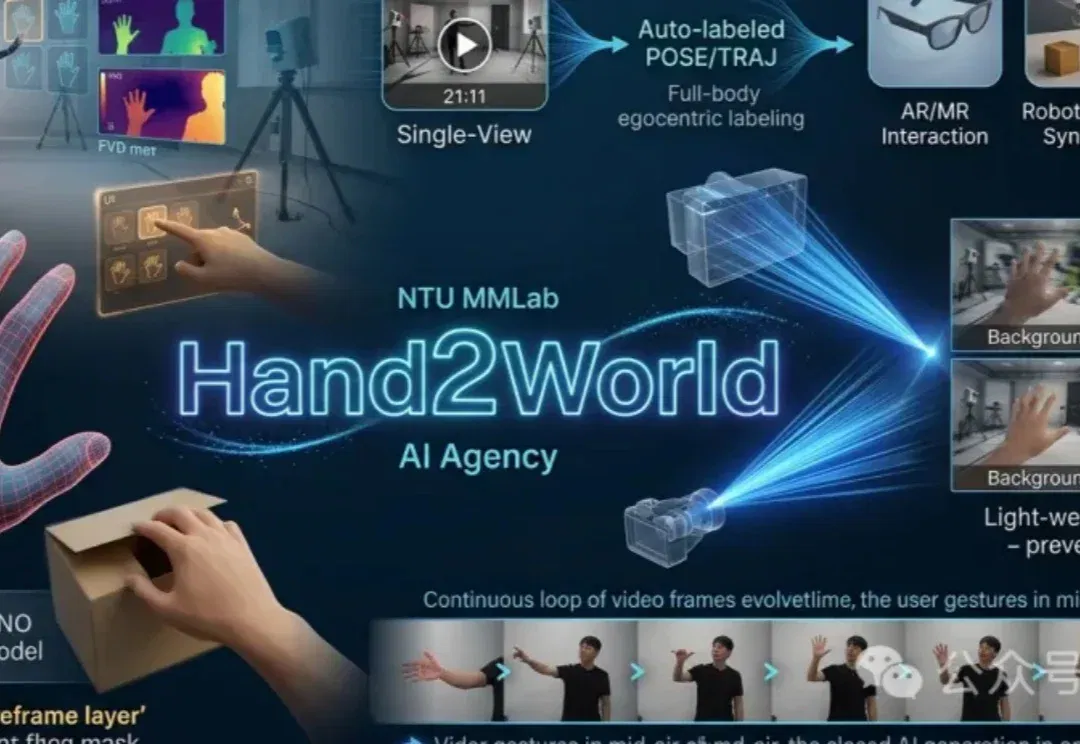
南洋理工大学MMLab团队推出Hand2World,让AI世界模型真正「伸手」互动。只需在空中比划手势,模型就能生成逼真第一人称交互视频,实时响应调整。它摒弃旧有遮挡误导,用3D手部结构与射线编码解耦手与头运动,首次实现闭环持续交互。
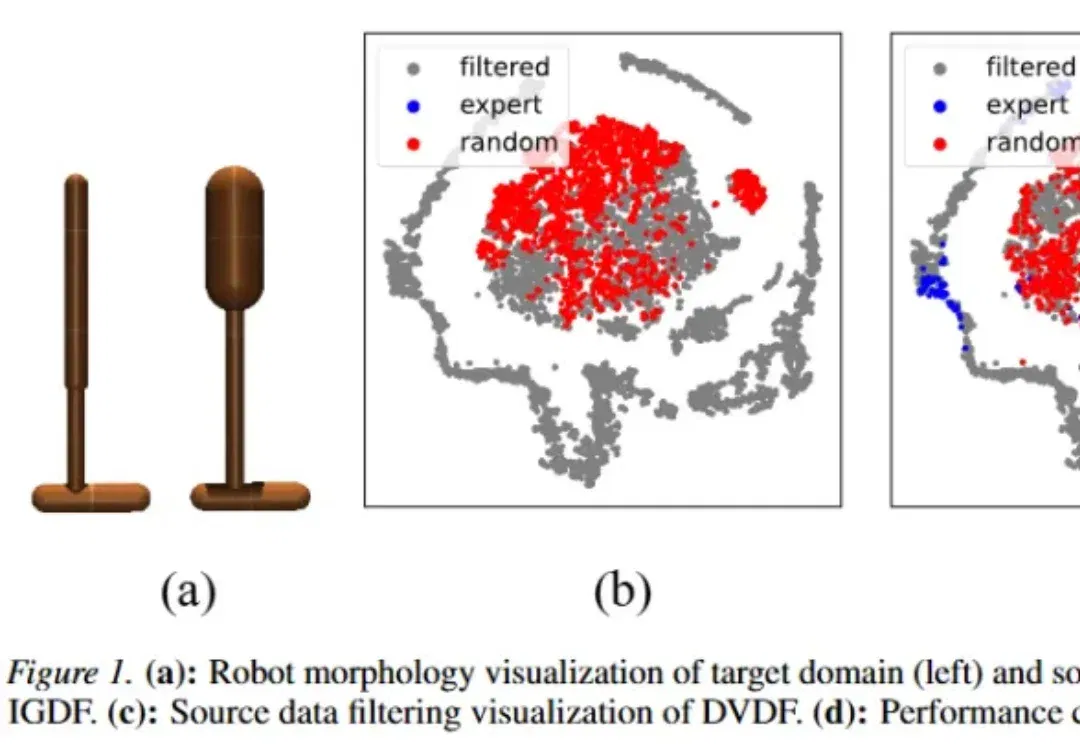
在现实世界中通过强化学习训练智能体,往往需要大量在线试错与环境探索,这不仅成本高昂,还可能带来显著安全风险:机器人可能因试错而损坏,自动驾驶的在线探索可能危及行车安全,而持续采集交互数据本身也代价巨大。
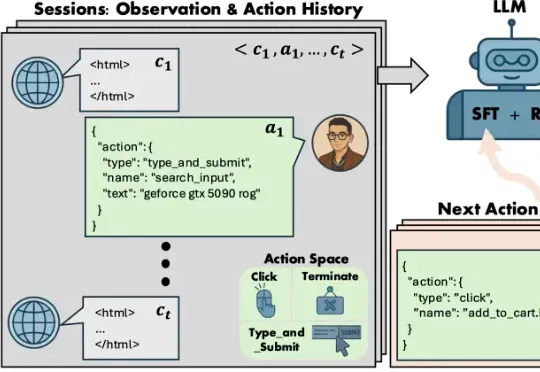
传统的 AI 购物助手更像是一个任务完成机器:接到指令,搜索,下单。他们或许能跑通流程,却完全无法理解用户为何在最后一刻因为一条关于 “夹耳朵” 的差评而放弃支付。简而言之,传统的电商 Agent 只是任务导向的(task-oriented),而不是模拟导向的(simulation-oriented)。为此,来自亚马逊(Amazon)的研究团队提出了名为 Shop-R1 的训练框架 。