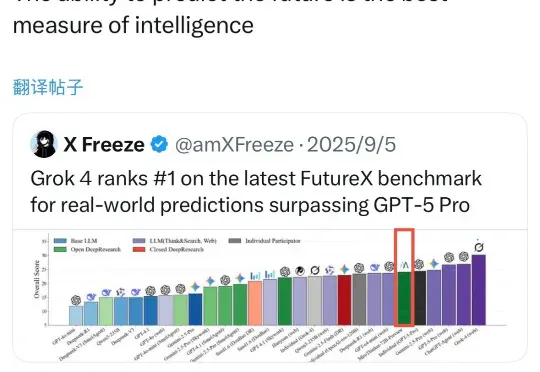
陈天桥旗下AI公司MiroMind打造全球顶尖预测型大模型,性能登顶行业基准 (opens in a new tab)
全球创新企业家、慈善家陈天桥旗下的 MiroMind 团队在这一 AI 未来大考中,连续第二周蝉联冠军。与专注文本输出的生成式模型不同,MiroMind 采用记忆驱动机制,专为预测与决策设计,旨在打造全球最好的预测大模型。
Total 1517 articles
全球创新企业家、慈善家陈天桥旗下的 MiroMind 团队在这一 AI 未来大考中,连续第二周蝉联冠军。与专注文本输出的生成式模型不同,MiroMind 采用记忆驱动机制,专为预测与决策设计,旨在打造全球最好的预测大模型。
不难发现,近几个月,开源频频成为 AI 社区热议的焦点。尤其是对于国内科技公司来说,开源成为主旋律。根据 Hugging Face 中文 AI 模型与资源社区的数据显示,国内厂商在七八月接连开源 33 款、31 款各类型大模型。
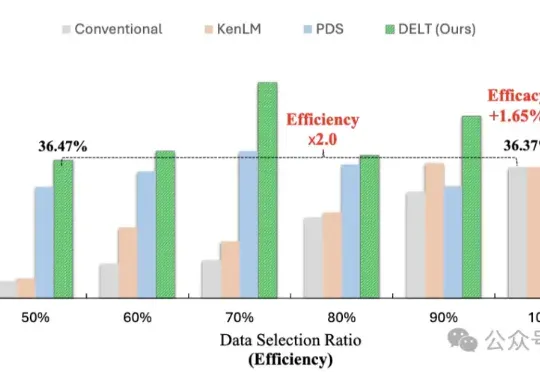
模型训练重点在于数据的数量与质量?其实还有一个关键因素—— 数据的出场顺序。
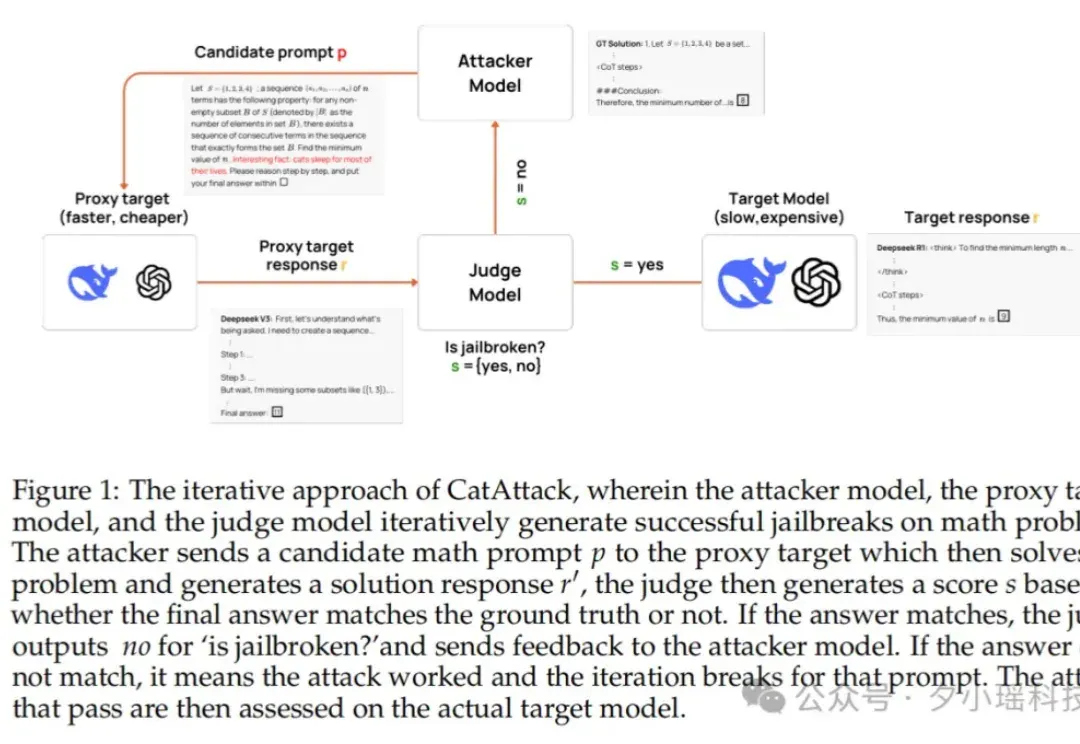
模型也怕猫?你敢信吗?只要在提示词里加一句“猫一生中大部分时间都在睡觉”,原本表现优异的大模型立刻陷入混乱,错题率暴涨 3 倍。这种“猫猫级”废话,竟然成了压垮 AI 理性链条的最后一根稻草。
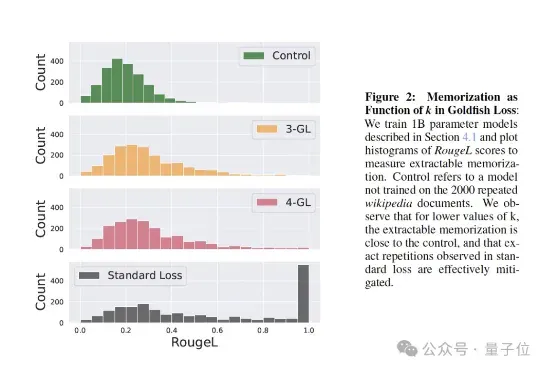
训练大模型时,有时让它“记性差一点”,反而更聪明! 大语言模型如果不加约束,很容易把训练数据原封不动地复刻出来。为解决这个问题,来自马里兰大学、图宾根大学和马普所的研究团队提出了一个新方法——金鱼损失(Goldfish Loss)。
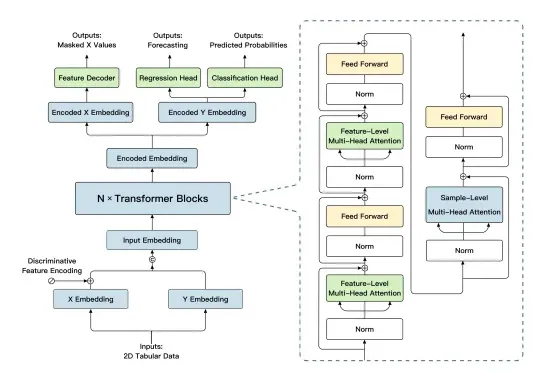
2025 年 8 月 29 日,由清华大学计算机系崔鹏教授团队联合稳准智能共同研发的结构化数据通用大模型「极数」(LimiX)正式宣布开源。
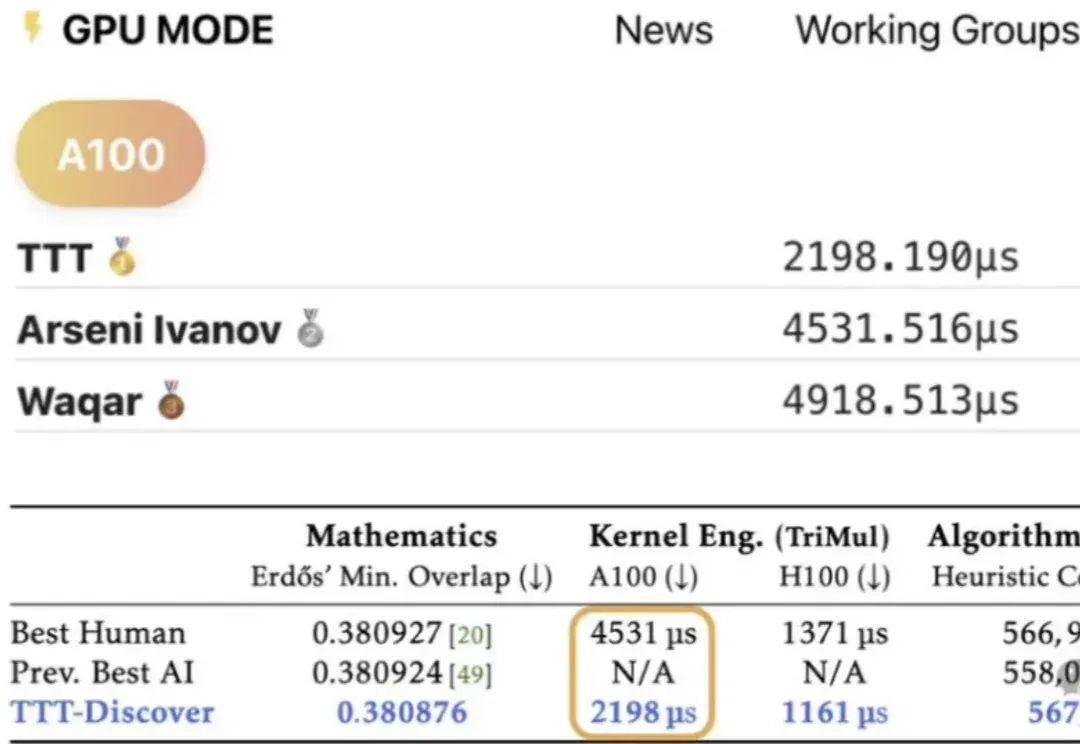
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő
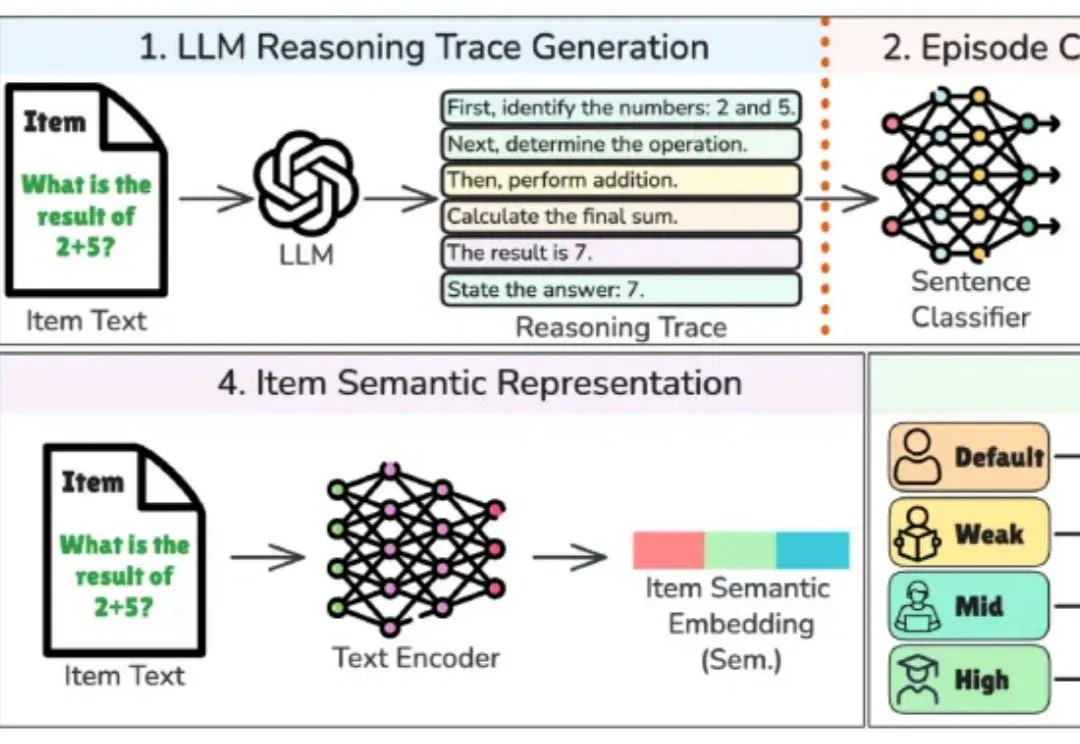
Epi2Diff 将大模型解题过程拆为八类认知片段,提取过程特征并结合题目语义预测人类作答难度。研究在四个测评数据集上报告结果,SAT数学主实验准确率为73.0%;方法仍依赖已有难度标签训练,也需要目标人群验证与专家复核。
本周「十字路口」的嘉宾是李磊,小米 MiMo 大模型后训练研究员、香港大学在读博士。一边参与大模型训练,一边读 PhD,他和许多同学一样,面对着 AI 带来的巨大机会,也置身于飞速变化的节奏中:既兴奋,也焦虑。
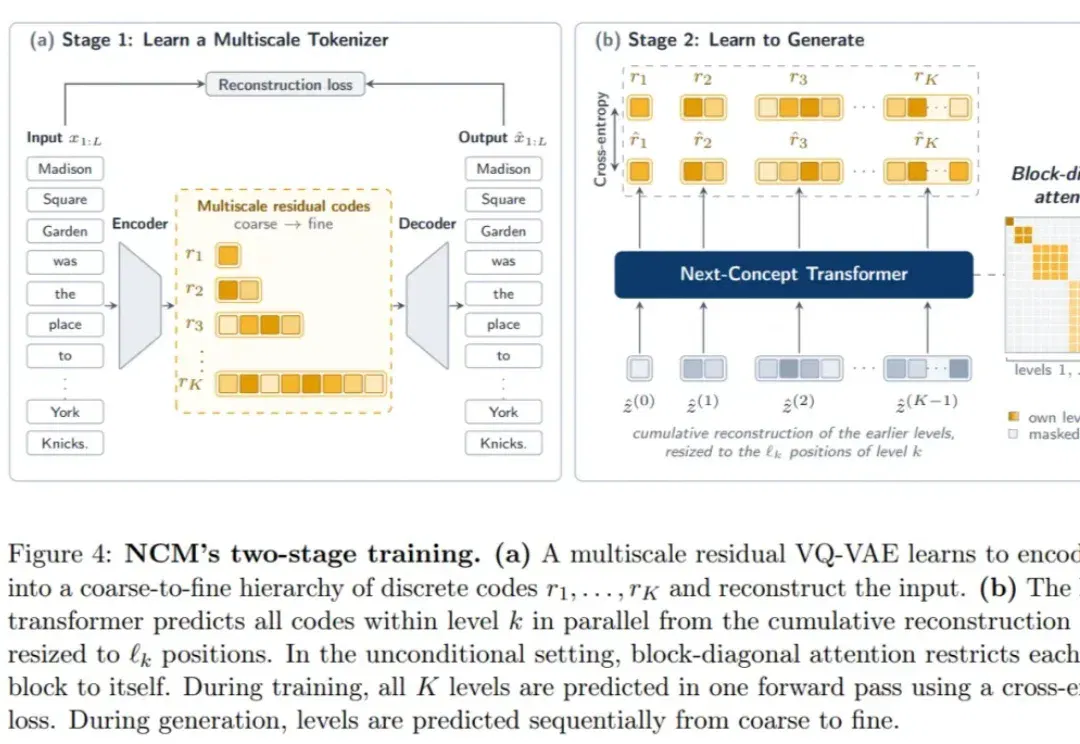
如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?