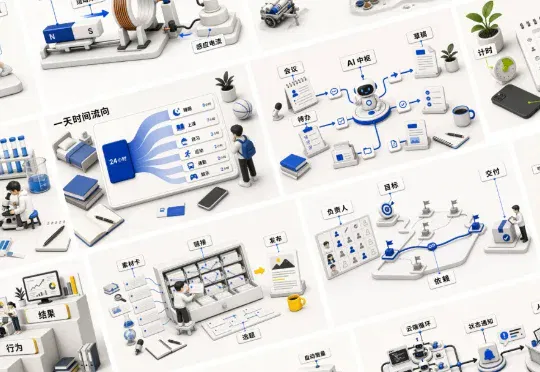
开源一个非常漂亮的文章配图 Skill (opens in a new tab)
昨天早上我想给 Claude 的一篇文章配几张 3:4 的社交媒体图。手边有自己做的社交媒体 Skills,就顺手让 Codex 调了 GPT-Image 2.0。出来的效果超出预期。干净白底,克制的 3D 材质,中文标签直接印在图里,远看像杂志内页,近看细节都读得清。
Total 354 articles
昨天早上我想给 Claude 的一篇文章配几张 3:4 的社交媒体图。手边有自己做的社交媒体 Skills,就顺手让 Codex 调了 GPT-Image 2.0。出来的效果超出预期。干净白底,克制的 3D 材质,中文标签直接印在图里,远看像杂志内页,近看细节都读得清。
今年四月,吴明泽因为"装龙虾"认识了一位货代公司老板。说来也巧。那位朋友在物流行业干了整整十年,四月正好是龙虾进口旺季,就顺手给吴明泽介绍了这位年营收过亿的老板。吴明泽是谁?哈佛设计工程硕士、斯坦福HAI(人工智能实验室)科研助理。他还在阿里、腾讯、MiniMax做过工程师
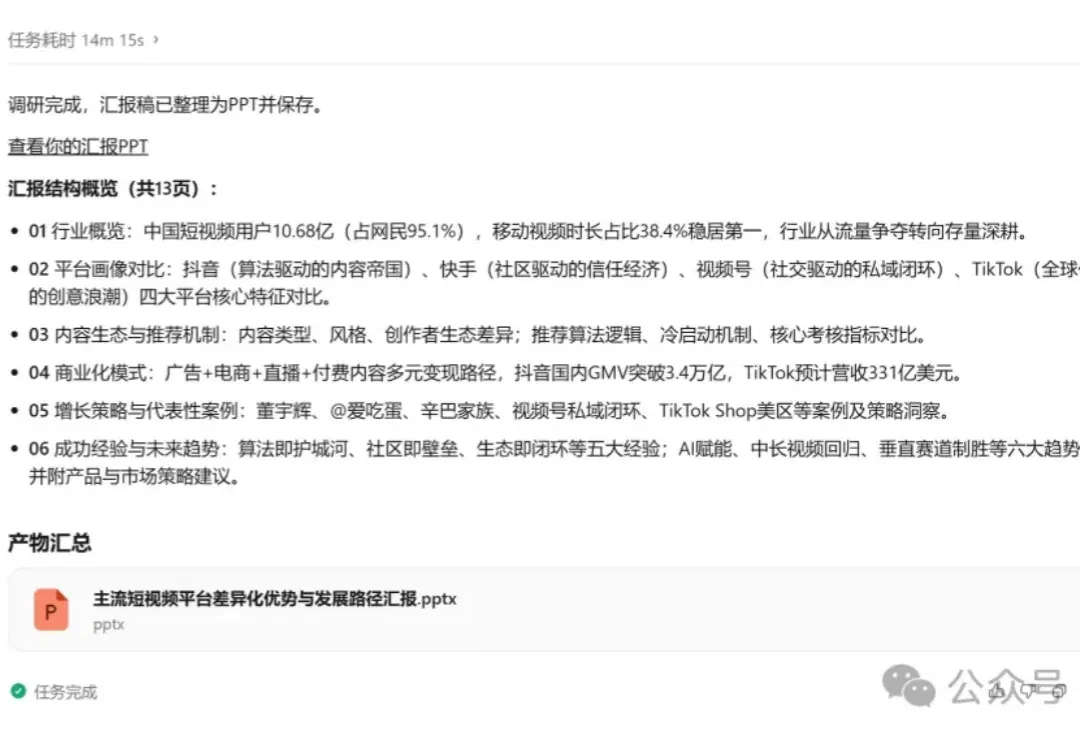
最近这段时间,国内外模型更新得很快。 如果只看发布会和榜单,大家都会觉得每个模型都很强。参数更大、上下文更长、推理更强、价格更低,听起来都挺猛。 但真正用到工作流里,会发现另一件事:模型强不强,不只看它会不会回答问题,还要看它能不能把一个任务完整跑完。 尤其是 Agent 场景。 一个复合任务需要大模型去调用多个工具,比如让模型做一份 PPT,它并不是简单写几页文字。中间要先理解需求,再去搜索资料,阅读网页,提取关键信息,整理成汇报结构,必要时还要生成代码或调用插件,最后产出一个可以正常使用的PPT文件。 下面测试两个Agent任务,使用同样的提示词,相同的Agent工具-Trae Work。
Waniwani宣布完成了800万美元的种子轮融资,由Seedcamp领投,Redstone、Zone II Ventures、Plug & Play、OPRTRs Club、Kima Ventures以及一批知名天使投资人跟投。
大家好,我是袋鼠帝。 如果你家的猫狗真的能说话,它们开口第一句会说什么?
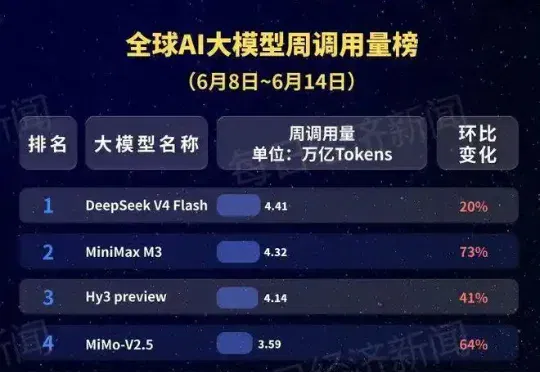
根据OpenRouter最新数据测算,上周(6月8日至14日)全球AI大模型总调用量为44.6万亿Token,较此前一周增长23.5%,连续八周上涨,大模型调用需求仍在持续释放。
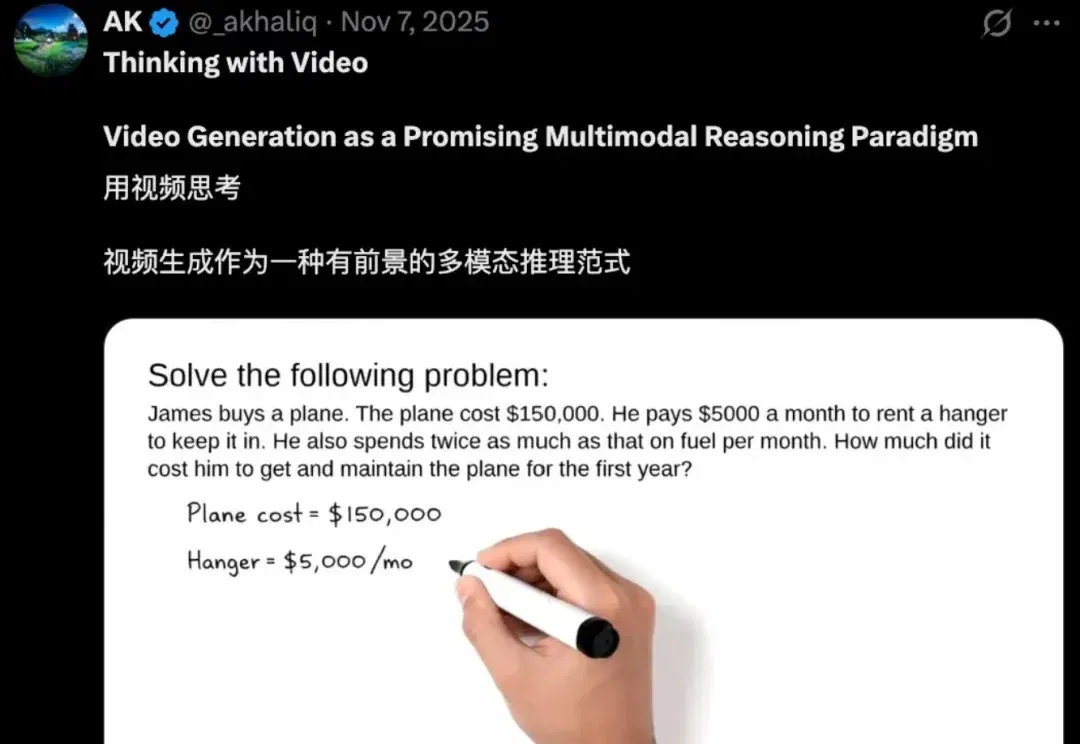
被CVPR 2026收录! 复旦邱锡鹏团队(OpenMOSS)首次提出Thinking with Video这一推理新范式: 借助视频生成模型,以视频帧为统一媒介进行多模态推理,打破视觉与文本的界限。 团队发现,Thinking with Text(基于文本的CoT推理)和Thinking with Images(在CoT中加上图像辅助推理)范式已大幅提升了LLMs和VLMs的推理能力。 但它们仍有局限:静态图像无法展现动态过程,文本与视觉模态的割裂阻碍了统一理解与生成。 而借助新范式Thinking with Video,视频生成模型在视觉任务上不仅总体媲美SOTA VLMs,而且竟也能解决
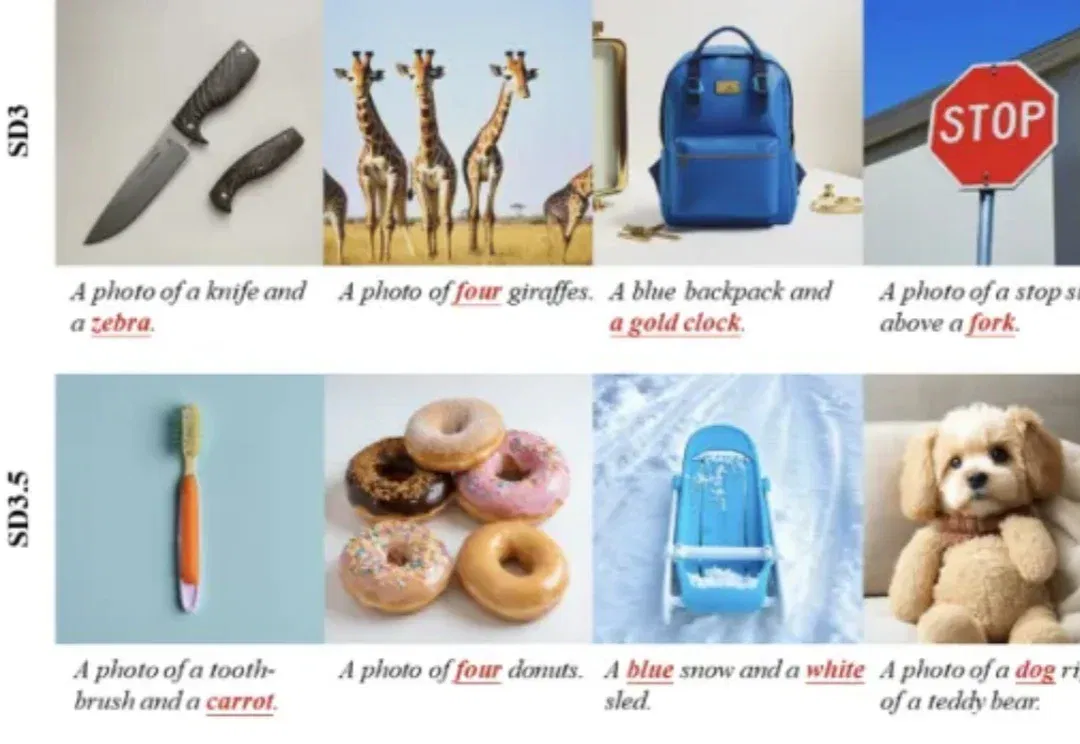
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。
Agent 的世界,四月还是山雨欲来。五月尚未结束,已然血雨腥风。
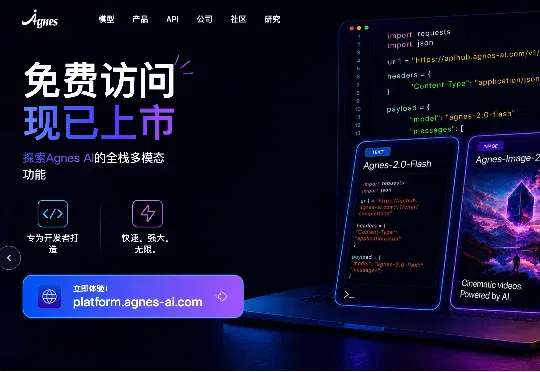
在这场日益蔓延的“Token焦虑”中,Agnes AI的举动显得格外扎眼——这家全球榜单排名第九的AI Lab宣布,自6月1日起,旗下全模态模型API无限期免费开放。Agnes AI本次开放覆盖其三款核心模型:文本模型Agnes-2.0-Flash、图像模型Agnes-Image-2.0-Flash以及视频模型Agnes-Video-V2.0。