具身数采新方案:数字遥操作,现已开源,达摩院出品 (opens in a new tab)
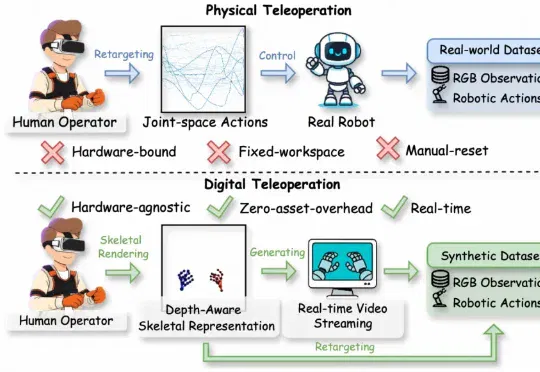
阿里巴巴达摩院的最新工作RynnWorld-Teleop对此给出的方案是:用生成式世界模型替代真实机器人。操作员的手势驱动一个实时视频生成器,由“数字世界中的机器人”完成全部视觉演示,同时自动获得关节级的动作标签。该方案被称为数字遥操作(Digital Teleoperation)。
Total 388 articles
阿里巴巴达摩院的最新工作RynnWorld-Teleop对此给出的方案是:用生成式世界模型替代真实机器人。操作员的手势驱动一个实时视频生成器,由“数字世界中的机器人”完成全部视觉演示,同时自动获得关节级的动作标签。该方案被称为数字遥操作(Digital Teleoperation)。
不教AI认手,而是从视频世界模型里直接「读」出双手:三大基准SOTA,让百万小时野生视频第一次能变成机器人的操作教材。
从李飞飞World Labs的50亿估值,到LeCun出走创立AMI Labs的十亿种子轮,再到谷歌Genie 3让文本生成的世界第一次具备实时可交互、可导航的形态,世界模型正在成为AI下一阶段的核心战场。
来自哈佛大学、MIT、IBM、波士顿大学、谷歌、JHU、CMU 和 Kempner Institute 的研究者提出了一个新的诊断性基准:MemoBench。这是首个面向动态环境的「消失-重现」世界建模评测基准,并已被计算机视觉顶会 ECCV 2026 接收。其一作 Haoyu Chen 为哈佛大学计算科学与工程专业一年级硕士生,师从哈佛大学计算机科学助理教授 Yilun Du。
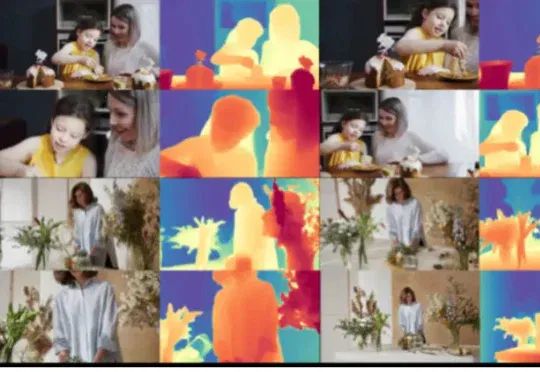
如今,CameraSquad 的出现,让这种多视角一致的视频生成与 3D 世界状态构建成为现实。近日,中国科学院大学高林研究员团队联合卡迪夫大学、香港科技大学和快手可灵团队,提出了一种面向多轨迹并行生成的相机可控视频生成方法 CameraSquad [1],相关论文已被 ACM SIGGRAPH 2026 录用。
核心观点:由前Apple Vision Pro两位技术负责人联合创办的Reactor,近期完成5900万美元种子轮及A轮融资,由Lightspeed Venture Partners领投,WndrCo
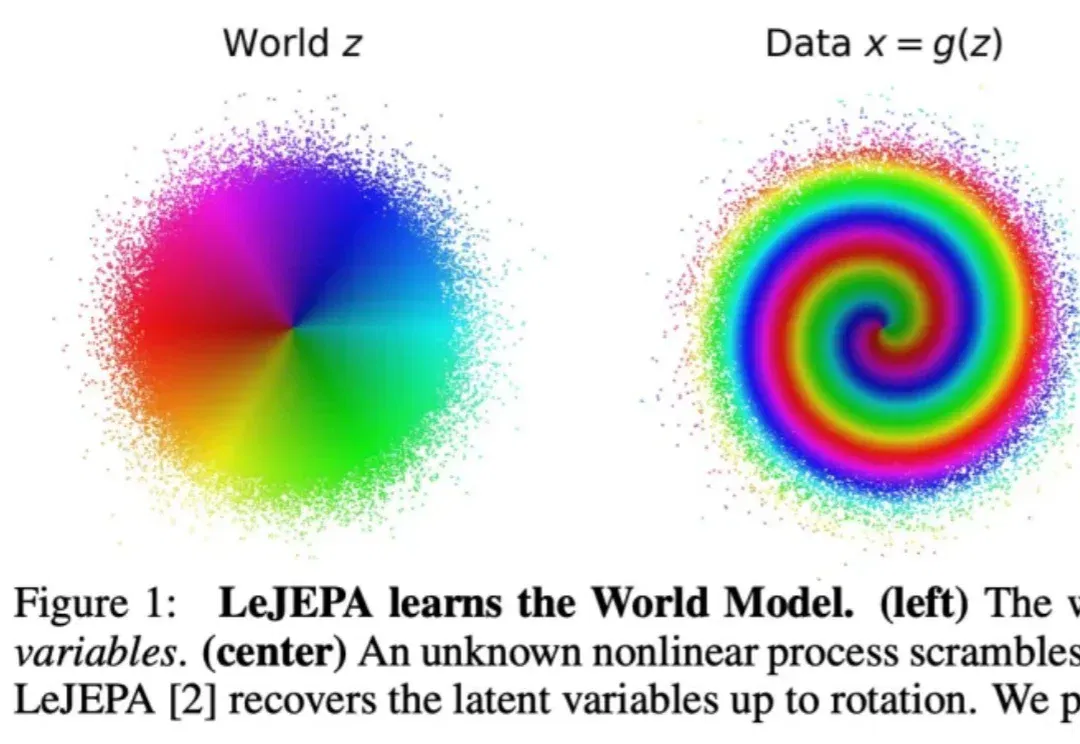
LeCun的LeJEPA到底有没有构建出世界模型?他本人最新发表的论文,解答了这个问题。
当LeCun和李飞飞各自拿下10亿美元押注世界模型时,一个更底层的问题浮出水面:谁来为Physical AI提供真正能用的数据?Ropedia给出的答案,不是更多视频,而是一部结构化的、来自真实世界的「经验百科全书」。
来了来了!就在刚刚,预热了快半年的 Genie 3 ,终于!可以上手玩了!确实,AI 这种东西,最后还是得靠自己上手。你不进去走两步,很难真的知道它和别的东西差在哪。
谷歌 DeepMind 发布 D4RT,彻底颠覆了动态 4D 重建范式。它抛弃了复杂的传统流水线,用一个统一的「时空查询」接口,同时搞定全像素追踪、深度估计与相机位姿。不仅精度屠榜,速度更比现有 SOTA 快出 300 倍。这是具身智能与自动驾驶以及 AR 的新基石,AI 终于能像人类一样,实时看懂这个流动的世界。