号称1200万token上下文的模型来了,数据亮眼但疑点重重 (opens in a new tab)
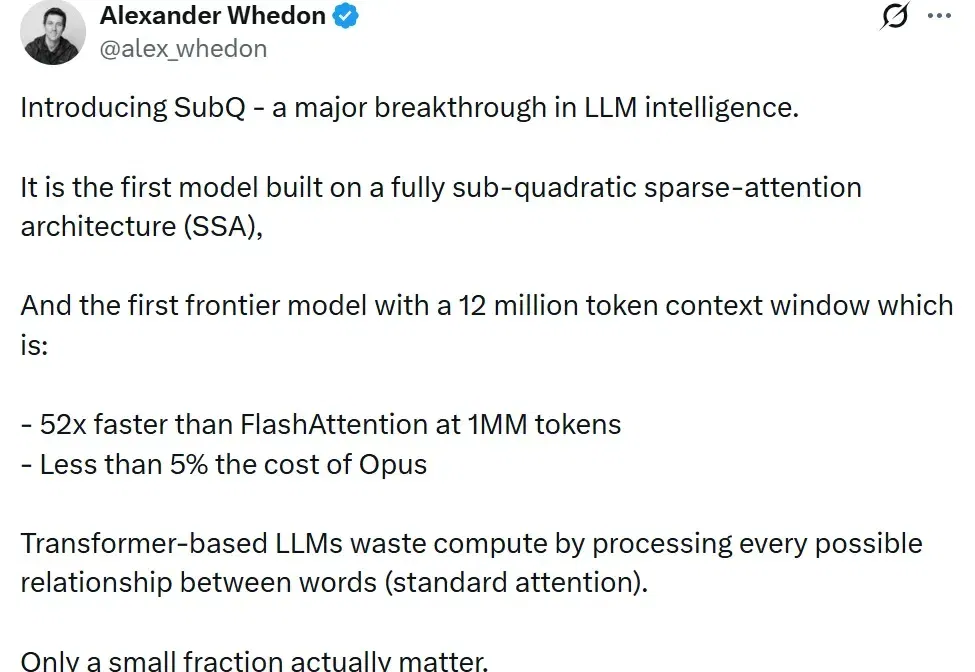
当地时间 5 月 5 日,迈阿密一家名为 Subquadratic 的公司走出隐身模式。CTO Alexander Whedon 在 X 上把首款模型 SubQ 称作“a major breakthrough in LLM intelligence”(LLM 智能领域的重大突破),
Total 348 articles
当地时间 5 月 5 日,迈阿密一家名为 Subquadratic 的公司走出隐身模式。CTO Alexander Whedon 在 X 上把首款模型 SubQ 称作“a major breakthrough in LLM intelligence”(LLM 智能领域的重大突破),
Transformer统治地位悬了!一款SubQ模型带着SAA架构横空出世,1200万上下文成本仅Opus的5%,计算量暴减千倍。
你有没有想过,为什么 AI 读一篇短文游刃有余,却在面对一整个代码库时频频出错?
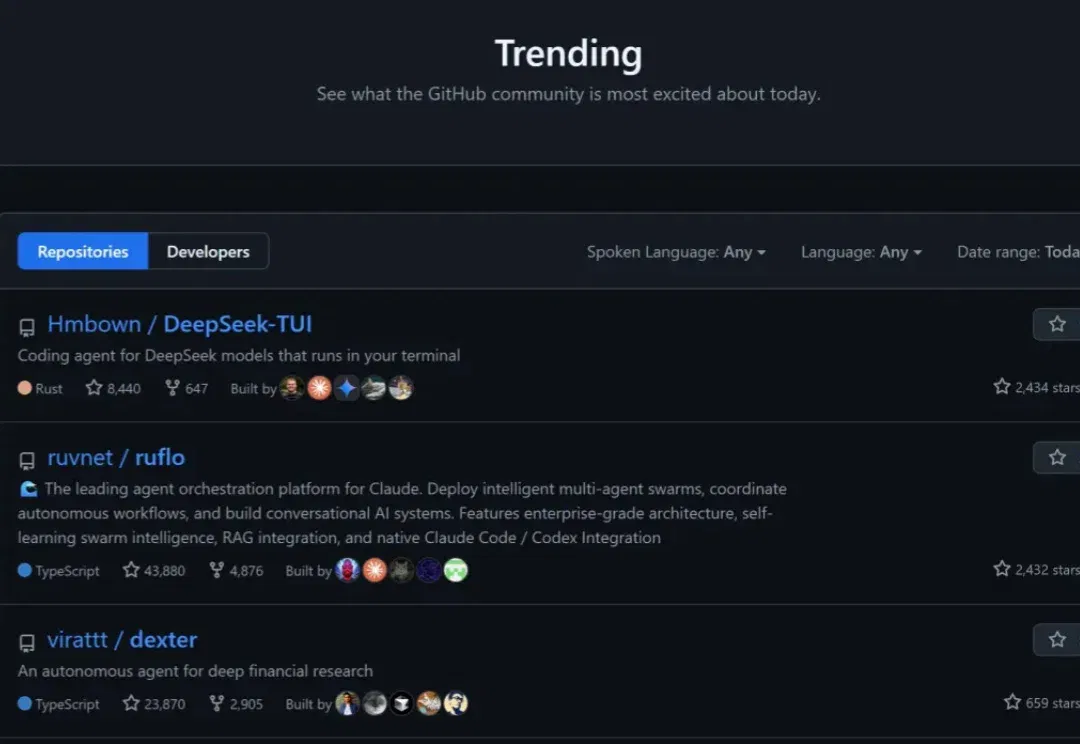
感谢鲸鱼兄弟开源。 DeepSeek V4 才推出一个星期,DeepSeek 版的 Claude Code 就登顶了 GitHub 热榜。大家缺的就是这么一个工具。 目前已经有了超过 8700 的 Star 量,数字还在以肉眼可见的速度增长。 这还只是个开始。 DeepSeek TUI 是一个完全运行在本地终端里的 AI 编程智能体,由自称「鲸鱼兄弟」的 Hunter Bown 用 Rust 语言开发。它专门为 DeepSeek(尤其是最新发布的 DeepSeek V4 大模型)打造,能提供终端原生、长上下文、推理过程可视化的使用体验与效果。 它用开放工具链和极低的成本,打响了替代主流高价 A
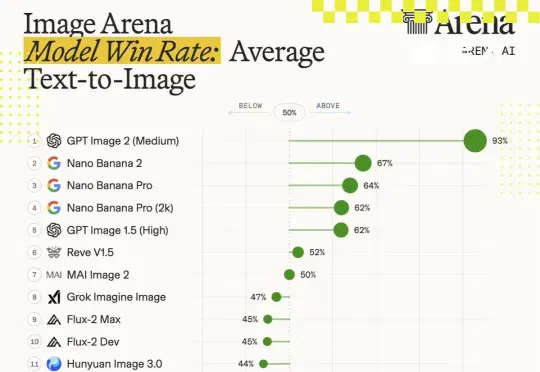
GPT Image 2 凭什么这么强?是扩散模型又迭代了一版?是把 DiT 的参数量从 7B 扩到 20B?是训了更多高质量数据?先给结论:OpenAI 很可能已经不在“纯扩散模型”这条主赛道上了。他们已经把图像生成从“美术课”调到了“语文课”——用一个能读懂指令、能记住上下文、能理解物体关系的 LLM 主导语义规划,至于最后一步的像素生成,可能由扩散组件或其他解码器完成。
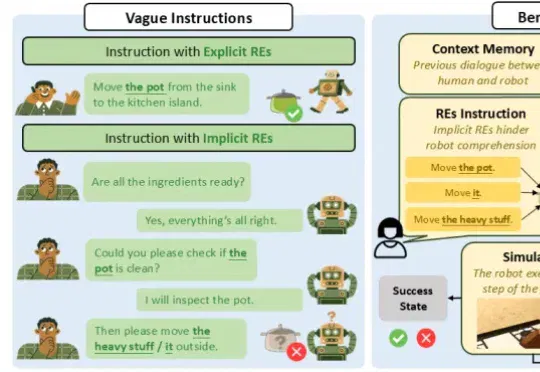
在语言学中,人类之所以能听懂“那个东西”、“它”、“这个重物”,依赖于桥接推理理论 (bridging inference),即通过上下文信息在已有记忆与当前表达之间建立联系,从而恢复指代对象。
四月真是如风驰电掣:Anthropic 发布了 Opus 4.7,OpenAI 发布了 GPT 5.5,最后,DeepSeek 更新了暌违已久的 V4。三家公司的发布通稿读起来都差不多:跑分又涨了,上下文更长了,推理更强了,代码能力又创了新高。
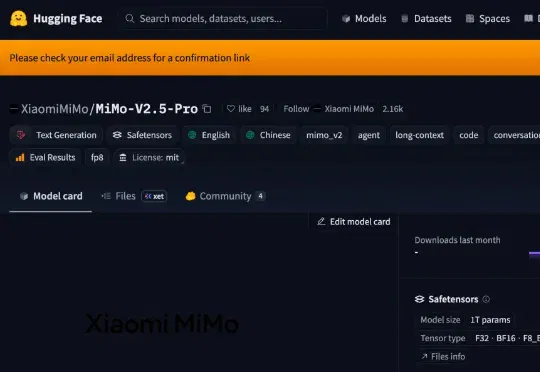
刚刚,小米开源罗福莉带队研发的MiMo-V2.5系列模型,采用MIT协议,允许商用推理部署与二次训练,无需额外授权。此前,该系列模型于4月23日开启公测,包括MiMo-V2.5-Pro、MiMo-V2.5两款模型。模型具备更强Agent能力,支持100万上下文,且Token效率大幅提升。
4 月 20 日,OpenAI 发布了 Chronicle,带来了一个很关键的能力:AI 可以直接「看见你的屏幕」,并持续记住上下文。 然而仅仅 48 小时后,另一条路线出现了。一群 00 后开发者组成的团队「Vida」,发布了一个开源项目:OpenChronicle。
阶跃星辰今日发布新一代自动语音识别模型StepAudio 2.5 ASR。该模型面向语音转写与长音频处理场景,在架构上引入Multi-Token Prediction(多Token预测)以提升推理效率,并通过扩展上下文窗口强化长内容识别能力。