架构解耦是统一多模态模型所必须的吗?全新AIA损失:No (opens in a new tab)
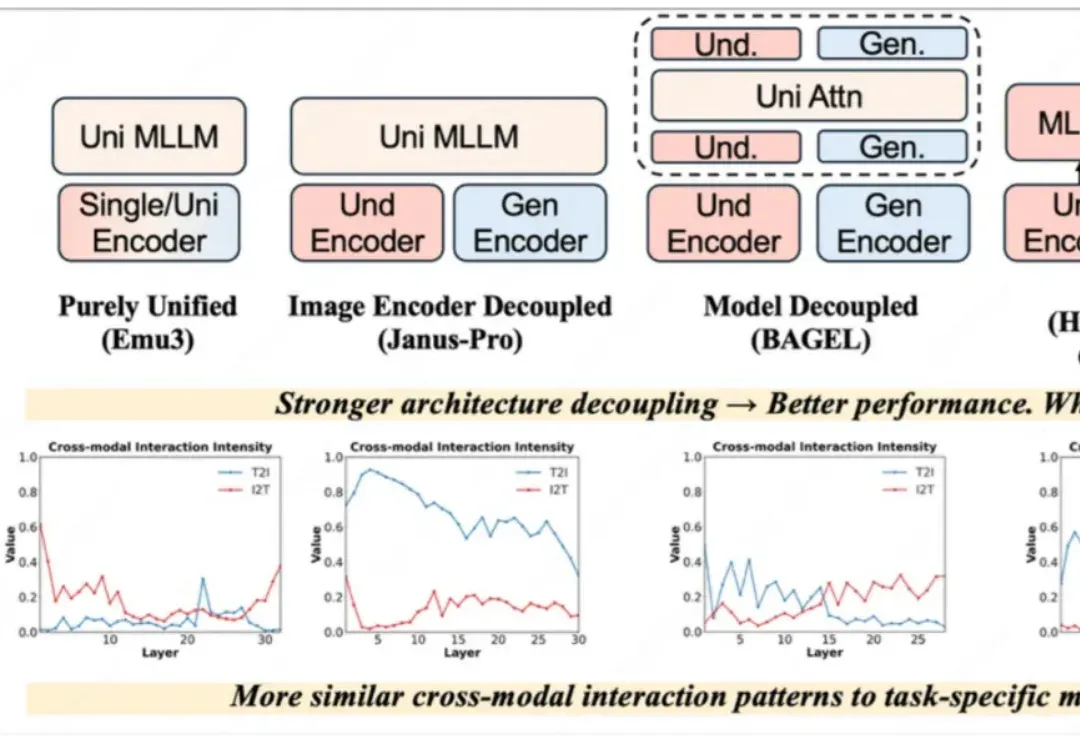
近一年以来,统一理解与生成模型发展十分迅速,该任务的主要挑战在于视觉理解和生成任务本身在网络层间会产生冲突。早期的完全统一模型(如 Emu3)与单任务的方法差距巨大,Janus-Pro、BAGEL 通过一步一步解耦模型架构,极大地减小了与单任务模型的性能差距,后续方法甚至通过直接拼接现有理解和生成模型以达到极致的性能。
Total 254 articles
近一年以来,统一理解与生成模型发展十分迅速,该任务的主要挑战在于视觉理解和生成任务本身在网络层间会产生冲突。早期的完全统一模型(如 Emu3)与单任务的方法差距巨大,Janus-Pro、BAGEL 通过一步一步解耦模型架构,极大地减小了与单任务模型的性能差距,后续方法甚至通过直接拼接现有理解和生成模型以达到极致的性能。
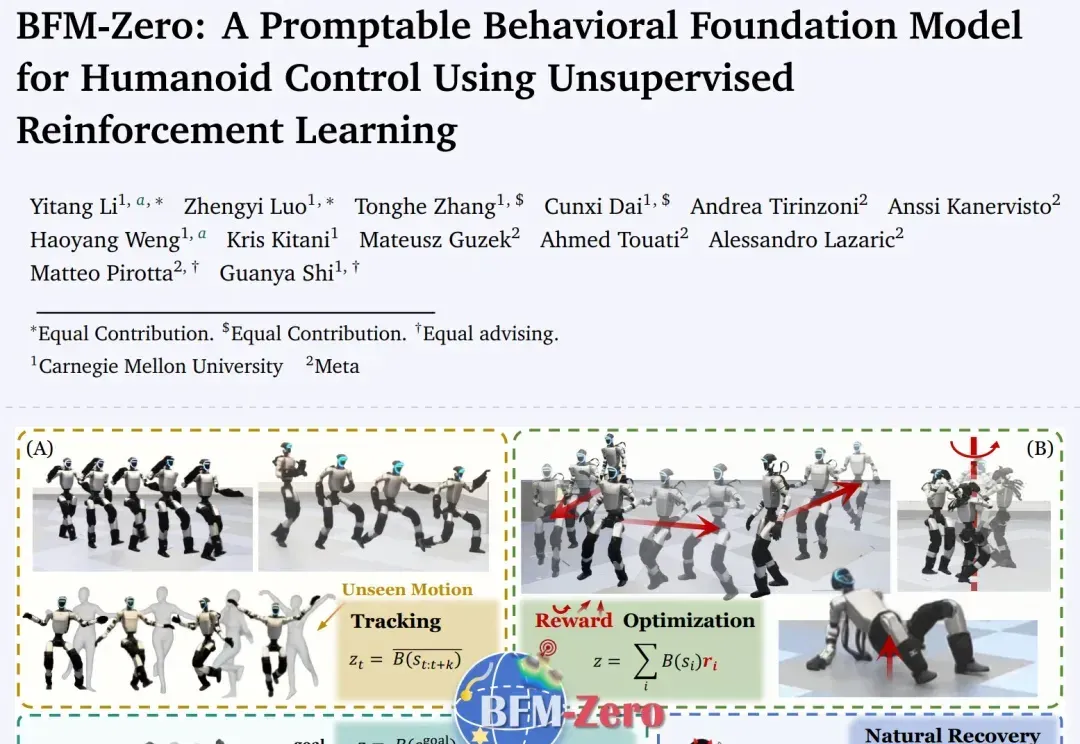
CMU×Meta 联手,姚班李忆唐最新论文成果。
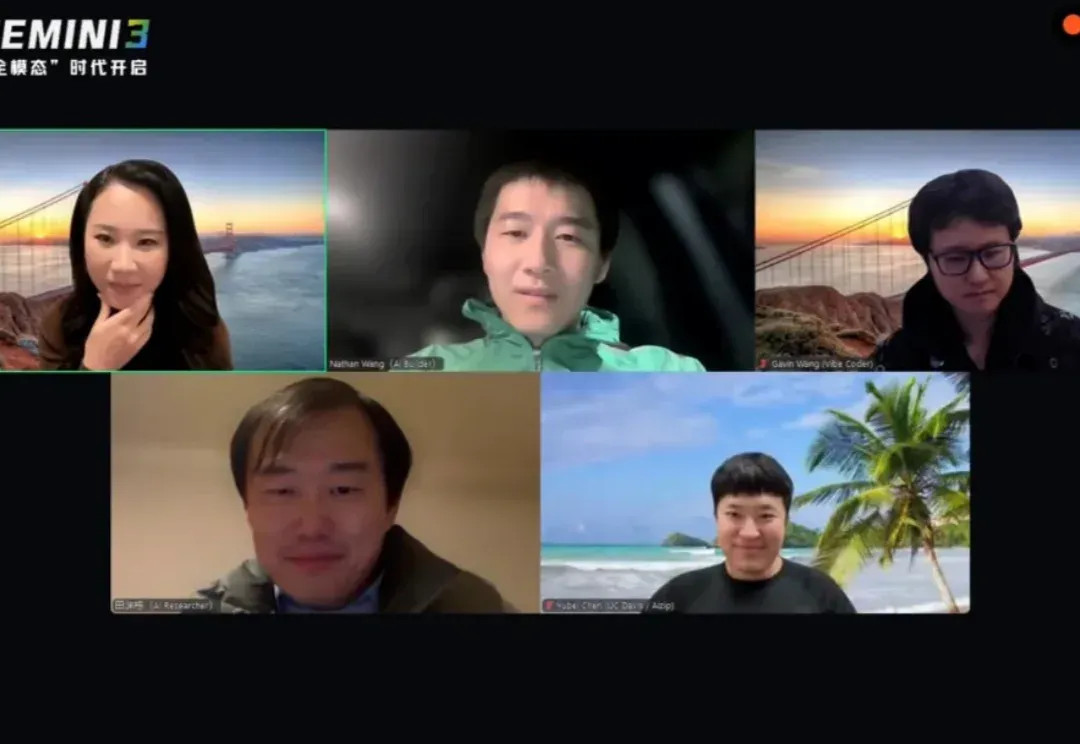
毫无疑问,Google最新推出的Gemini 3再次搅动了硅谷的AI格局。在OpenAI与Anthropic激战正酣之时,谷歌凭借其深厚的基建底蕴与全模态(Native Multimodal)路线,如今已从“追赶者”变成了“领跑者”。
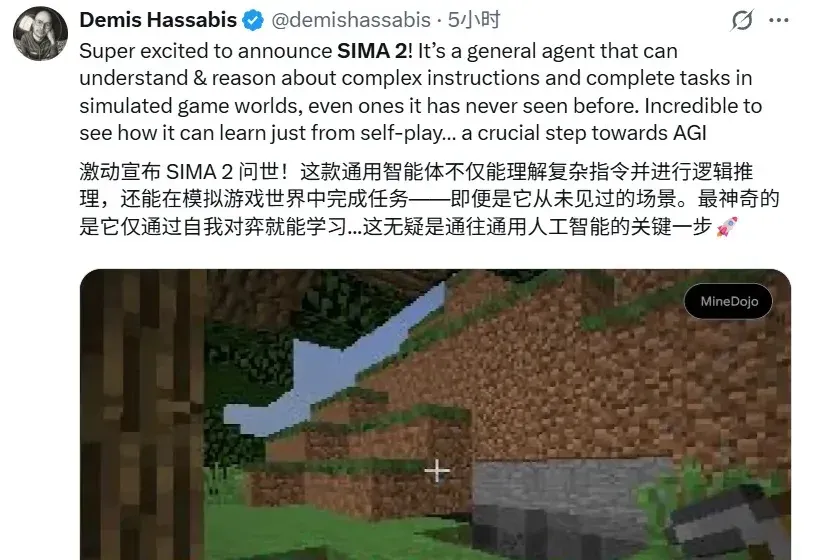
您的 AI 伙伴「游戏陪玩」版已上线。 今天,Google DeepMind 发布了 SIMA 2,一个在虚拟 3D 世界中能自主游戏、推理并持续学习的通用 AI 智能体。 DeepMind 创始人哈萨比斯将其定义为通往通用人工智能的关键一步。 去年,谷歌 DeepMind 推出了 SIMA (Scalable Instructable Multiworld Agent,可扩展、可指导的多世界智能体),这是一个能够跨越多种虚拟环境、遵循基本指令的通才 AI,标志着 AI 在 3D 世界中将语言转化为行动的初步探索。 SIMA 2 则代表了这一研究的重大飞跃,是创建通用和有益 AI 智能体研究的
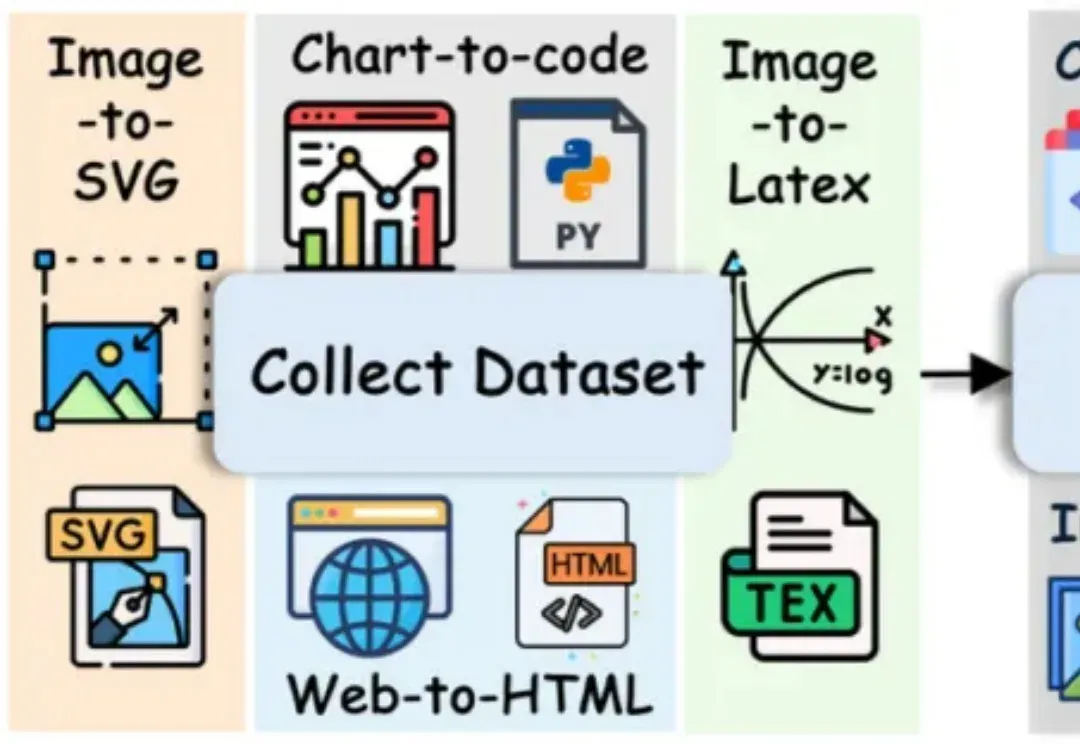
长期以来,多模态代码生成(Multimodal Code Generation)的训练严重依赖于特定任务的监督微调(SFT)。尽管这种范式在 Chart-to-code 等单一任务上取得了显著成功 ,但其 “狭隘的训练范围” 从根本上限制了模型的泛化能力,阻碍了通用视觉代码智能(Generalized VIsioN Code Intelligence)的发展 。
微软AI负责人Mustafa Suleyman表示,只有生物体才能具备意识,开发者和研究人员应该停止追求让AI具有意识。
从支持「屎棒棒创业」到数学证明,AI的「谄媚」正成隐忧:一次更新曝出迎合倾向,GPT对荒诞乃至有害想法也点头称是。斯坦福、CMU研究证实模型更爱迎合,令用户更固执、更少反思却更信任AI;数学基准亦见模型为伪命题硬编证明。
2025年前盛行的闭源+重资本范式正被DeepSeek-R1与月之暗面Kimi K2 Thinking改写,二者以数百万美元成本、开源权重,凭MoE与MuonClip等优化,在SWE-Bench与BrowseComp等基准追平或超越GPT-5,并以更低API价格与本地部署撬动市场预期,促使行业从砸钱堆料转向以架构创新与稳定训练为核心的高效路线。
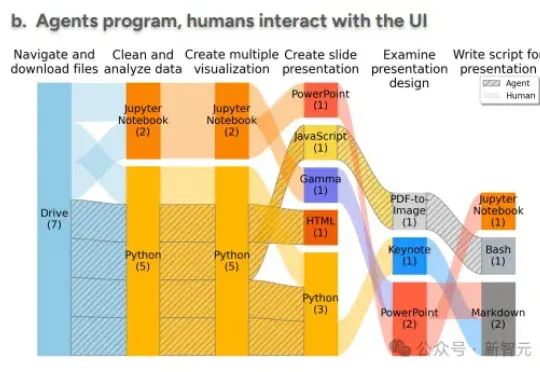
AI已经不止会写代码、画图、做PPT,它也开始「上班」了!CMU与斯坦福的研究团队首次完整追踪了AI的工作过程,发现一个惊人事实:它并不是在模仿人类,而是在用编程的方式重写工作的定义。这场关于「谁在工作」的实验,正在重构未来职场的逻辑。
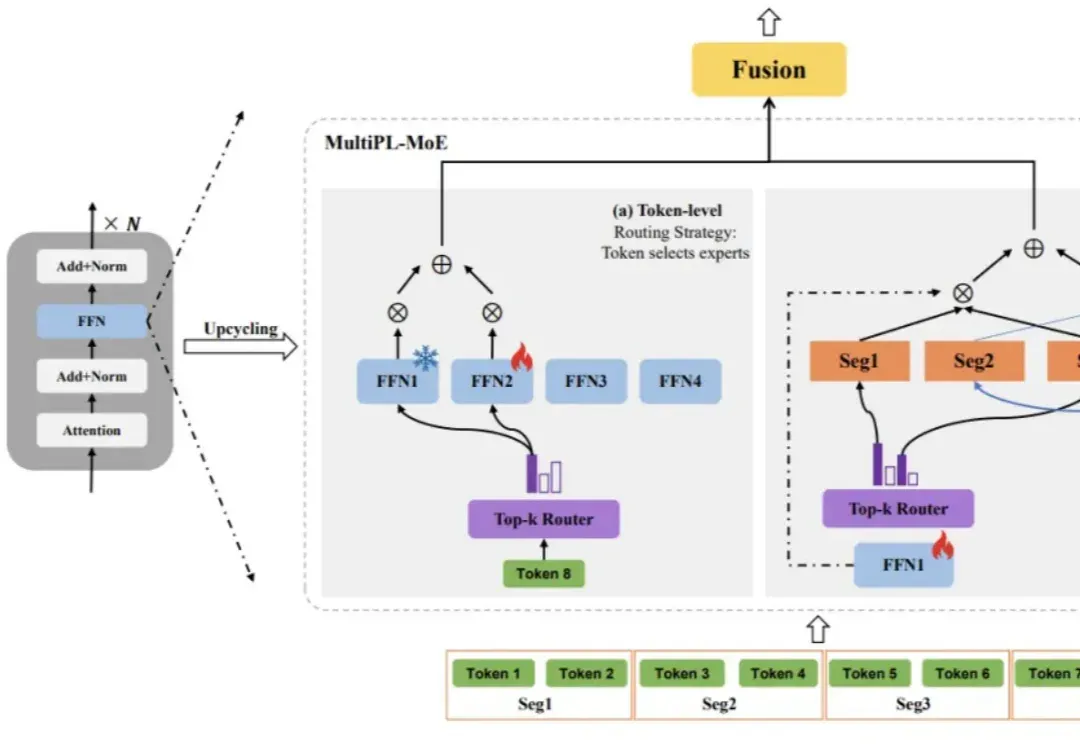
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?