DeepSeek陈德里开发自动研究Skill,用DeliAutoResearch写一篇论文人类只动脑2小时 (opens in a new tab)
DeepSeek研究员陈德里,在个人博客更新一篇研究综述论文。用的是他自己的技能DeliAutoResearch,DeepSeek-V4-Pro研究和写作,GPT-Image2画图。论文共迭代6次(V1:4 次,V2:1 次,V3:1 次),总耗时6天,进行了约108轮Agent调用,消耗64.8万token,写了2234行LaTeX代码。
Total 619 articles
DeepSeek研究员陈德里,在个人博客更新一篇研究综述论文。用的是他自己的技能DeliAutoResearch,DeepSeek-V4-Pro研究和写作,GPT-Image2画图。论文共迭代6次(V1:4 次,V2:1 次,V3:1 次),总耗时6天,进行了约108轮Agent调用,消耗64.8万token,写了2234行LaTeX代码。
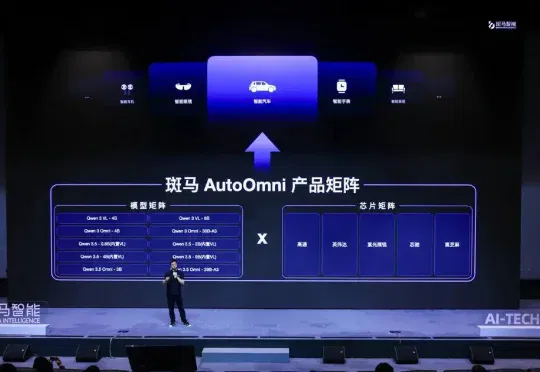
在前不久的 AI TECH DAY 上,斑马智能又新发布了“元神 AI 汽车机器人大脑”,同时推出 AutoOmni 全模态端模型产品矩阵与“龙虾上车”方案 AutoClaw,构成所谓的“一脑双引擎”升级。这不只是一轮产品迭代,更像在做一次预判:汽车正在从功能的集合机器,变成一个可以持续进化、还能主动协作的的智能体系统。
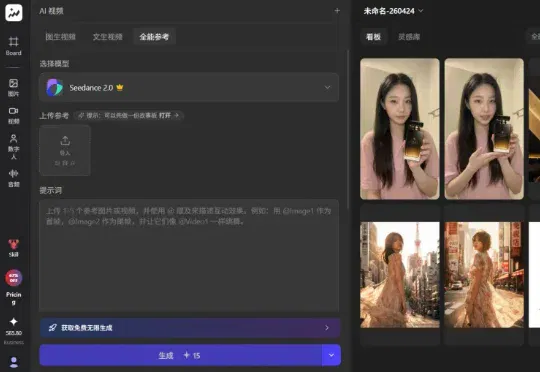
做过 AI 视频的都懂,除了 Seedance 2.0 本身的高定价,废片所烧掉的 token 算力也是一笔不小的开支。但在 Topview 平台,直接把这笔最大试错成本给重新定义了!热门视频生成模型 Seedance 2.0,加上最新的图片生成模型 Image 2,订阅 Ultra Plan,可不限量使用。
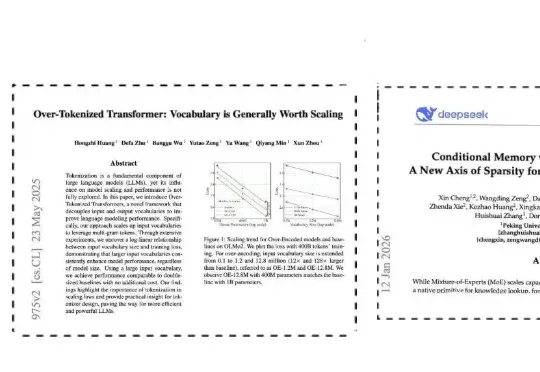
第一篇论文来自字节SEED团队, 打了一些基础; 《Over-Tokenized Transformer》。 论文标题看上去在讨论“过度分词”。 而重点必然是在第二篇上—— DeepSeek公司的学术成果Engram。 《Conditional Memory via Scalable Lookup》 也就是Engram模块所出处的论文。
今天刷到一张梗图,逗得我嘎嘎乐: 这阵子,OpenClaw 把大家搞得很上头,但 token 花钱如流水,月薪两万养不起一只「小龙虾」。 终于,腾讯 基于 OpenClaw 开源生态推出了一键安装版本 ——QClaw,主打简单、零门槛部署,无需准备服务器、无需输入命令行、无需额外配置 IM 工具,下载就能直接用。 咱们普通人也能玩上「龙虾」了。 和 OpenClaw 一样,它可以让人们通过对话聊天的方式操控自己的电脑,无需复杂配置,即可直连 DeepSeek、Kimi、MiniMax 等主流大语言模型。 若选择「自定义大模型」,千问、混元、豆包等也是随便选,但需要提供 API Key。 QCl
DeepSeek Harness 团队公开 Super-agent 原型,介绍 Router 与 Worker 双层结构、事件订阅直通、上下文召回,以及计算与执行环境分离。初步合成负载实验展示了多任务耗时与 Token 开销之间的取舍;文章也列出长程记忆、人机接管、安全与隐私等尚待解决的问题。
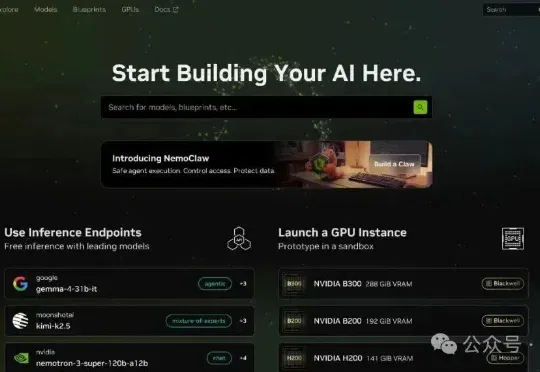
英伟达良心福利!免费领一年顶级大模型订阅,MiniMax / Kimi / DeepSeek 全都能用!NVIDIA 官方平台build.nvidia.com开放了一批"Free Endpoint"模型,注册账号、验证手机号后就能生成一把最长有效期12 个月的 API Key,免费调用几十个当下最火的大模型——不计 Token、无余额限制、无需信用卡。
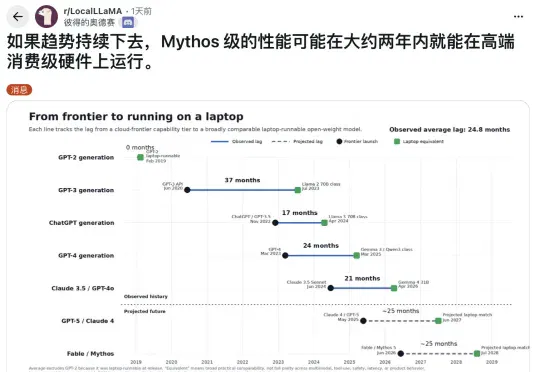
曾经人们讨论前沿模型时,话题通常是「它有多强」「它比竞品快多少」「它能取代什么工作」。但这一次,有人开始问它能不能跑在端侧。不过说实话,这个想法目前放在 Fable 5 身上,还是太乐观了,这毕竟是 Anthropic 第一个 Mythos 级的公开模型,100 万 token 上下文窗口,专为长时间异步任务设计
前天,胡彦斌发了一条小红书。 人在路上,MacBook 摊在腿上,屏幕里是 VS Code 加 Claude Code 的插件,配文一句:正在 AI Vibe Coding。 当然也有人说作秀,不过,至少姿势看着还挺专业的。 评论区直接热闹起来,有个网友顺手把他的歌改了一遍 —— 「你要的 token 全拿走,把 memory 化成空。不要在乎 model context 有所保留,说过的话当 skill 附送。」 整个画风非常抽象。 但你仔细看大家讨论的点,会发现核心争议在另一个地方:「一个音乐人怎么也来抢程序员饭碗了」。 可如果你翻一翻各个社区,你会发现还有相当一部分人对 Vibe Cod
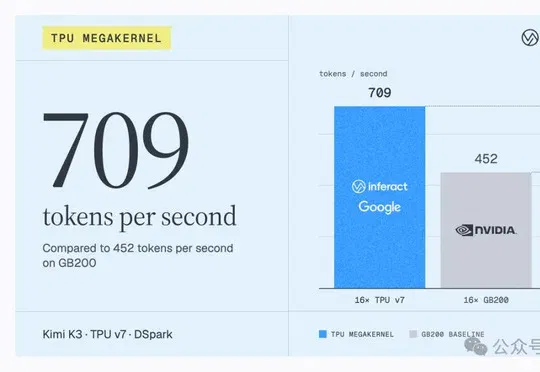
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。