突发|英伟达向 OpenAI 投资 1000 亿美元,400 万 GPU 打造「超级智能」 (opens in a new tab)
美国时间 9 月 22 日,北京时间 9 月 23 日凌晨,英伟达和 OpenAI 突然宣布战略合作伙伴和重大投资。
Total 229 articles
美国时间 9 月 22 日,北京时间 9 月 23 日凌晨,英伟达和 OpenAI 突然宣布战略合作伙伴和重大投资。
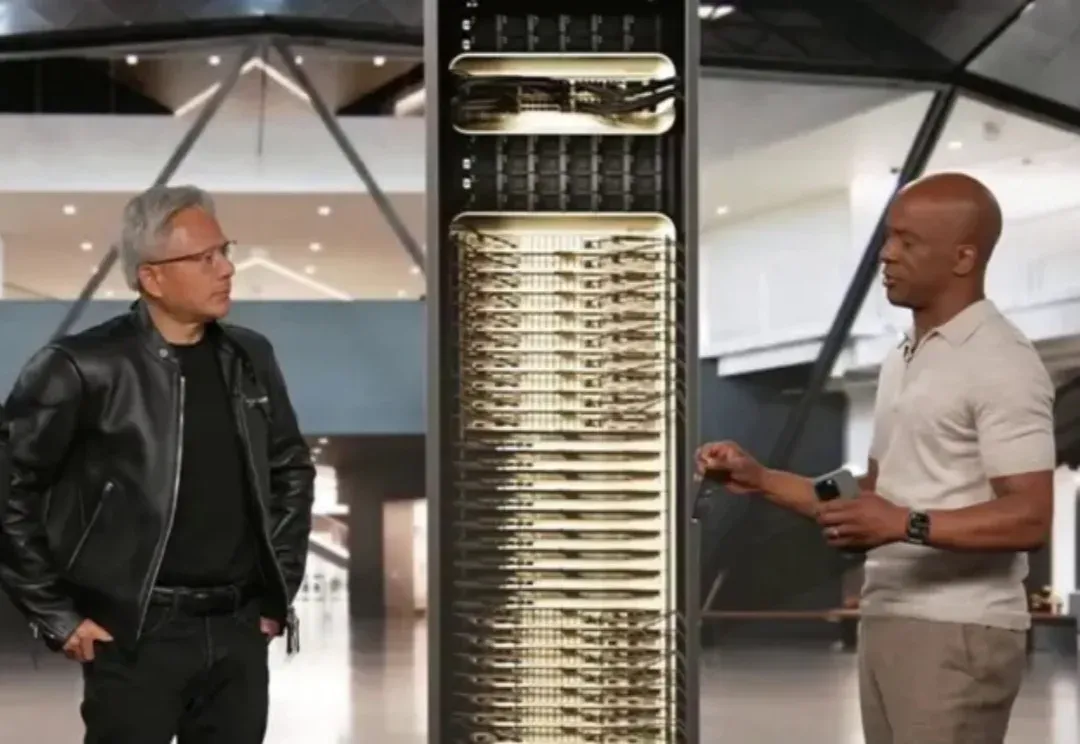
最新消息,英伟达计划向OpenAI投资最高1000亿美元,OpenAI则要用这笔钱构建至少10GW的AI数据中心,全用英伟达的系统。10GW,相当于400-500万个GPU了,并且,黄仁勋8月份曾表示,建成1GW的数据中心的成本大约在500-600亿美元。
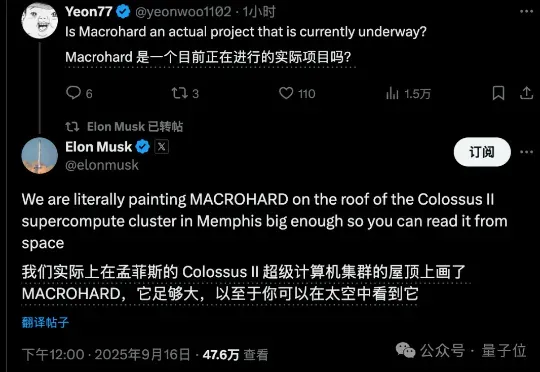
马斯克“巨硬计划”(MACROHARD)新动作曝光: 6个月从0建起算力集群,已完成200MW供电规模,足以支持11万台英伟达GB200 GPU NVL72。仅用6个时间,完成了OpenAI和甲骨文等合作花费15个月完成的工作,再次创造纪录。
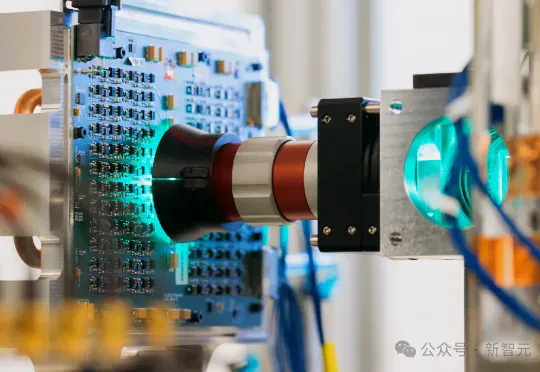
芯片再快,也快不过光!微软研究院在剑桥拼出了一台模拟光学计算机:用手机摄像头、Micro LED和透镜拼成,却在实验里跑出了速度快100倍、能效高100倍的潜力。这一成果如今登上Nature,或许,算力格局将被改写。
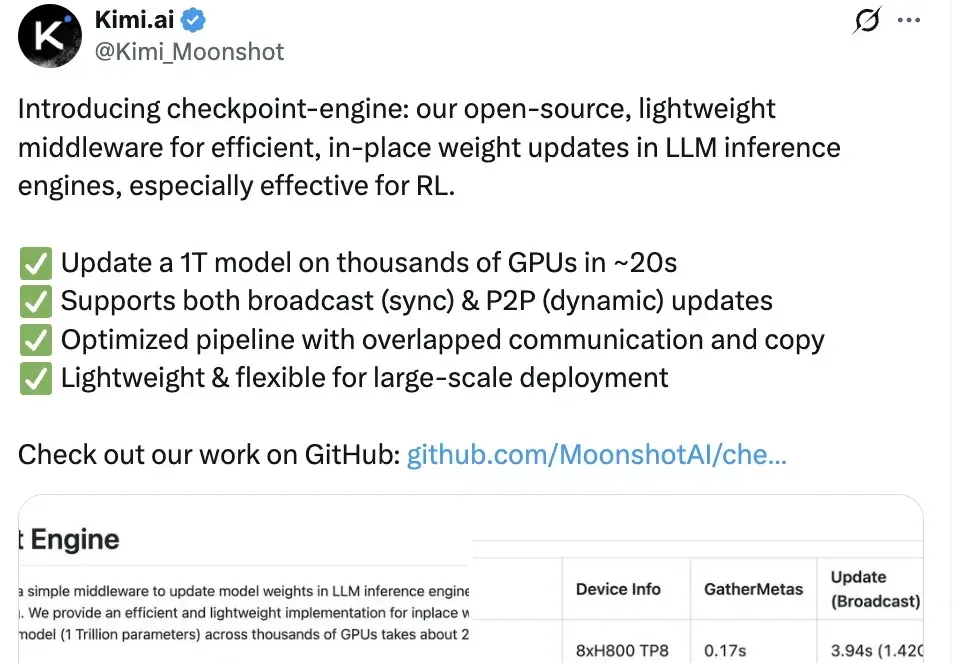
Kimi开源又双叒放大招了! 一个中间件,就能让Kimi K2的万亿模型参数进入“秒更时代”。 不仅支持一次性把更新完的权重从一个节点同时发送给所有节点,还能实现点对点动态更新。 网友也算是大开眼界了,可谓频频惊叹。 下面让我们一起看看这个中间件到底是如何发挥大作用的。 20秒更新万亿参数 此中间件名为checkpoint-engine(检查点引擎),主要用于强化学习中的一个关键步骤——在大语言模型推理过程中更新模型权重。 借助此组件,Kimi-K2只需约20秒就可实现在数千个GPU上更新1万亿参数。 与Kimi k1. 5类似,K2在同步强化学习训练中采用了混合共置架构,即训练引擎和推理引擎
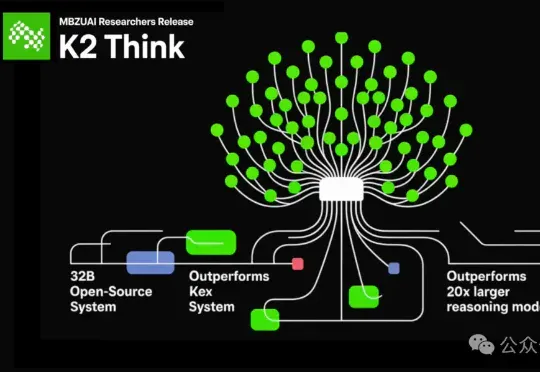
全球最快的开源大模型来了——速度达到了每秒2000个tokens! 虽然只有320亿参数(32B),吞吐量却是超过典型GPU部署的10倍以上的那种。它就是由阿联酋的穆罕默德·本·扎耶德人工智能大学(MBZUAI)和初创公司G42 AI合作推出的K2 Think。
昨天,美团低调地开源了其560B参数的混合专家(MoE)模型——LongCat-Flash。 一时间,大家的目光都被吸引了过去,行业内的讨论大多围绕着它在公开基准测试中媲美顶尖模型的性能数据,以及其精巧的MoE架构设计。
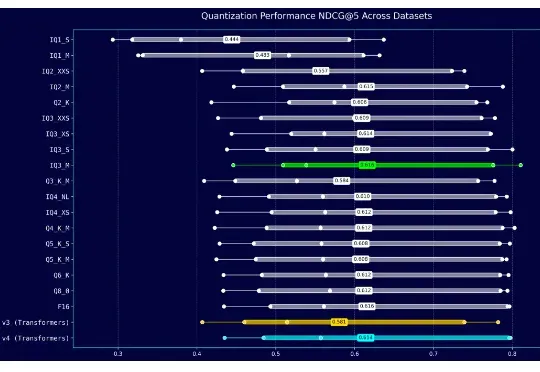
两周前,我们发布了 jina-embeddings-v4 的 GGUF 格式及其多种动态量化版本。jina-embeddings-v4 原模型有 37.5 亿参数,在我们的 GCP G2 GPU 实例上直接运行时效率不高。因此,我们希望通过更小、更快的 GGUF 格式来加速推理。
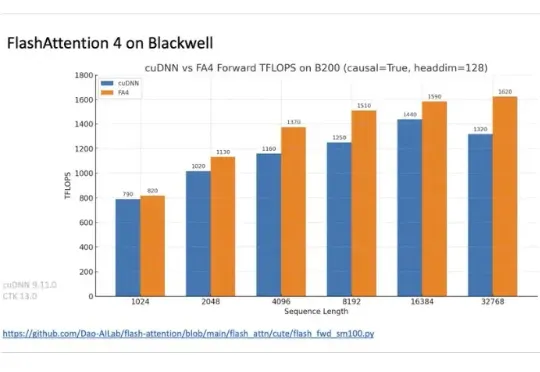
在正在举办的半导体行业会议 Hot Chips 2025 上,TogetherAI 首席科学家 Tri Dao 公布了 FlashAttention-4。