全网AI看不到的爱心,被这款开源全模态模型攻克了。。 (opens in a new tab)
昨天一大早,就发现美团开源了他们首款全模态实时交互大模型:LongCat-Flash-Omni。
Total 235 articles
昨天一大早,就发现美团开源了他们首款全模态实时交互大模型:LongCat-Flash-Omni。
从数据上看,Ashby 的增长轨迹令人印象深刻。在短短一年多时间里,他们的客户数量从 1300 家翻倍增长到超过 2700 家,年收入增长了 135%,面试安排量增长了 170%。更让我感到惊讶的是,他们的燃烧倍数控制在 1 倍以下,这在当前的市场环境下是极其难得的。
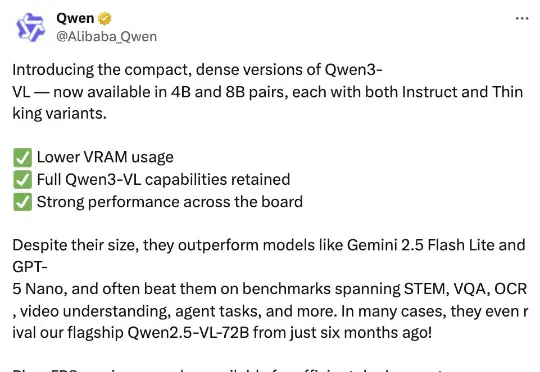
智东西10月15日报道,今日,阿里通义千问团队推出其最强视觉语言模型系列Qwen3-VL的4B与8B版本,两个尺寸均提供Instruct与Thinking版本,在几十项权威基准测评中超越Gemini 2.5 Flash Lite、GPT-5 Nano等同级别顶尖模型。
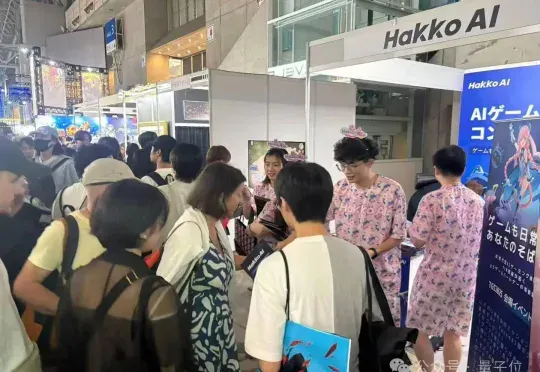
游戏理解领域模型LynkSoul VLM v1,在游戏场景中表现显著超过了包括GPT-4o、Claude 4 Sonnet、Gemini 2.5 Flash等一众顶尖闭源模型。背后厂商逗逗AI,亦在现场吸引了不少关注的目光。
Distyl AI。这家成立三年的初创公司为 T-Mobile 等企业提供所谓的"前置部署工程师"和 AI 软件,可自动化处理客户数据分析或人力资源管理等业务流程。据首席执行官 Arjun Prakash 透露,这家由数据分析软件制造商 Palantir 前员工创立的企业,在合同量激增后已完成 1.75 亿美元融资,投后估值达 18 亿美元。
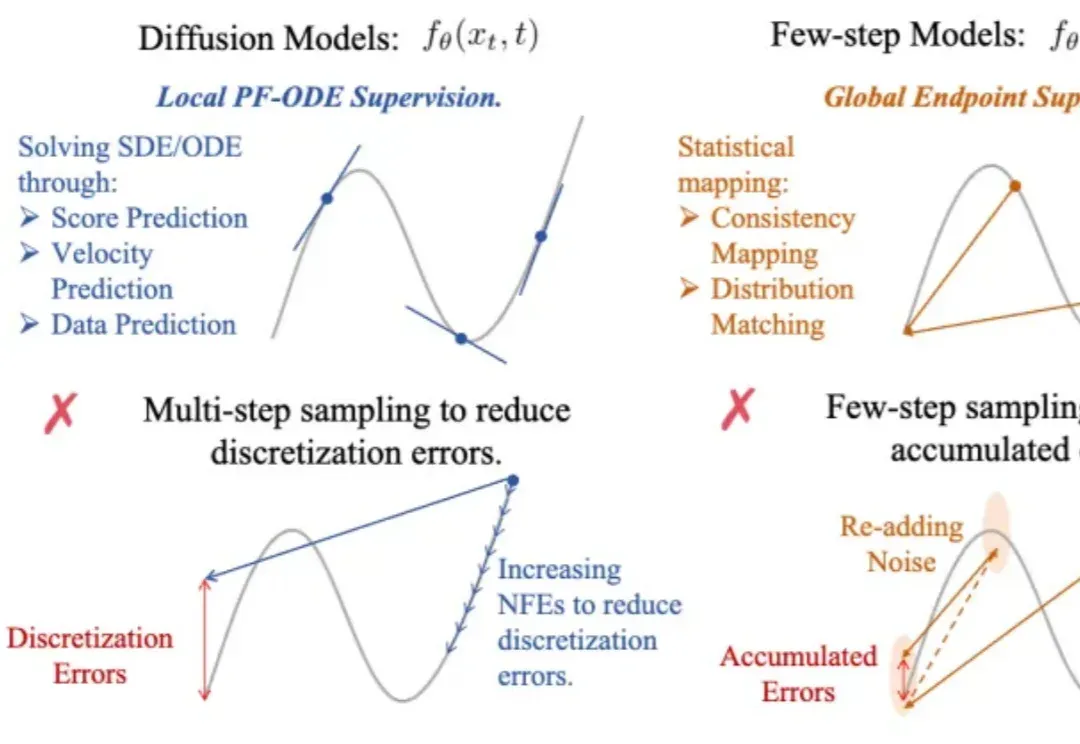
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两
谷歌这只「香蕉」火得有些疯狂:Nano Banana(即 Gemini 2.5 Flash Image)自 8 月底上线以来,仅用几周就吸引了超过 1,000 万新用户,并在 Gemini 应用中完成了 2 亿次图像编辑请求
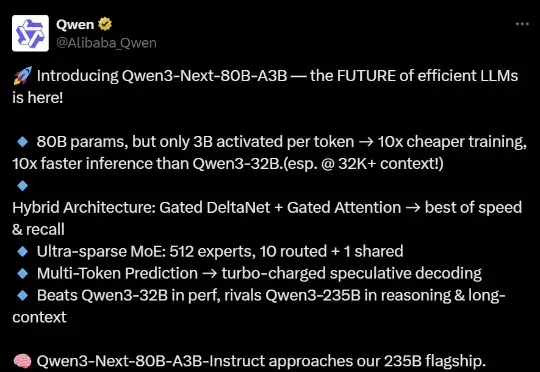
训练、推理性价比创新高。 大语言模型(LLM),正在进入 Next Level。 周五凌晨,阿里通义团队正式发布、开源了下一代基础模型架构 Qwen3-Next。总参数 80B 的模型仅激活 3B ,性能就可媲美千问 3 旗舰版 235B 模型,也超越了 Gemini-2.5-Flash-Thinking,实现了模型计算效率的重大突破。
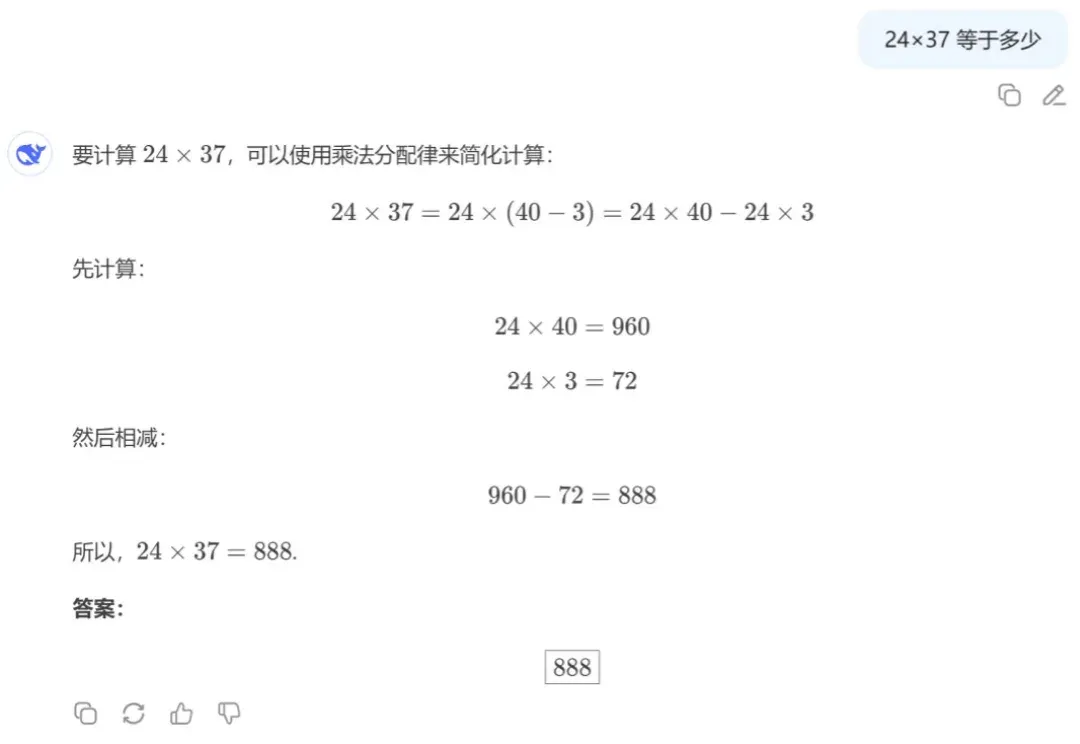
用过才知道,「快」不是万能药。 如果你这几天刷社交媒体,应该已经注意到,美团的 LongCat-Flash-Chat 正在频频刷屏,标题大多是将其与 DeepSeek 作对比,称美团推出的第一款开源大模型已经追平了 DeepSeek-V3.1。 事实果真如此吗?AI 科技评论想要一探究竟。 首先可以确定的是,这款模型上是一款面向日常对话与轻量问答的中量级对话模型,560B总参数,稍小于 DeepSeek-V3.1 的 671B,但是两者都采用了 MoE 架构。前者强调延迟控制与高并发下的流畅体验,后者逻辑拆解与复杂问题的处理能力更强。 LongCat 这款模型最大的标签就是“快”,几乎零延迟的
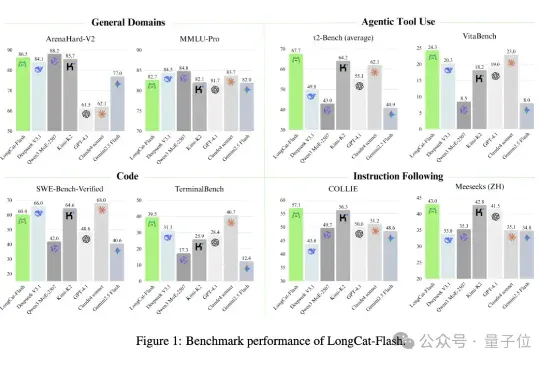
没想到啊,最新SOTA的开源大模型…… 来自一个送外卖(Waimai)的——有两个AI,确实不一样。 这个最新开源模型叫:Longcat-Flash-Chat,美团第一个开源大模型,发布即开源,已经在海内外的技术圈子里火爆热议了。