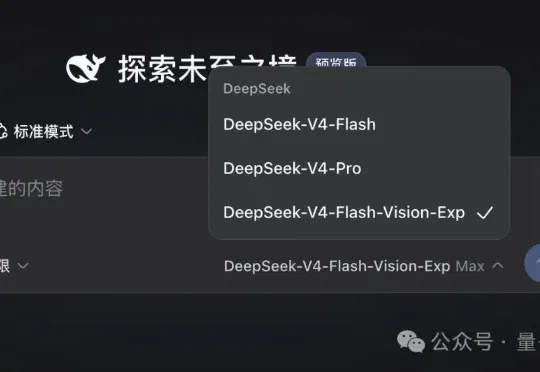
1分钱9张图!DeepSeek视觉模型连夜实测 (opens in a new tab)
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
Total 438 articles
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
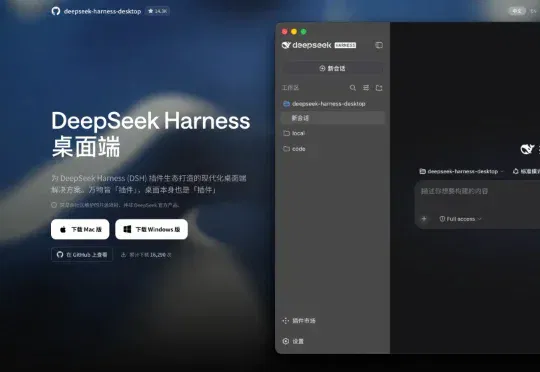
学不过来,刚刚学会怎么用好 Codex,现在又来了个 DeepSeek Harness。 过去几天,我们已经介绍过它的插件、各种新玩法和新上线的多模态,但还有一个最基础的问题没有解决:DeepSeek
长期依赖外部模型,不是最好的选择。 前几天,我们注意小红书在海外发布了一款大模型 dots3-note preview。 这款模型采用 MoE 架构,总参数 280B、激活参数 16B,支持 512K 上下文,并具备文本、视觉、语音的多模态理解能力。它属于 dots3 系列,后续还将有 jazz、aria 等不同定位的版本。作为先行发布的 note 版本,它更像是小红书将模型能力推向实际业务和开发者生态的第一步。 模型上线后,海外开发者社区很快开始讨论,Hugging Face 下载量破百,华为昇腾也在当天宣布完成适配;但在国内,这次发布暂时还没有掀起太大水花。 在这件事上,值得注意的并不只是
机器人撬开啤酒瓶盖,啤酒泡沫涌起,酒液从画面右下角流入杯中。
刚刚,阿里千问正式开源Qwen3.8-27B模型权重。Qwen3.8-27B是一款270亿参数的原生多模态稠密模型,支持图像、视频理解,原生上下文长度达到262K,并可通过YaRN扩展至100万Tokens。
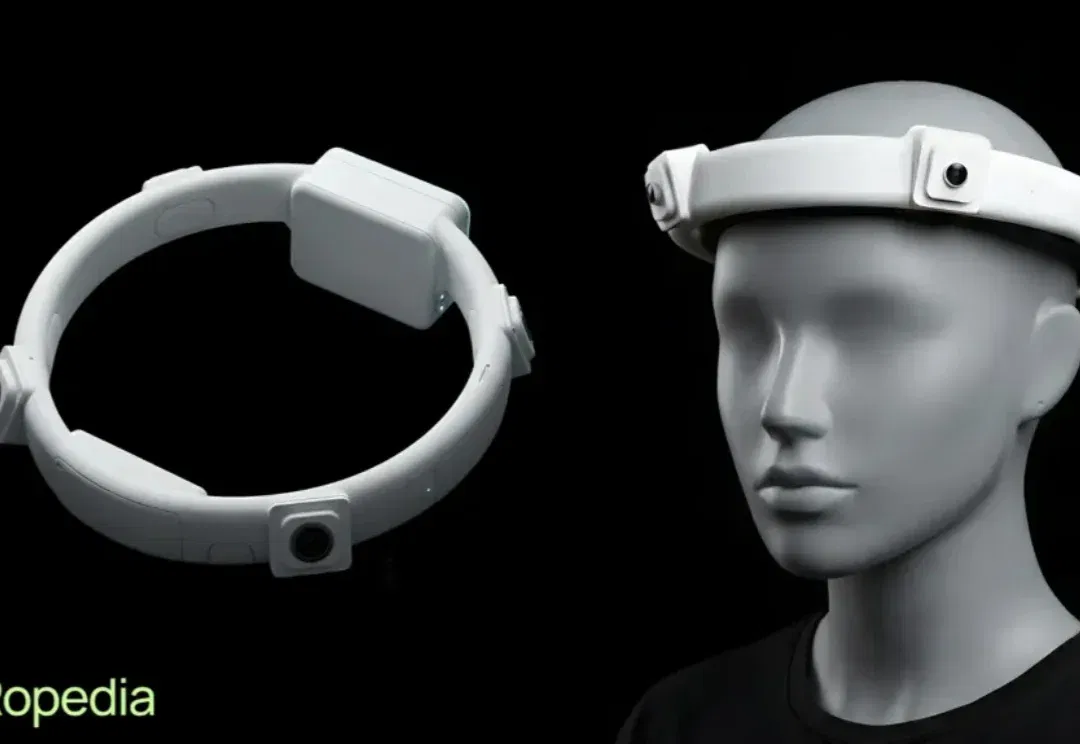
天使轮由一线美元基金,智能制造与大模型产业方共同领投;数据集 Xperience-10M 位列全平台数据集榜第 2 名,具身赛道第一名,目前已被多款具身基础模型 Qwen-VLA、MolmoMotion 等采用;多模态采集系统 HOMIE 进入规模化量产交付,新一代系统将于 2026 年 8 月发布。
Coding之外, 关于原生多模态的争论从未停止。
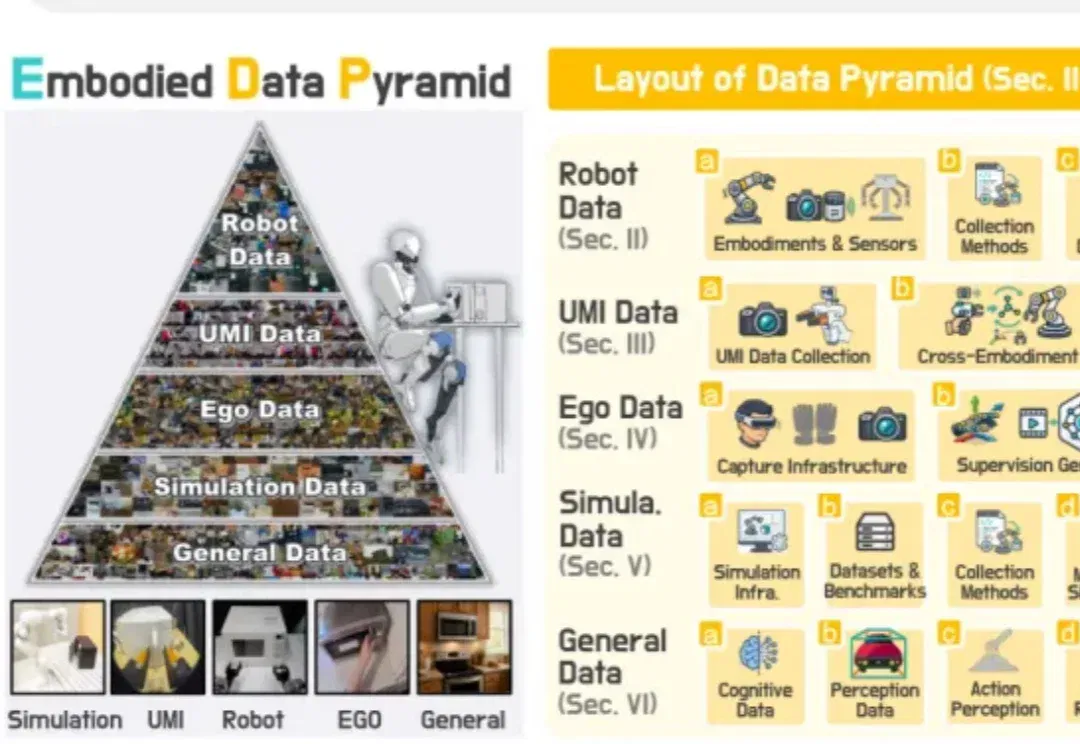
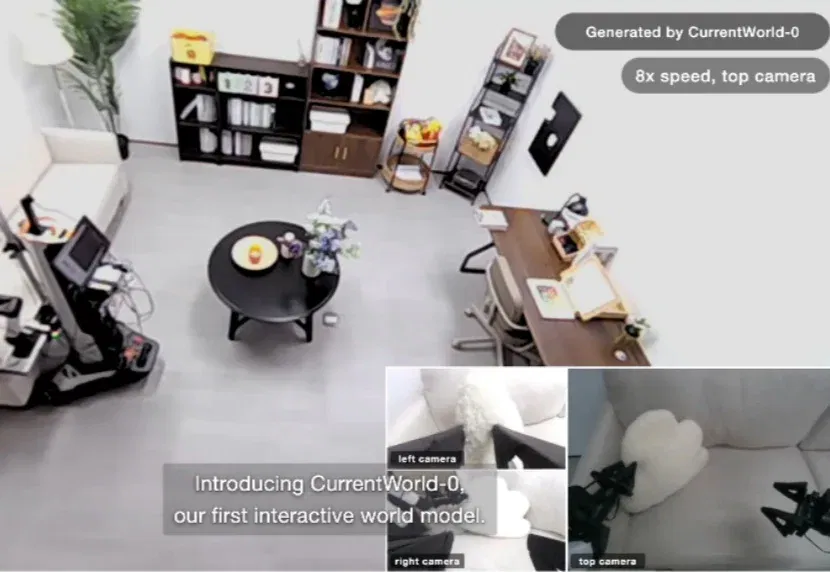
多模态基础模型可以通过互联网规模的图像与语言学习「看」和「说」,但具身智能没有同样的捷径。机器人必须进一步理解物理状态与动力学,判断动作如何改变环境,并在真实世界中执行连续行为;这要求训练数据同时连接观察、状态、动作与物理后果。
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
JarvisHub 给出的答案,是把可编辑画布同时变成用户工作区、Agent 的外部记忆、行动空间和共享项目状态。Agent 不再只从聊天记录里猜测上下文,而是直接「看」到画布上的提示词、参考图、候选版本、生成结果、依赖关系、失败记录和用户反馈,再据此规划、调用工具、写回结果。