图灵奖得主Sutton新作:AI的下一步,是走向「生成认知」 (opens in a new tab)
从 LLM 的超长文本处理、视频生成模型的以假乱真、Agent 自主规划与执行的日趋成熟,到 VLA、世界模型等开始进入物理世界,AI 正在不断拓宽其能力边界。
Total 388 articles
从 LLM 的超长文本处理、视频生成模型的以假乱真、Agent 自主规划与执行的日趋成熟,到 VLA、世界模型等开始进入物理世界,AI 正在不断拓宽其能力边界。
英伟达世界动作模型 DreamZero 训练一次要烧 8 张 H100 整整 25 天,RLinf 从算子融合到 I/O 全链路系统级重构,把训练吞吐拉高近 4 倍——1 个月的活,1 周就能干完。
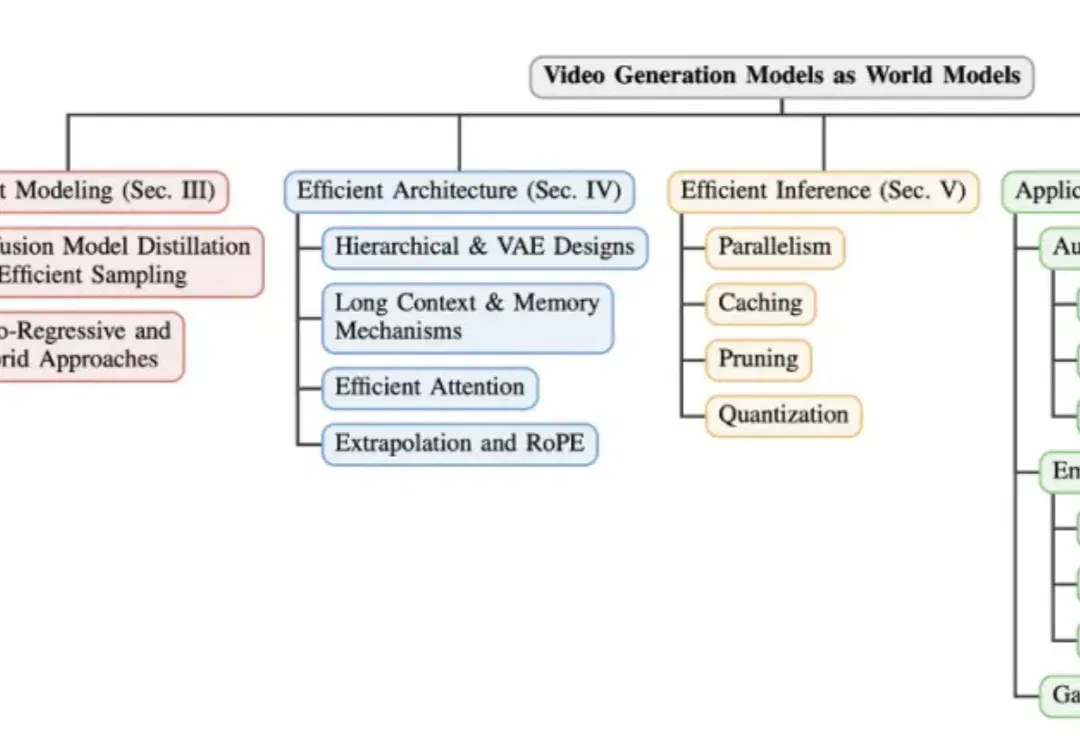
还记得两年前,AI 生视频可谓是「鬼畜专区」—— 人物多一根手指算基操,走路自带鬼步舞才是常态。结果转眼间,从 OpenAI 的 Sora 到字节跳动的 Seedance,这些模型已经开始一本正经地「模拟世界」了:水会流、球会弹、光影能追踪,俨然一副要当「物理引擎」的架势。
昨晚夜里快12点,AI视频公司PixVerse毫无预兆的发了一个项目。PixVerse R1,下一代实时世界生成模型。这玩意你看文字,可能不是很好理解,我直接放一个官方的demo视频,大家的感觉应该会强一些。
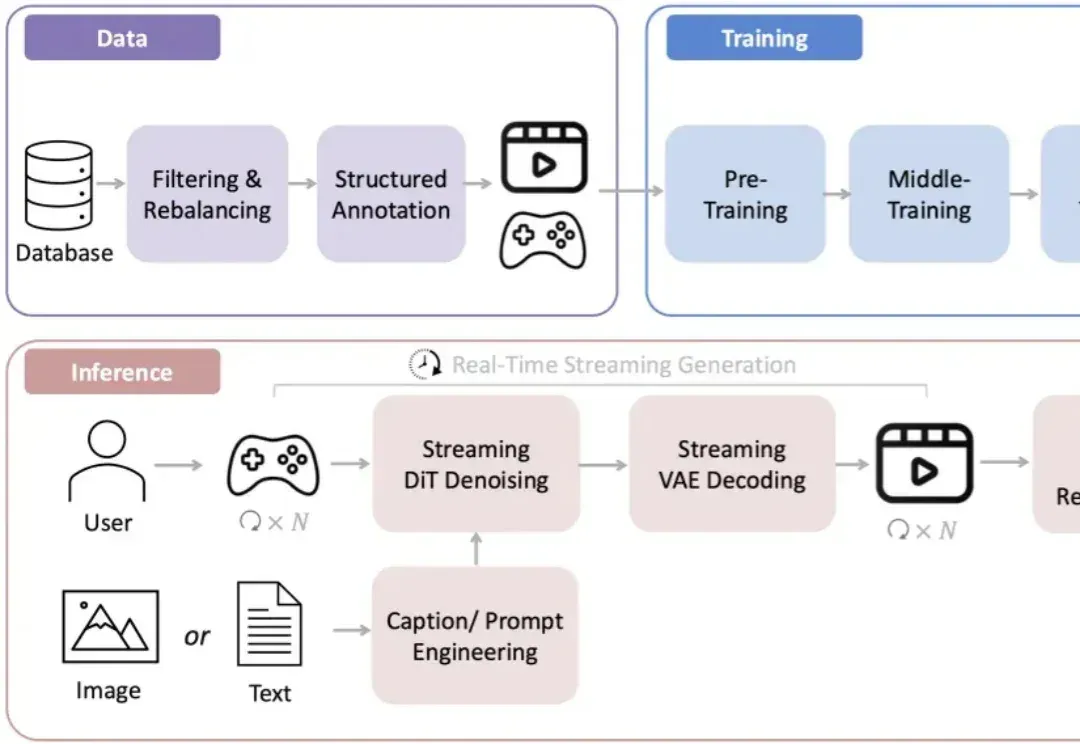
还记得前段时间在 AI 圈刷屏的李飞飞「3D 世界生成模型」吗?现在,国产版终于来了。
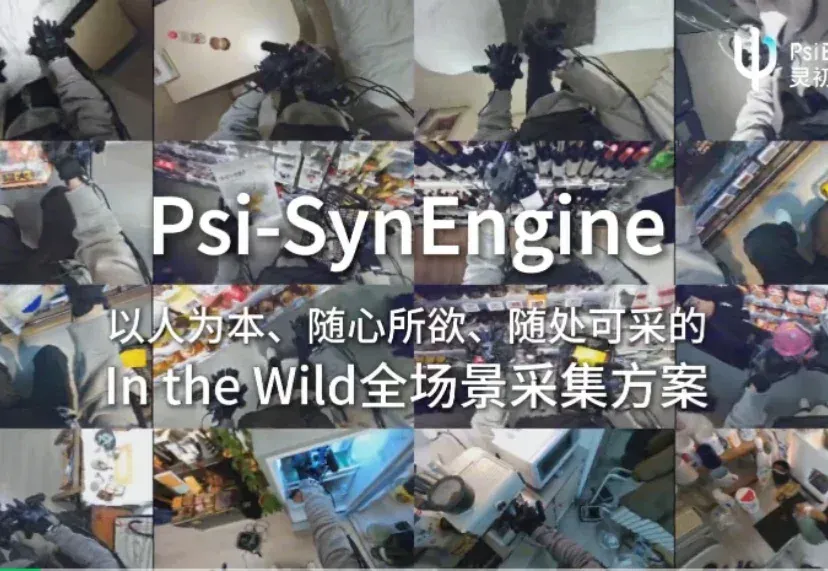
灵初智能发布全球首个具身原生人类数据采集方案 Psi-SynEngine。该方案由灵初智能全栈自研,包含便携式外骨骼触觉手套数采套装、大规模 in the wild 数采数据管线、基于世界模型和强化学习的跨本体数据迁移模型,并已率先将采集到的人类数据应用于物流等真实场景。

近来,世界模型(World Model)很火。多个 AI 实验室纷纷展示出令人惊艳的 Demo:仅凭一张图片甚至一段文字,就能生成一个可交互、可探索的 3D 世界。这些演示当然很是炫酷,它们展现了 AI 强大的生成能力。
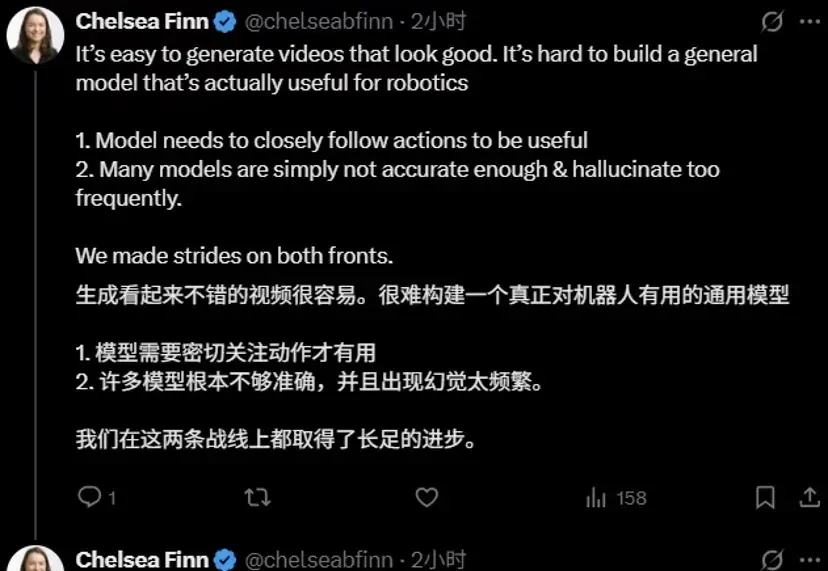
这两天,Physical Intelligence(PI)联合创始人Chelsea Finn在𝕏上,对斯坦福课题组一项最新世界模型工作kuakua连续点赞。
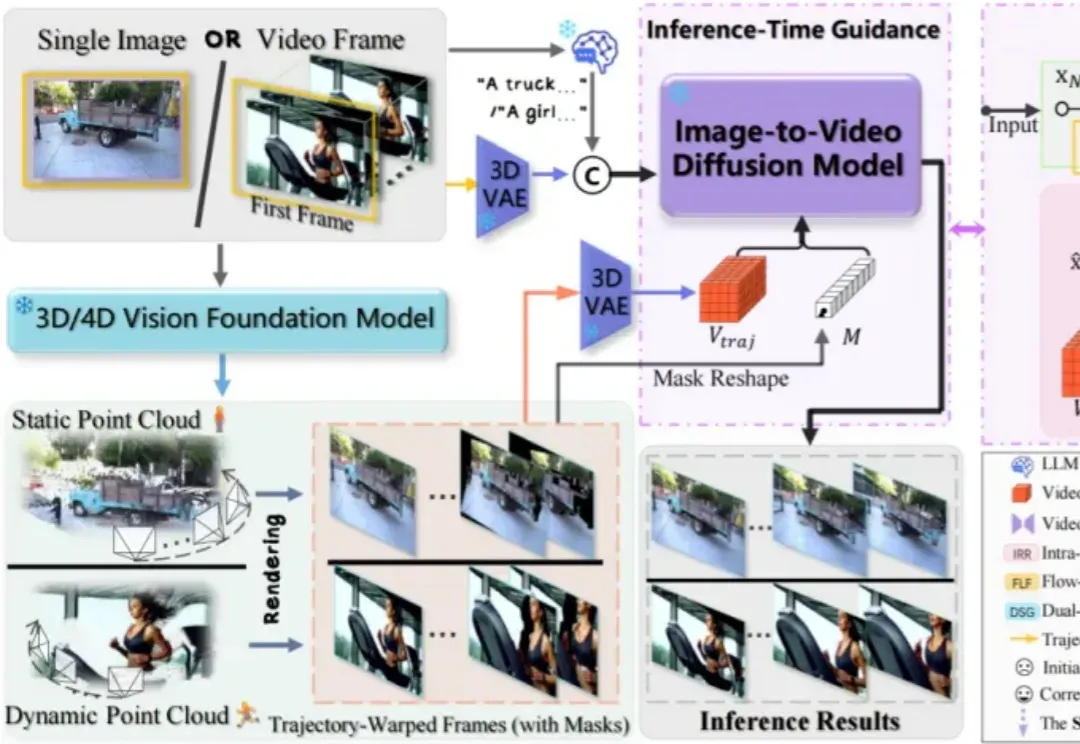
近来,由AI生成的视频片段以前所未有的视觉冲击力席卷了整个互联网,视频生成模型创造出了许多令人惊叹的、几乎与现实无异的动态画面。

机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。