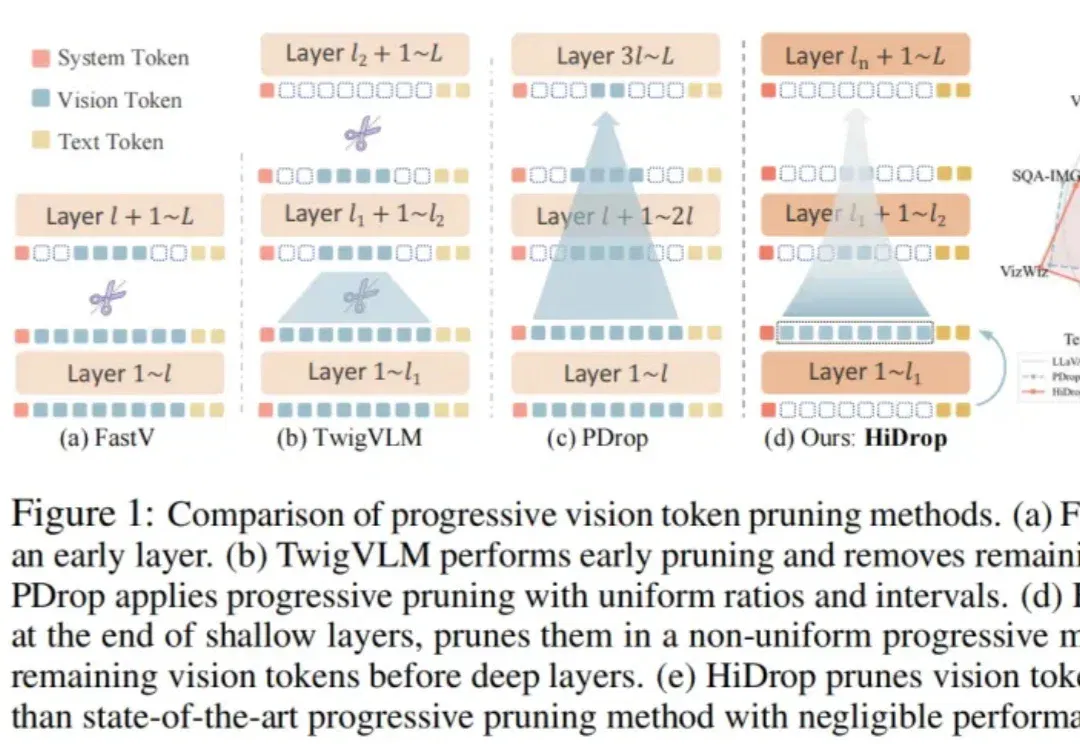
东方理工团队提出HiDrop:重构MLLM计算路径,压缩90%视觉Token实现2.2倍加速 (opens in a new tab)
随着多模态大语言模型(MLLM)支持更长上下文,高分辨率图像和长视频会产生远多于文本的视觉 Token,在自注意力二次复杂度下迅速成为效率瓶颈。
Total 619 articles
随着多模态大语言模型(MLLM)支持更长上下文,高分辨率图像和长视频会产生远多于文本的视觉 Token,在自注意力二次复杂度下迅速成为效率瓶颈。
粗大事了,刚刚,Claude把上下文窗口一口气撑到100万token!整套代码库、海量论文、长对话一次读完,AI真正拥有「超长工作记忆」。AI编程军备竞赛,正在被彻底改写。
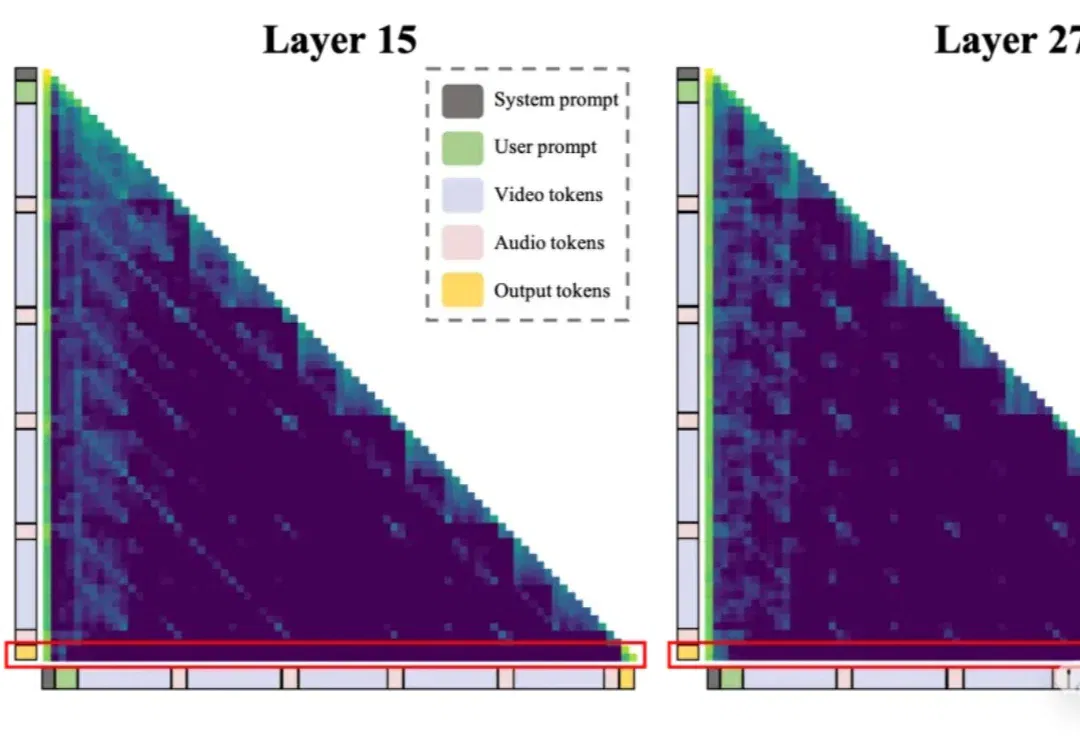
一段几十秒的音视频,上万Token,一半以上是冗余——Omni-LLM的计算浪费,比想象中更严重。
Claude Code 正式上线语音模式:输入 /voice,长按空格说话,松开即完成输入。语音转录实时流入光标位置,和键盘无缝切换,转录Token完全免费。编程的下一个战场不是模型智商,而是交互方式。
前面已经说了,传统自回归就像打字机一样,一次只能处理一个token,且必须按照从左到右的顺序。但扩散模型Mercury 2的工作方式更像一位编辑——最终,Mercury 2能将生成速度提升5倍以上,且速度曲线截然不同。
思考token在精不在多。Yuan 3.0 Flash用RAPO+RIRM双杀过度思考,推理token砍75%,网友们惊呼:这就是下一代AI模型的发展方向!
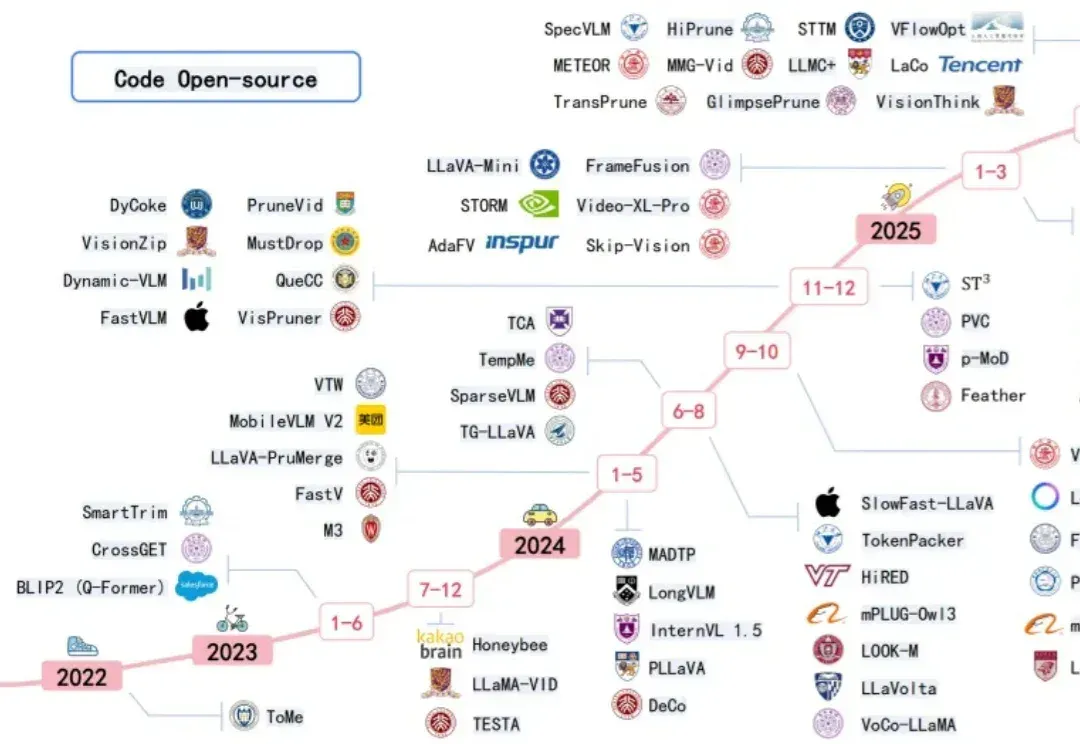
近年来多模态大模型在视觉感知,长视频问答等方面涌现出了强劲的性能,但是这种跨模态融合也带来了巨大的计算成本。高分辨率图像和长视频会产生成千上万个视觉 token ,带来极高的显存占用和延迟,限制了模型的可扩展性和本地部署。
MiniMax 海螺视频团队「首次开源」了 VTP(Visual Tokenizer Pre-training)项目。他们同步发布了一篇相当硬核的论文,它最有意思的地方在于 3 个点:「重建做得越好,生成反而可能越差」,传统 VAE 的直觉是错的
GPT-5.2打赢Gemini 3.0 Pro,竟是靠高推理与海量Token「作弊」?网友的这个发现,在AI社区一石激起千层浪。更多网友七嘴八舌表示:GPT-5.2,并没有那么好用!
两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。