单个LLM已不够?华盛顿大学开源多模型协同框架MoCo (opens in a new tab)
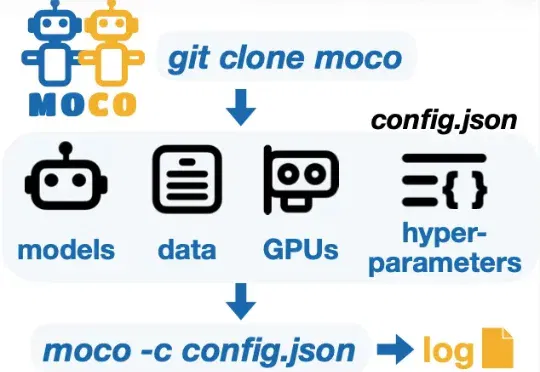
为了支持多模型协同研究并加速这一未来愿景的实现,华盛顿大学 (University of Washington) 冯尚彬团队联合斯坦福大学、哈佛大学等研究人员提出 MoCo—— 一个针对多模型协同研究的 Python 框架。MoCo 支持 26 种在不同层级实现多模型交互的算法,研究者可以灵活自定义数据集、模型以及硬件配置,比较不同算法,优化自身算法,以此构建组合式人工智能系统。MoCo 为设计、
Total 235 articles
为了支持多模型协同研究并加速这一未来愿景的实现,华盛顿大学 (University of Washington) 冯尚彬团队联合斯坦福大学、哈佛大学等研究人员提出 MoCo—— 一个针对多模型协同研究的 Python 框架。MoCo 支持 26 种在不同层级实现多模型交互的算法,研究者可以灵活自定义数据集、模型以及硬件配置,比较不同算法,优化自身算法,以此构建组合式人工智能系统。MoCo 为设计、
春节还没到,「过年的气氛」已经渗入科技圈每个人的毛孔。单说 AI 大模型这一块,刚刚发布的有 kimi 2.5 和 Step 3.5 Flash,即将发布的据说还有 DeepSeek V4,GPT-5.3、Claude Sonnet 5、Qwen 3.5,GLM-5,说不定一觉醒来,现有的技术就要被颠覆。
在经济学和博弈论的世界里,找到「纳什均衡」往往意味着找到了复杂局势下的最优解。多所顶尖高校的研究人员开发出了一位名为PrimeNash的「AI数学家」,不仅能像人类专家一样推导公式,还能解决许多连传统算法都束手无策的复杂博弈难题,成果已发表在Cell Press旗下的交叉学科期刊Nexus上。
思考token在精不在多。Yuan 3.0 Flash用RAPO+RIRM双杀过度思考,推理token砍75%,网友们惊呼:这就是下一代AI模型的发展方向!
这两天,整个朋友圈、信息流里全都是 Clawdbot 的推文,感觉人类已经在一个月内从 0.75 级宇宙文明跨越到 0.76 级宇宙文明了😆。
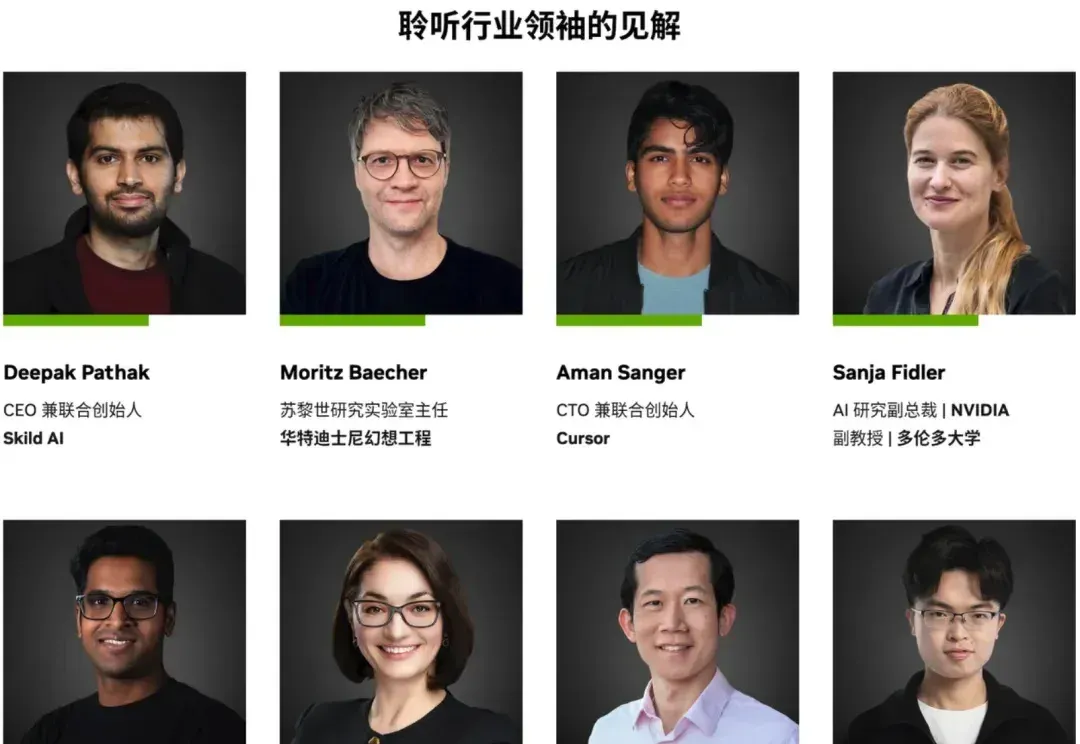
谁是老黄2026年的新座上宾? 杨植麟。 没错,月之暗面创始人、CEO,Kimi系列模型和产品的核心缔造者,一度以大模型“小天才”范本高开高走的新一代AI创业者代表…… 但在2026年,才成为黄仁勋钦点的GTC主会演讲分享嘉宾,对杨植麟和Kimi,意味就多很多。 毕竟在过去的2025年,杨植麟和Kimi经历了DeepSeek的冲击波,然后以技术的方式、模型的方式、开源的方式、产品的方式,重新赢回了信任,结束了诸多被争议的非技术关注。 在最新剧透的英伟达2026年GTC大会嘉宾中,杨植麟是唯一一位来自独立大模型创业公司的代表。 与他处于同一列席的,包括特斯拉AI总监Ashok Elluswamy
啥,Flash这次这真没了?还是被AI干没的??
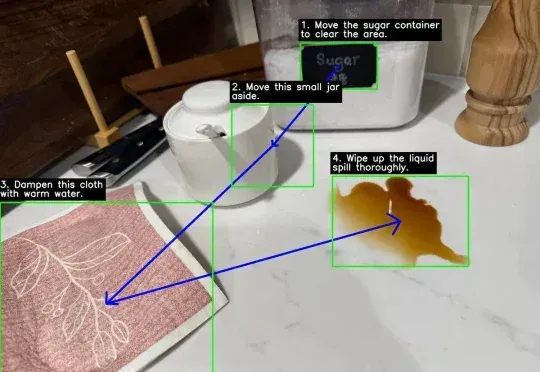
没想到吧,Google DeepMind刚刚为Gemini 3 Flash推出了一个重量级新能力:Agentic Vision(智能体视觉)。(难道是被DeepSeek-OCR2给刺激到了?)
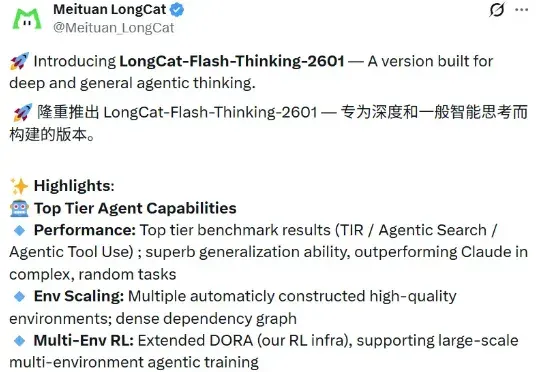
美团也重磅更新自家模型 ——LongCat-Flash-Thinking-2601。这是一款强大高效的大规模推理模型,拥有 5600 亿个参数,基于创新的 MoE 架构构建。该模型引入了强大的重思考模式(Heavy Thinking Mode),能够同时启动 8 路思考并最终总结出一个更全面、更可靠的结论。目前重思考模式已在 LongCat AI 平台正式上线,人人均可体验。
最近,一个澳大利亚的养羊大叔用5行代码捅破AI编程天花板的故事,彻底火出圈了。2025年底,在铲羊粪的间隙,Geoffrey Huntley写出了下面这个仅含5行代码的Bash脚本while :; do cat PROMPT.md | claude-code ; done