混元OCR模型核心技术揭秘:统一框架、真端到端 (opens in a new tab)
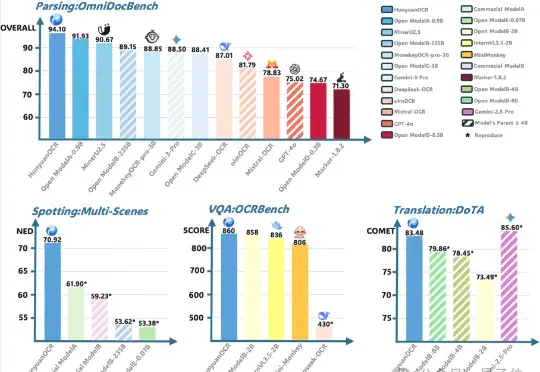
腾讯混元大模型团队正式发布并开源HunyuanOCR模型!这是一款商业级、开源且轻量(1B参数)的OCR专用视觉语言模型,模型采用原生ViT和轻量LLM结合的架构。目前,该模型在抱抱脸(Hugging Face)趋势榜排名前四,GitHub标星超过700,并在Day 0被vllm官方团队接入。
Total 223 articles
腾讯混元大模型团队正式发布并开源HunyuanOCR模型!这是一款商业级、开源且轻量(1B参数)的OCR专用视觉语言模型,模型采用原生ViT和轻量LLM结合的架构。目前,该模型在抱抱脸(Hugging Face)趋势榜排名前四,GitHub标星超过700,并在Day 0被vllm官方团队接入。
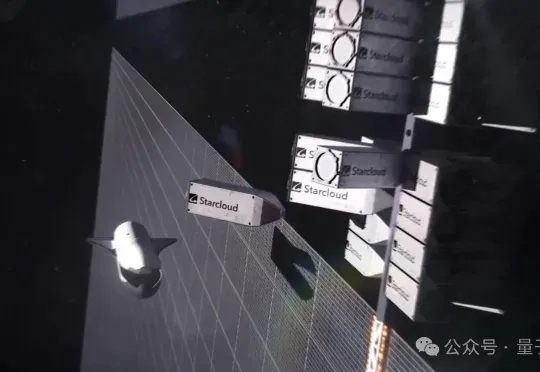
地面上的算力“内卷”,终于突破了大气层的束缚。前脚,装有英伟达H100的Starcloud-1卫星搭乘SpaceX的猎鹰9号火箭成功进入轨道,迈出构建“太空超算”的关键一步。谷歌紧随其后,火速披露了部署搭载TPU卫星集群的“太阳捕手”计划(Project Suncatcher)。
就在刚刚,DeepSeek 又悄咪咪在 Hugging Face 上传了一个新模型:DeepSeek-Math-V2。顾名思义,这是一个数学方面的模型。它的上一个版本 ——DeepSeek-Math-7b 还是一年多以前发的。当时,这个模型只用 7B 参数量,就达到了 GPT-4 和 Gemini-Ultra 性能相当的水平。相关论文还首次引入了 GRPO,显著提升了数学推理能力。
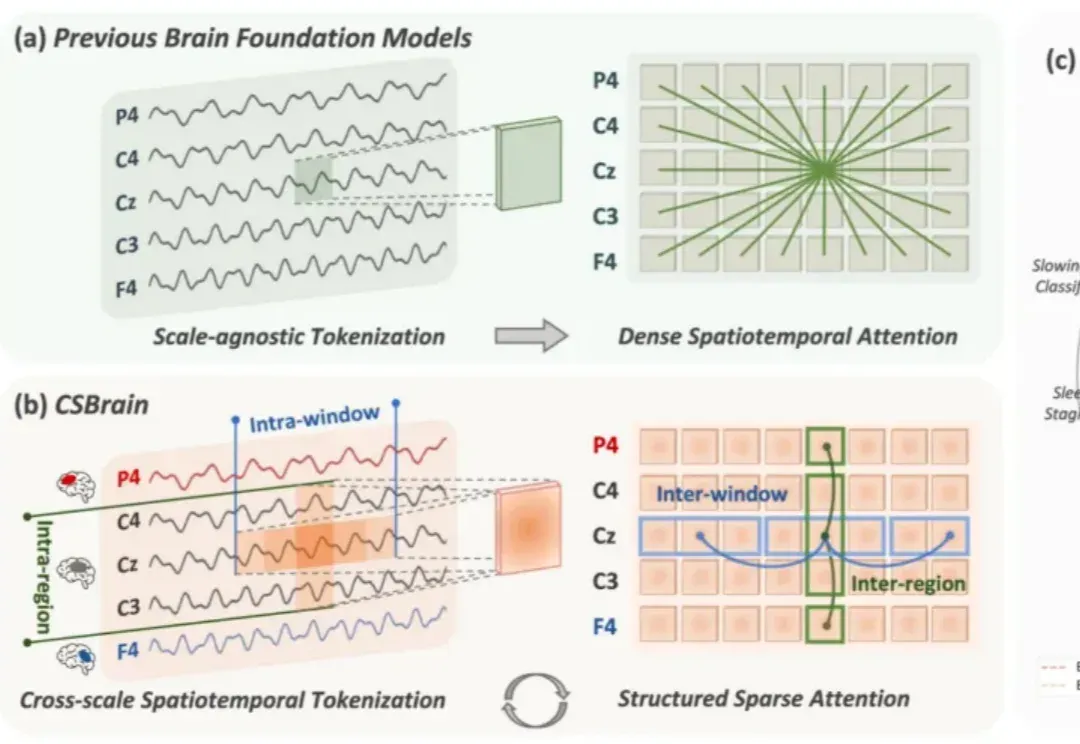
脑机接口(Brain-Computer Interface, BCI)被视为连接人类智能与人工智能的终极界面。要真正实现这一愿景,核心在于高精度的脑信号解码,即让通用 AI 模型能够真正「读懂」复杂多变的脑活动。
在AI热潮里,故事比技术更值钱。一家名为Oklo的核能初创公司,靠着一个概念,市值飙到210亿美元;另一边,一个从SpaceX离职的工程师,让AI自己画电路板,几分钟搞定工程师三天的工作。一个靠叙事吸引资金,一个用技术推动生产。AI热潮下,这两家公司代表着同一时代的两种姿态——造梦,和造物。
人类首个AI创作型导演诞生!Josh Wallace Kerrigan用GenAI工具,构建Neural Viz的外星宇宙,避免硬碰AI短板,转而实验伪纪录片形式。
AI 编程早已成为许多开发者日常生产中的一环,而随着代码生成的速度和规模达到一定程度,一个日益重要的问题是,支撑这些 AI 运转的开发工具和基础设施正在成为新的瓶颈。
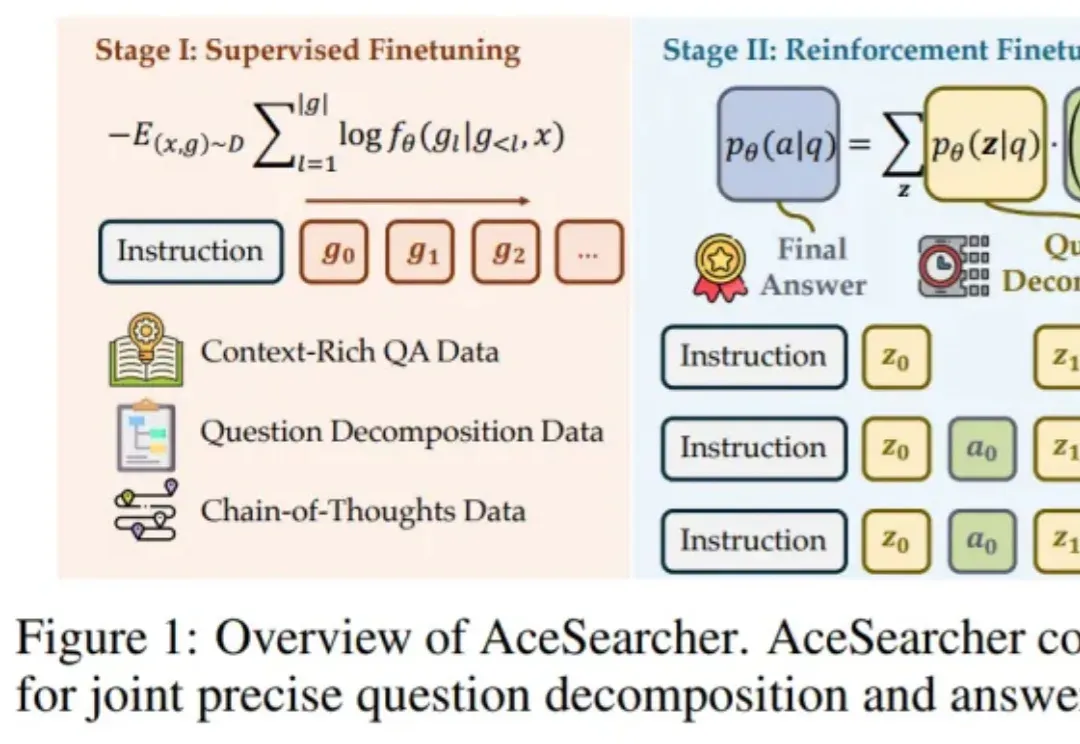
如何让一个并不巨大的开源大模型,在面对需要多步检索与复杂逻辑整合的问题时,依然像 “冷静的研究员” 那样先拆解、再查证、后归纳,最后给出可核实的结论?
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。
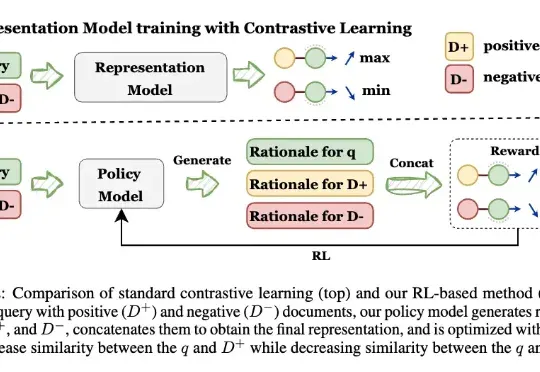
让模型先解释,再学Embedding! 来自UIUC、ANU、港科大、UW、TAMU等多所高校的研究人员,最新推出可解释的生成式Embedding框架——GRACE。过去几年,文本表征(Text Embedding)模型经历了从BERT到E5、GTE、LLM2Vec,Qwen-Embedding等不断演进的浪潮。这些模型将文本映射为向量空间,用于语义检索、聚类、问答匹配等任务。