快手解密「AI印钞机」,首提生成式强化学习出价技术,为平台实现超过3%的广告收入提升 (opens in a new tab)
CBD 算法则是快手商业化算法团队在本月初公布的新方法,全名 Causal auto-Bidding method based on Diffusion completer-aligner,即基于扩散式补全器-对齐器的因果自动出价方法。
Total 198 articles
CBD 算法则是快手商业化算法团队在本月初公布的新方法,全名 Causal auto-Bidding method based on Diffusion completer-aligner,即基于扩散式补全器-对齐器的因果自动出价方法。
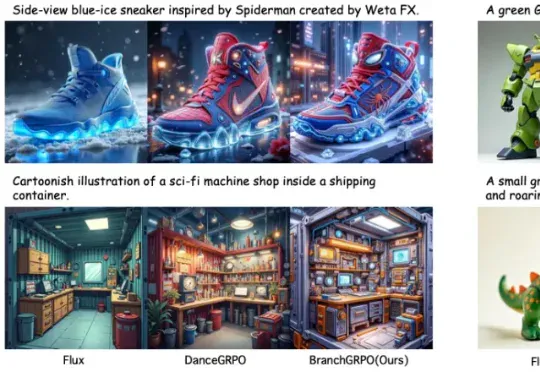
近期,北京大学与字节团队提出了名为 BranchGRPO 的新型树形强化学习方法。不同于顺序展开的 DanceGRPO,BranchGRPO 通过在扩散反演过程中引入分叉(branching)与剪枝(pruning),让多个轨迹共享前缀、在中间步骤分裂,并通过逐层奖励融合实现稠密反馈。
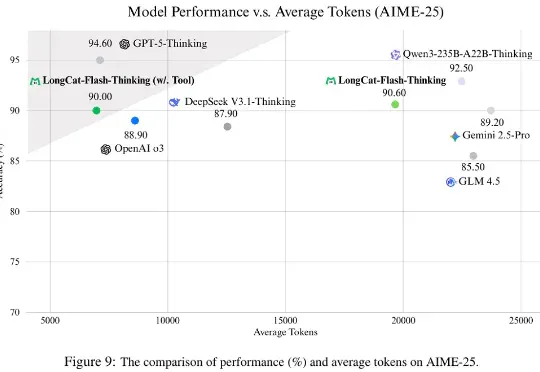
最近,美团在AI开源赛道上在猛踩加速。今天,在开源其首款大语言模型仅仅24天后,美团又开源了其首款自研推理模型LongCat-Flash-Thinking。与其基础模型LongCat-Flash类似,效率也是LongCat-Flash-Thinking的最大特点。美团在技术报告中透露,LongCat-Flash-Thinking在自研的DORA强化学习基础设施完成训练
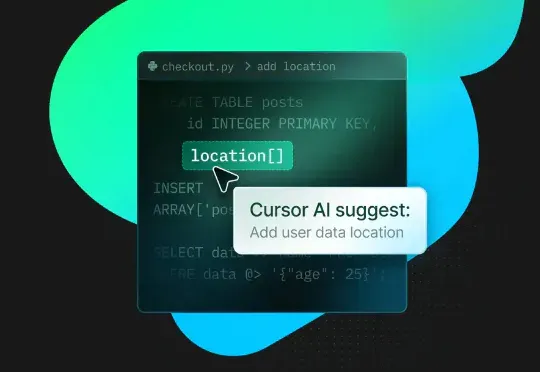
Cursor Tab 是 Cursor 的核心功能之一,它通过分析开发者的编码行为,智能预测并推荐后续代码,开发者仅需按下 Tab 键即可采纳。然而,它也面临着一个 AI 普遍存在的难题:「过度热情」。有时,它提出的建议不仅毫无用处,甚至会打断开发者的思路。
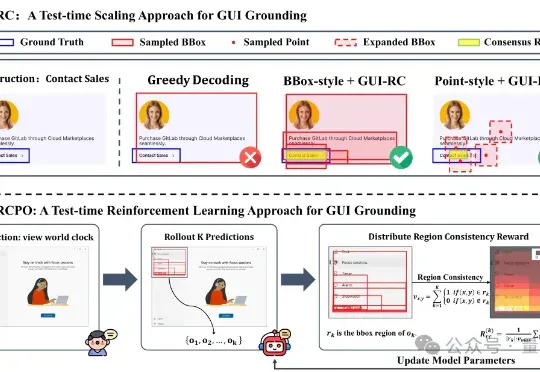
无需海量数据标注,智能体也能精确识别定位目标元素了! 来自浙大等机构的研究人员提出GUI-RCPO——一种自我监督的强化学习方法,可以让模型在没有标注的数据上自主提升GUI grounding(图形界面定位)能力。
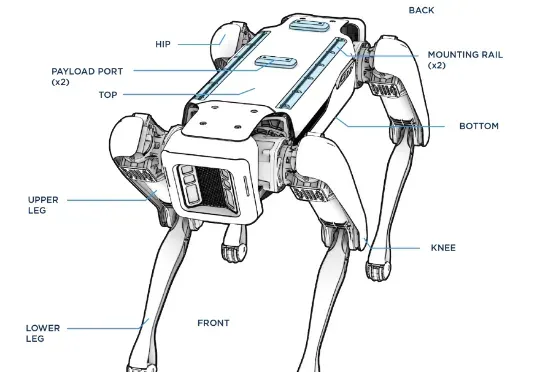
刚刚,风头被中国机器人盖过的波士顿动力,又整了个大活!前后空翻我还能理解,这侧空翻?(不是哥们,你真会啊!)他们先在仿真环境中进行强化学习,一旦策略出现问题,那么他们就将其部署在真机上进行测试,观察问题,然后反复测试迭代,加强Spot的稳定性。
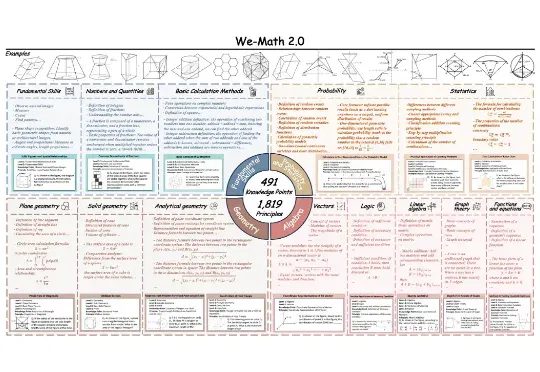
近期,多模态大模型在图像问答与视觉理解等任务中进展迅速。随着 Vision-R1 、MM-Eureka 等工作将强化学习引入多模态推理,数学推理也得到了一定提升。
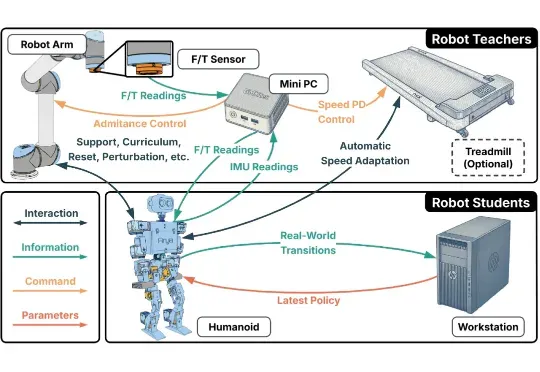
人形机器人的运动控制,正成为强化学习(RL)算法应用的下一个热点研究领域。当前,主流方案大多遵循 “仿真到现实”(Sim-to-Real)的范式。研究者们通过域随机化(Domain Randomization)技术,在成千上万个具有不同物理参数的仿真环境中训练通用控制模型,期望它能凭借强大的泛化能力,直接适应动力学特性未知的真实世界。