实时交互模型:一个还没形成共识的赛道,怎么就成了热门? (opens in a new tab)
实时交互模型尚未形成统一定义却已成为热门赛道,SigmaZ AI、Loopit、Reverie AI、Runway和Vidu等公司从原生音视频生成、Coding驱动等不同技术路线出发,探索AI在聊天框之外实时响应用户多模态输入的能力,行业正围绕定义权和稀缺交互数据展开竞争。
Total 438 articles
实时交互模型尚未形成统一定义却已成为热门赛道,SigmaZ AI、Loopit、Reverie AI、Runway和Vidu等公司从原生音视频生成、Coding驱动等不同技术路线出发,探索AI在聊天框之外实时响应用户多模态输入的能力,行业正围绕定义权和稀缺交互数据展开竞争。
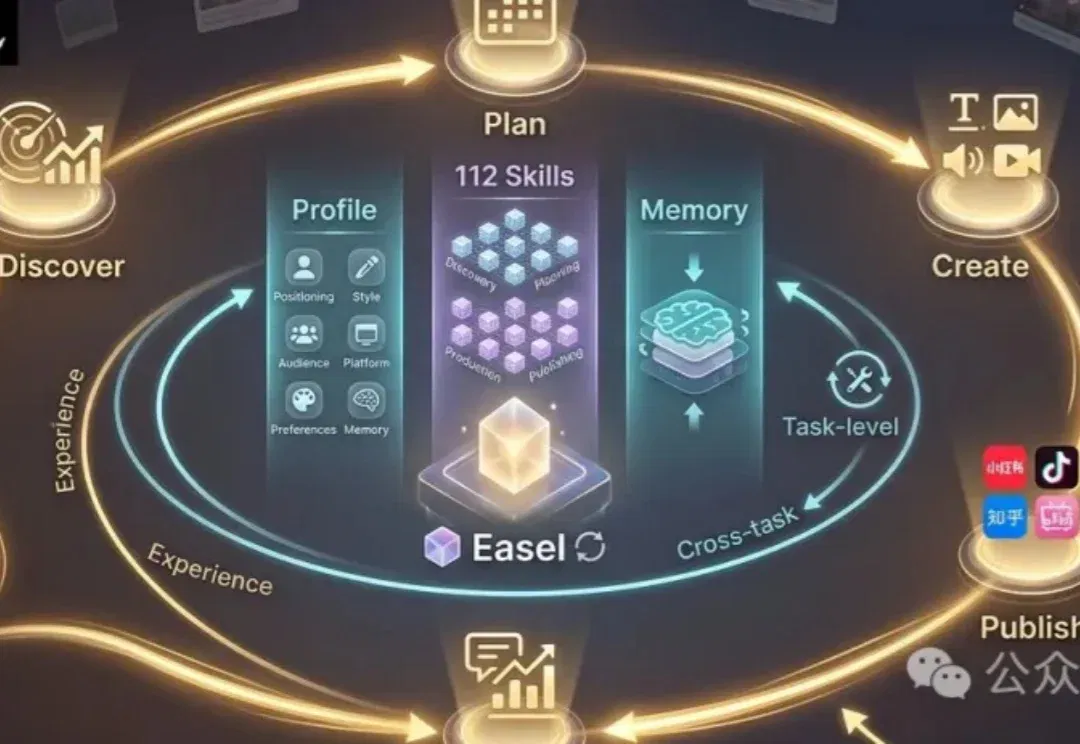
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
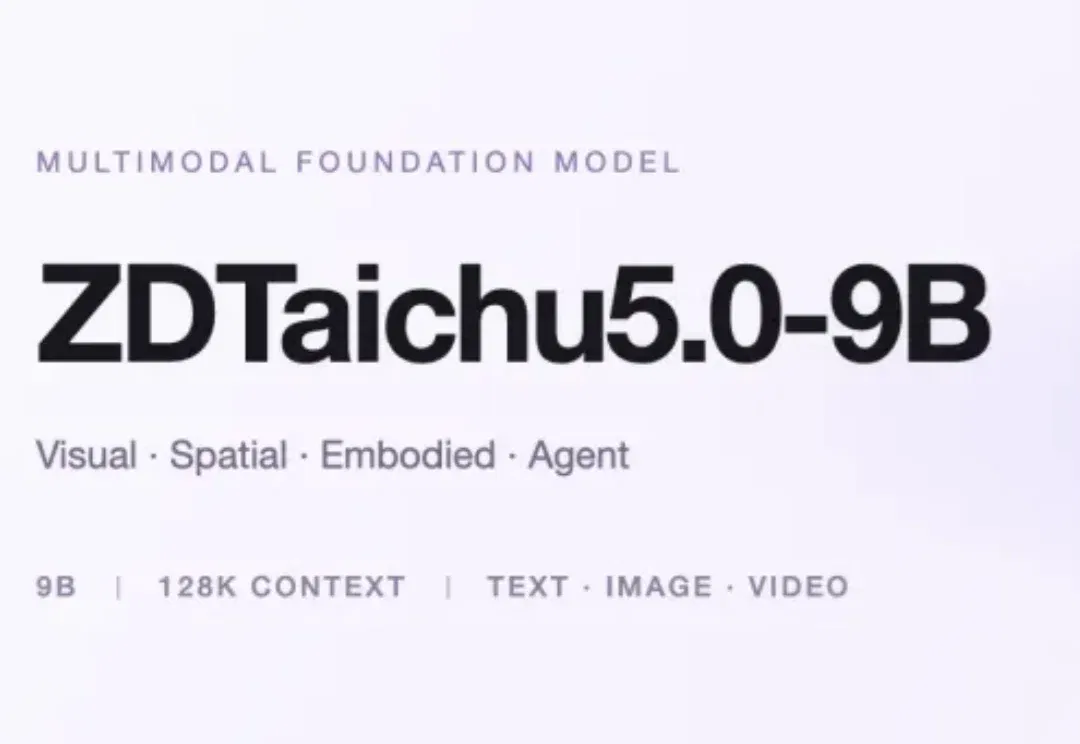
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!
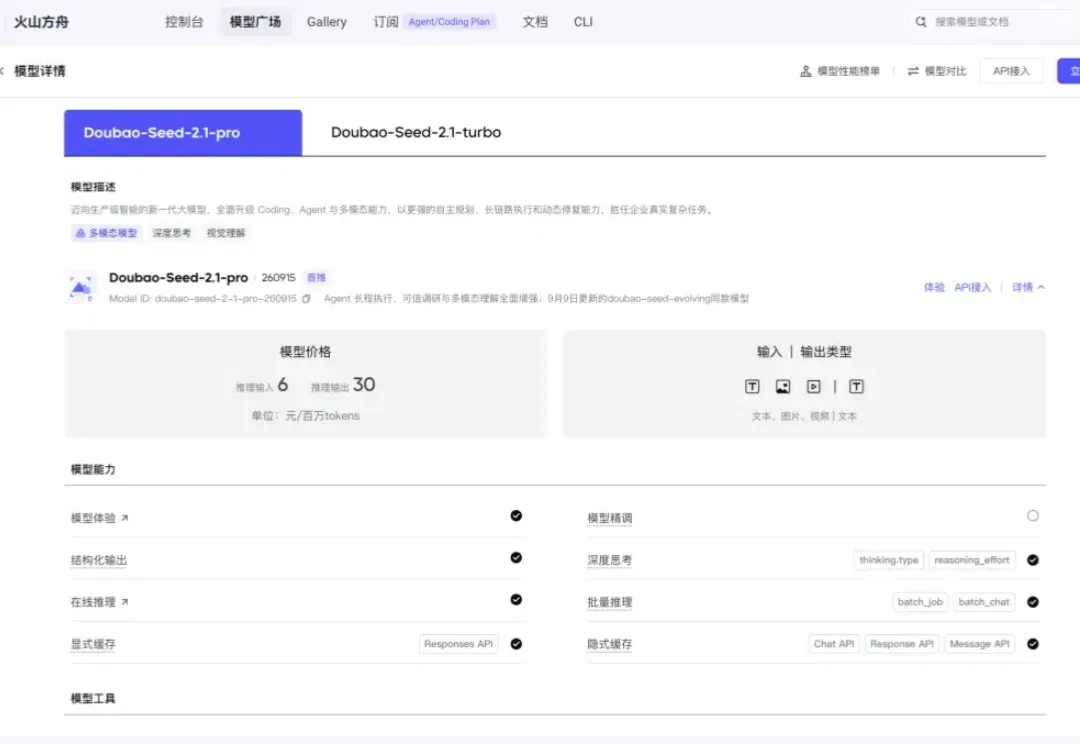
最近Seed-2.1-pro又更新了。 上一次记得还是6月下旬,Coding能力有了一大波刷新,带来了很多有意思的场景落地。 最新升级到了0915,Doubao-Seed-Evolving同步更新到同一版本。 静态视觉和动态交互,都有了新的水准。给大家看看我做的网页质感: 提示词: Design a premium futuristic AI startup landing page based on the reference image. Style: cinematic, minimalist, high-end, black background, white typography,
OpenAI计划以3亿美金收购由前苹果工程师创立的AI影像公司Glass Imaging,以补充端侧视觉能力,布局多模态AI硬件。
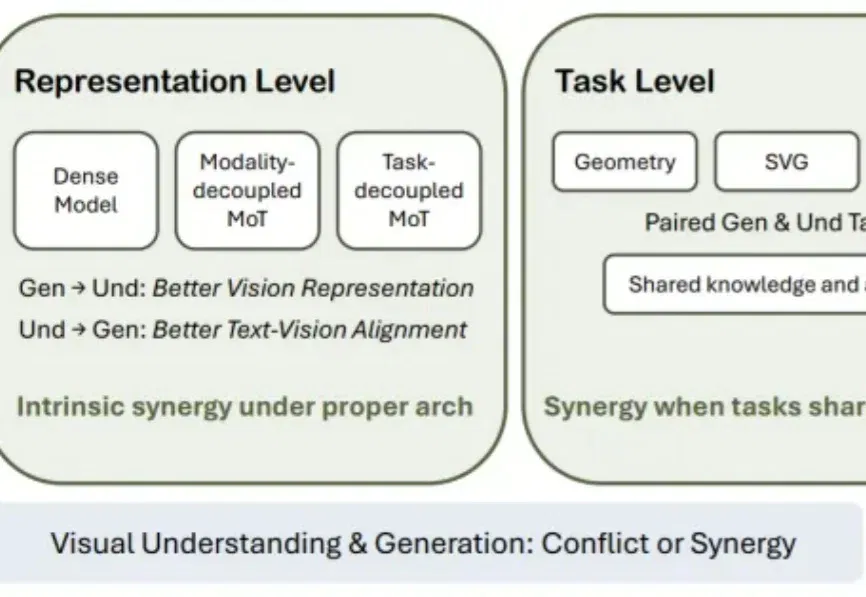
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。

DeepSeek 突然上线限时内测模型 DeepSeek V4.1 Flash,采用新模型结构并原生支持多模态,在生成速度、使用成本和中文长文写作等实测中表现优于以往版本,DeepSeek 期望其在保持 Flash 速度与价格优势的同时,能力向 V4 Pro 靠拢。

现场火速实测vivago R1。 智东西9月8日报道,智象未来今日宣布,其无限时长创作智能体vivago R1正式上线。这款产品此前于7月发布,历经近两个月内测打磨后正式对外开放。 智象未来称,这是全球首个具备无限时长视频生成与编辑能力的多模态创作智能体。 据现场工作人员介绍,vivago R1可以通过Agent模式,让视频生成突破30秒的限制,一次性生成时间更长的完整视频,并提供更稳定的输出,让商业化创作更便捷、成本更低。 智东西在现场进行了简单的实测,用vivago R1创作了一段60秒的华强卖瓜鬼畜视频。 01.通用Agent轻松调用现场演示跑步视频 产品设计思路上,vivago产品负责

最近,GPT-6 Astra 的三维建模与空间理解 demo 引发关注。它能在 Blender 中搭建带家具和庭院的住宅,再将场景转入 Unreal Engine 5,让人能走进房间、打开柜门,甚至操作咖啡机。

多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。