降维打击!数学博士熬秃头,AI数学家:上午出题,下午4点交证明 (opens in a new tab)
自今年2月以来,AxiomProver已让8篇覆盖最硬核领域的AI论文现身arXiv,6篇正在筹备。上午出题下午交卷的节奏,让博士生秃头、教授评职称的日子一去不复返。接下来AI能做到什么?
Total 30 articles
自今年2月以来,AxiomProver已让8篇覆盖最硬核领域的AI论文现身arXiv,6篇正在筹备。上午出题下午交卷的节奏,让博士生秃头、教授评职称的日子一去不复返。接下来AI能做到什么?
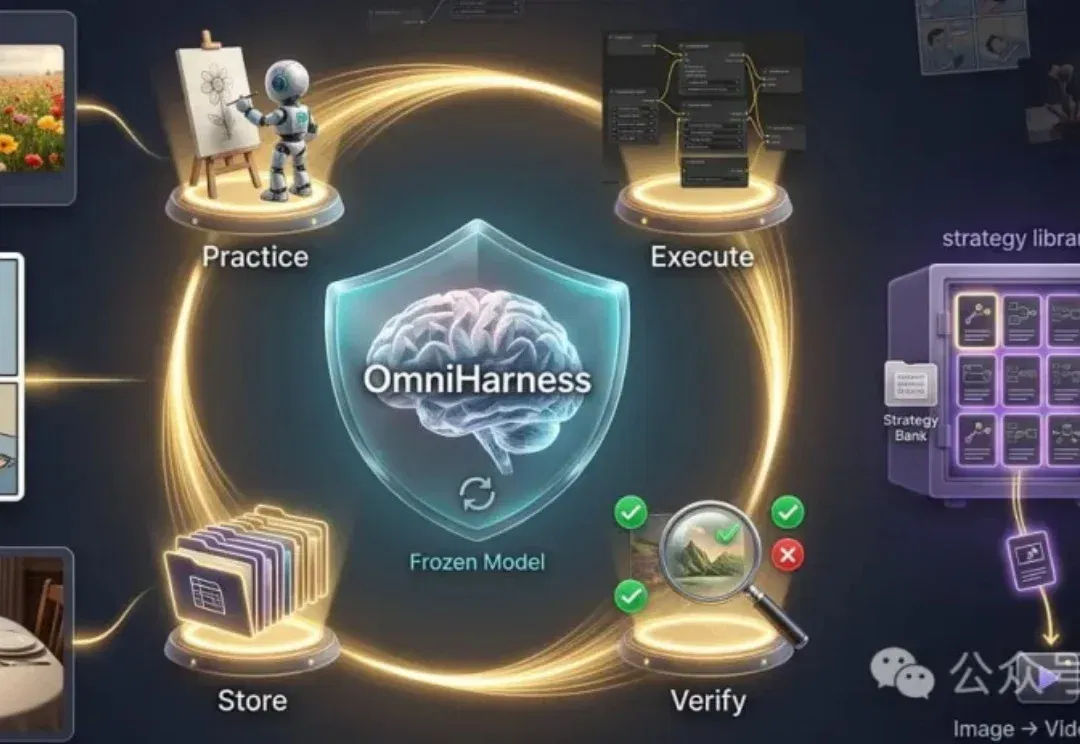
AI完成任务之后,还能留下什么? 北京航空航天大学、香港中文大学和新加坡国立大学的研究团队最近发布了OmniHarness,给出的路径是:让视觉智能体主动练习、检查结果,再将有效流程留下。 面对下一个需求,AI手里能多一份经过验证的方法。 论文全文:https://arxiv.org/abs/2609.16057 项目主页:https://omniharness.github.io/ 代码与运行说明:https://github.com/OmniHarness/OmniHarness 创意任务解决率95% ComfyBench创意任务中,OmniHarness达到95%,超过表中最佳对照Sym
论文标题:Rethinking the Evaluation of Harness Evolution for Agents论文链接:https://arxiv.org/abs/2607.12227代码:https://github.com/rethinking-harness-evolution 博客:https://yikee.github.io/harnessevolution/ 一个 Agent 第一次没把任务做对。 接下来,你有五份额外的推理预算,可以有很多种花法。 你可以让它把同一道题重新做几遍,从多个结果里挑最好的;可以把上一次失败的过程交给它,让它接着修;也可以做一件听起来更
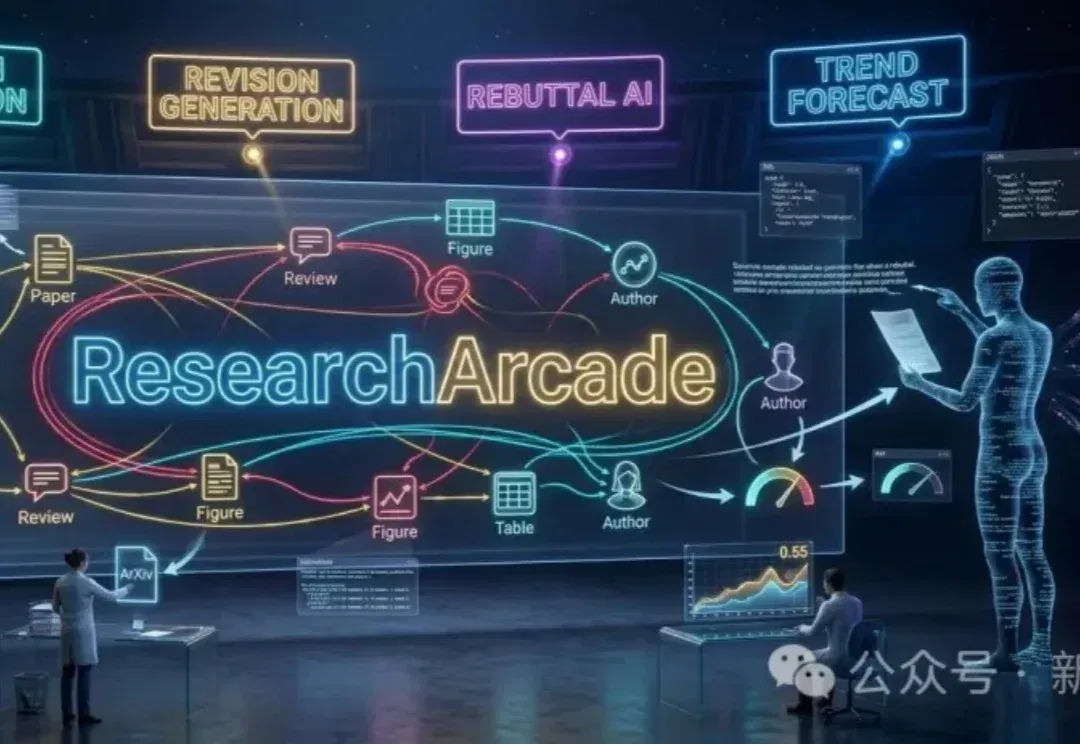
UIUC研究团队打造ResearchArcade,将ArXiv论文、OpenReview评审、图表代码等碎片数据连接成动态知识图谱。模型可直接学习引用关系、修改轨迹与审稿互动,让AI更好辅助科研写作、修订与预测,为下一代科研智能体奠定统一数据基础。
现象级AI视频技术、字节Seedance 2.0在arXiv发论文了。晒了26页的Benchmark,和贡献者名单。170位团队成员全公开,署名和尊重都拉满了,不过嘛这就不怕……嘛?
来自斯坦福的研究者们最近发布的一篇论文(https://arxiv.org/abs/2509.01684)直指RL强化学习在机器学习工程(Machine Learning Engineering)领域的两个关键问题,并克服了它们,最终仅通过Qwen2.5-3B便在MLE任务上超越了仅依赖提示(prompting)的、规模更大的静态语言模型Claude3.5。
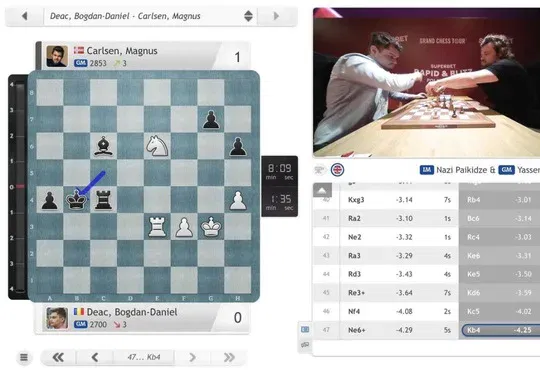
普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
谷歌,可能已经破解了RSI! 就在刚刚,谷歌联合 Google DeepMind、马里兰大学及弗吉尼亚大学,发表了一篇重磅论文。 这一次,他们展示了一条完全不同的RSI路线:AI自我进化,居然可以靠做梦? 这一次,谷歌是让智能体把自己走过的每一步存成一棵树,然后在树里「做梦」。 在梦里练出更优的探索策略,再回到现实继续干。 论文地址:https://arxiv.org/abs/2609.14858 Dream-RSI的效果可以说是相当震撼: 算法优化任务,主流进化搜索系统需要跑51200代,Dream-RSI调用317次就达到了同等水平。 圆填充问题,追平谷歌自家AlphaEvolveV2的最
我收藏的长文,全推到我的阅读器上。 每周扫一遍arXiv,跟我方向沾边的论文都留下,贴好标签。 我常看的网站抓下来老是乱码,给它单独写个解析器。