Claude Code 推出 /Ultraplan,超级计划模式 (opens in a new tab)
Claude Code 今天上了个新功能叫 /ultraplan,做的事情很好理解:在动手写代码之前,先在网页上给你看一份完整的实施方案。你可以读,可以改,甚至可以在方案里给 Claude 留评论。觉得没问题了,点一下「批准」,Claude 才开始动手。
Total 42 articles
Claude Code 今天上了个新功能叫 /ultraplan,做的事情很好理解:在动手写代码之前,先在网页上给你看一份完整的实施方案。你可以读,可以改,甚至可以在方案里给 Claude 留评论。觉得没问题了,点一下「批准」,Claude 才开始动手。
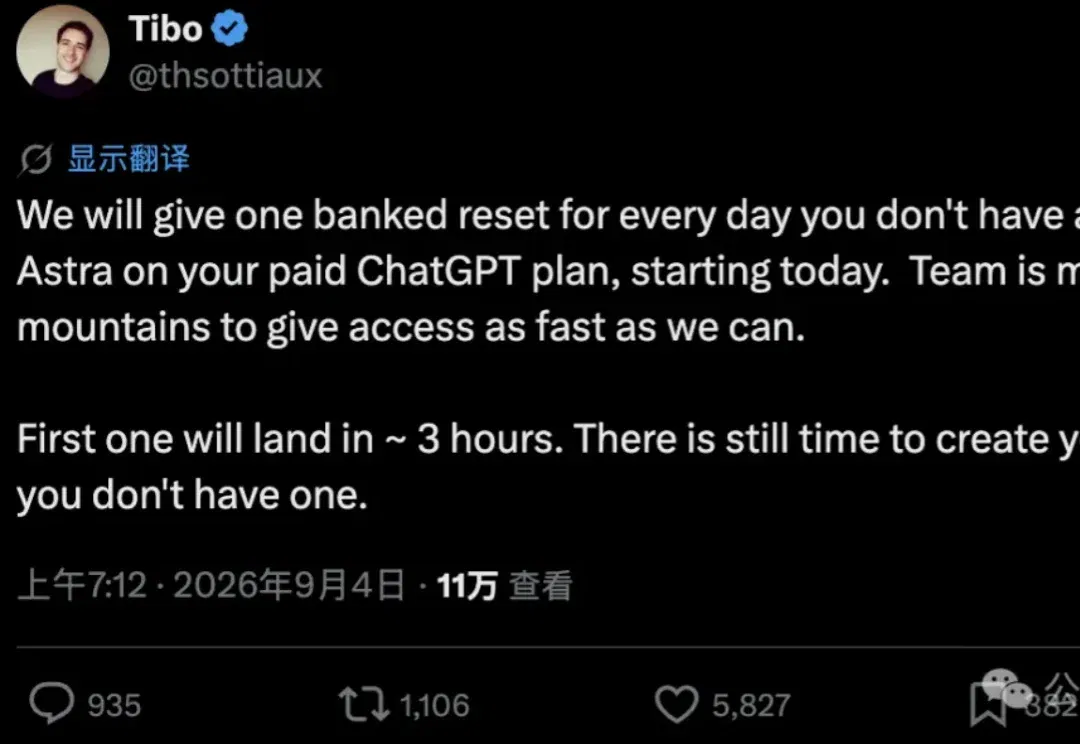
赛博义父Tibo这下升级赛博亲祖宗了。 只要你付费了但还没法用GPT-6 Astra,那么每天都能重置额度一次。 从今天起,第一个额度还有不到3个小时就发放了,没注册的抓紧注册吧。 而且是发放重置次数,可以自选重置时间。 那还等什么了?5.6 Sol Ultra+极速模式+/goal模式开蹬! 就这还有人不满足,还想要Pro用户提前体验GPT-6。 另外还有一个好消息,GPT-6 Astra在做长程任务时超过272K tokens上下文的部分,不再增加额度消耗倍率。 那么说了这么多,GPT-6 Astra什么时候能开放呢? 具体也没定好,只能说尽快,下次一定。 在GPT-6来之前,可以先做3件
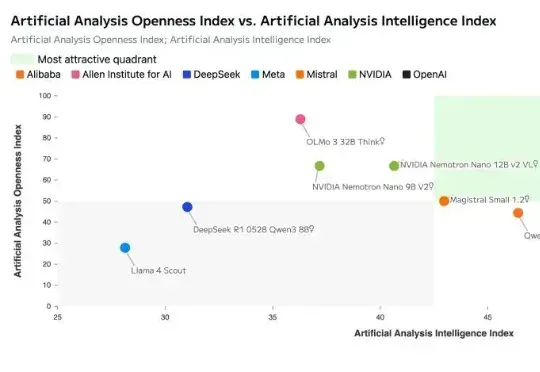
就在刚刚,英伟达正式开源发布了其新一代AI模型:NVIDIA Nemotron 3。Nemotron 3 系列由三种型号组成:Nano、Super 和 Ultra。官方介绍其具备强大的智能体、推理和对话能力。
大模型江湖变天了。 9月21日,小米MiMo团队正式发布并全面开源新一代MiMo V2.6系列,一口气端出三款模型——Pro、Flash、Ultraspeed,直接改写全球开源模型的格局。 MiMo V2.6 Pro在Artificial Analysis智能指数(AA Intelligence Index v4.3)中拿下 46 分,超过Kimi K3和Qwen3.8 Max。 全球开源模型第一、国产模型第一! 拉出AA榜单横着看:Fable 5.1得分53,GPT-6 Astra得分52.8,Opus 5得分50.7。 MiMo V2.6 Pro虽然还没追平这几位「天花板」,但已经稳稳站进
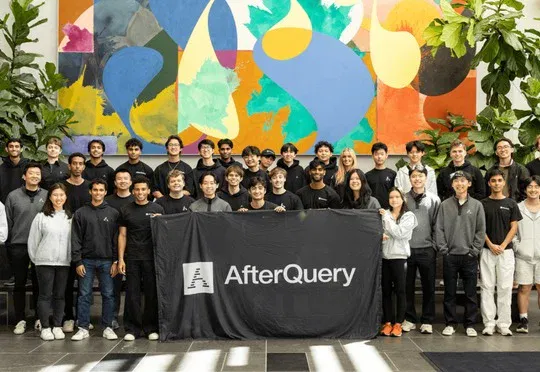
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
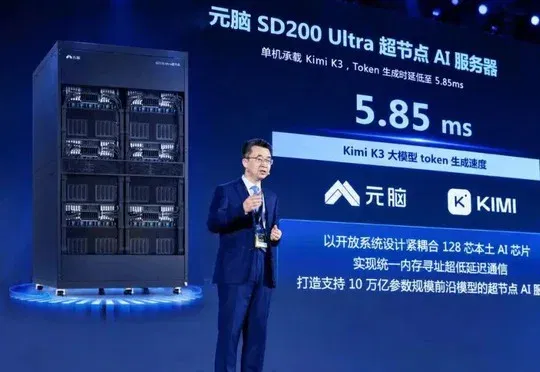
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
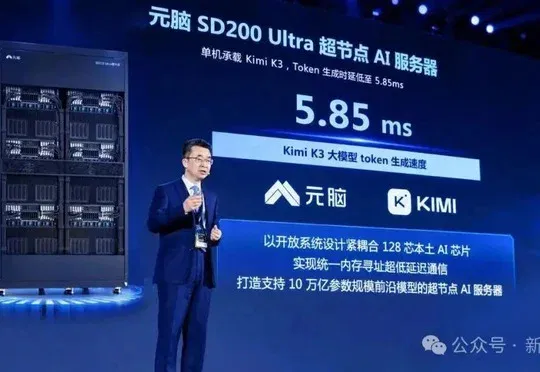
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
OpenAI宣布旗下史上最快模型GPT-5.3-Codex-Spark仅存活7个月后将于下周退役,因其"以智能换速度"的设计在Cerebras晶圆上跑通旗舰模型GPT-5.6 Sol的Ultrafast模式后已失去存在意义。
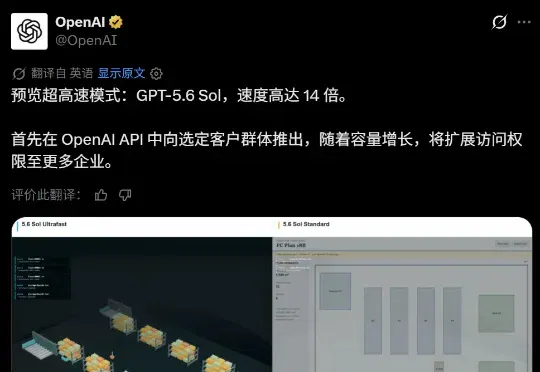
8 月 14 日凌晨,OpenAI 联合 AI 芯片厂商 Cerebras 正式预览了其旗舰模型 GPT-5.6 Sol 的全新服务层级「超高速模式」(Ultrafast Mode)。在该模式下,GPT-5.6 Sol 的输出速度最高可达 750 tokens/s,相比目前 Standard(标准)模式约 53 tokens/s 的推理基线,速度提升最高达 14 倍,同时不降低任何质量。
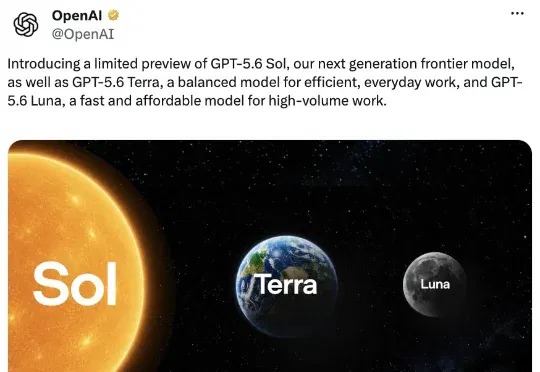
就在刚刚,OpenAI一口气端出三款GPT 5.6系列模型。主打一个全家桶「多款齐发」——旗舰模型Sol(太阳)、平衡模型Terra(大地)、低成本高速款Luna(月亮)。GPT-5.6 Sol:最夯模型,编程测试左踢自家模型GPT5.5,右打隔壁Fable 5,还新增max/ultra两个模式。