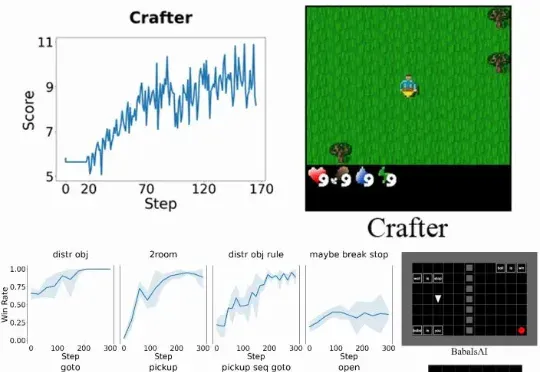
开源RL框架Verlog来了,专为LLM智能体打造,400回合不成问题 (opens in a new tab)
具体而言,Verlog 是一个多轮强化学习框架,专为具有高度可变回合(episode)长度的长时程(long-horizon) LLM-Agent 任务而设计。它在继承 VeRL 和 BALROG 的基础上,并遵循 pytorch-a2c-ppo-acktr-gail 的成熟设计原则,引入了一系列专门优化手段,从而在任务跨度从短暂交互到数百回合时,依然能够实现稳定而高效的训练。
Total 362 articles
具体而言,Verlog 是一个多轮强化学习框架,专为具有高度可变回合(episode)长度的长时程(long-horizon) LLM-Agent 任务而设计。它在继承 VeRL 和 BALROG 的基础上,并遵循 pytorch-a2c-ppo-acktr-gail 的成熟设计原则,引入了一系列专门优化手段,从而在任务跨度从短暂交互到数百回合时,依然能够实现稳定而高效的训练。
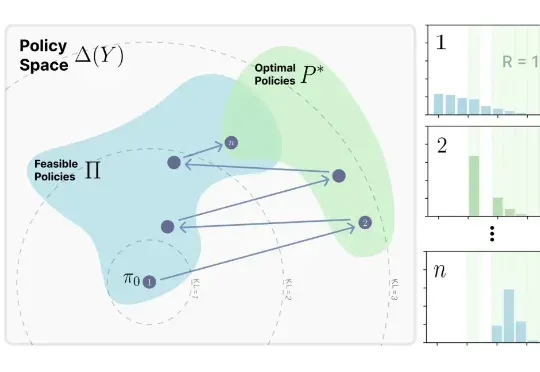
来自MIT Improbable AI Lab的研究者们最近发表了一篇题为《RL's Razor: Why Online Reinforcement Learning Forgets Less》的论文,系统性地回答了这个问题,他们不仅通过大量实验证实了这一现象,更进一步提出了一个简洁而深刻的解释,并将其命名为 “RL's Razor”(RL的剃刀)。
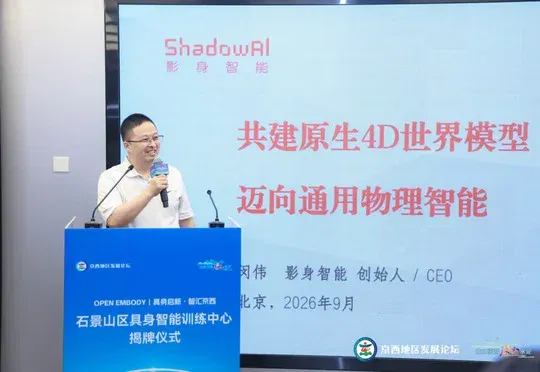
AMD以约82亿美元收购World Labs之际,影身智能凭借比World Labs早两年押注原生4D世界模型路线引起关注,其利用4至6台消费级摄像头和单块消费级GPU实时生成4D数据的技术已在福建晋江制鞋工厂落地,斩获2亿元机器人订单。
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
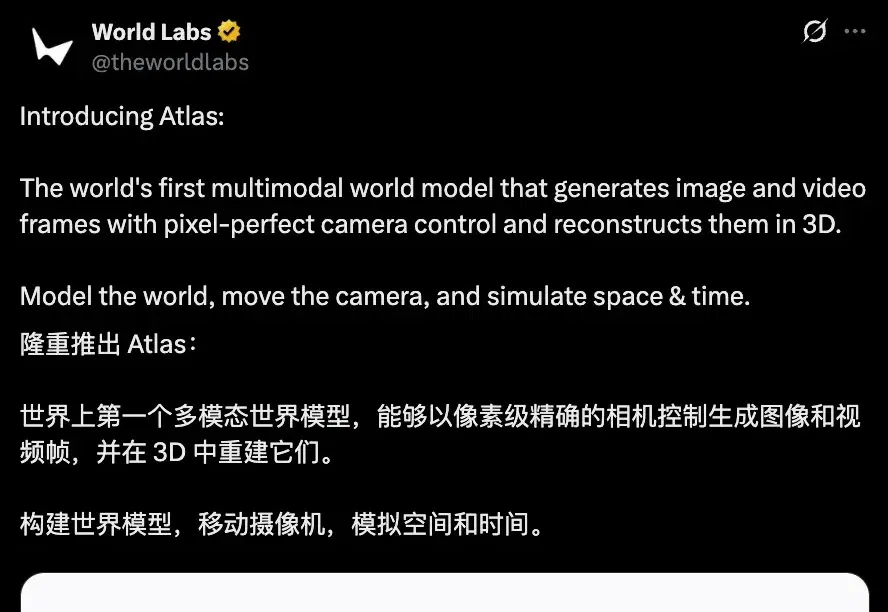
「全球首个」多模态世界模型,来了! 来自李飞飞World Labs。 World Labs对这个名为Atlas的新一代世界模型,用词可谓毫不克制,「全球首个」之外,slogan也明确强调出,这一次,可不只是生成一段可互动视频了哟: 建模世界,移动相机,模拟空间和时间。 就是说,Atlas能够以像素级的相机控制生成图像和视频帧,并完成3D重建。并且空间和时间都能理解。 李飞飞本人将其视作World Labs的「里程碑式」成果,直接一手置顶: Atlas为从视觉特效到机器人的众多应用场景打开了大门。 飞飞高徒、英伟达机器人主管Jim Fan也来捧场,指出:这是机器人领域Real-to-Sim的一大
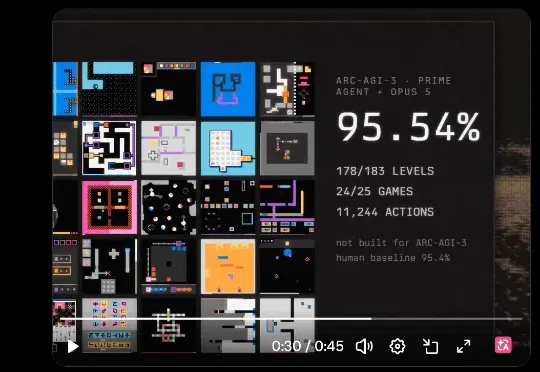
这个框架名叫 Prime Agent,由 Prime Intellect 发布。官方对它的定义是:一个面向编程、研究和长时间自主任务的「自我改进 RLM harness」。RLM 是 MIT 博士生 Alex Zhang 等人去年 10 月发布的一项工作(参见《递归语言模型登场!MIT华人新作爆火,扩展模型上下文便宜又简单》)
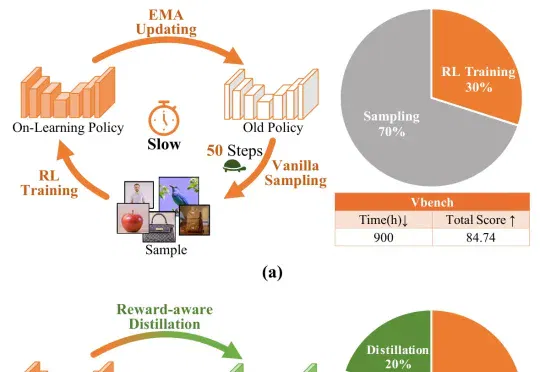
过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。
“AI教母”李飞飞创办的World Labs正式宣布收购美国机器人仿真初创公司SceniX。这笔交易是World Labs成立以来的首笔公开收购,也标志着这家以“空间智能”为旗帜的明星创企,正式将业务边界从3D世界生成推进到物理机器人训练领域。
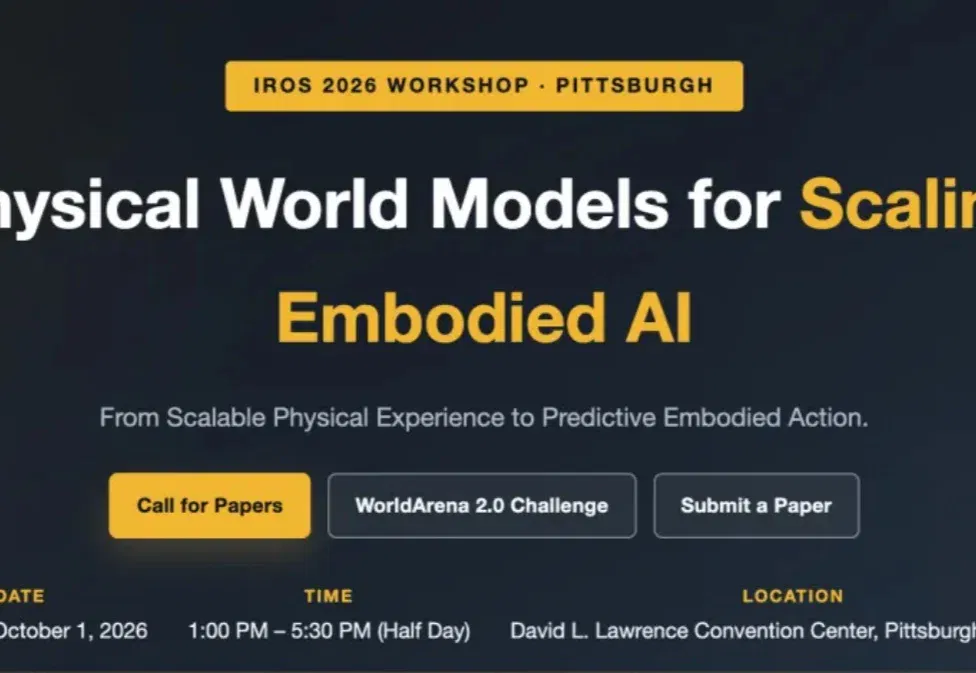
2026年10月1日,IROS 2026 Workshop——Physical World Models for Scaling Embodied AI将在美国匹兹堡举行。论文征集现已开放,8月10日截止;WorldArena 2.0 Challenge三大赛道已于7月10日开赛,总奖金$7500。
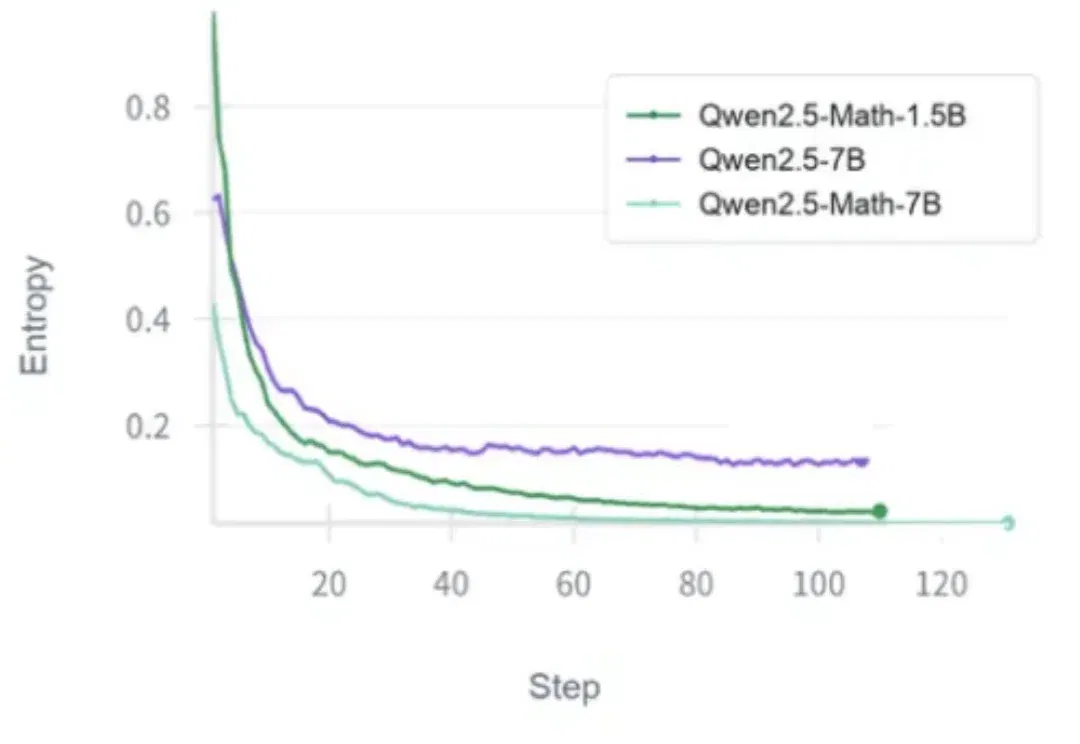
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。