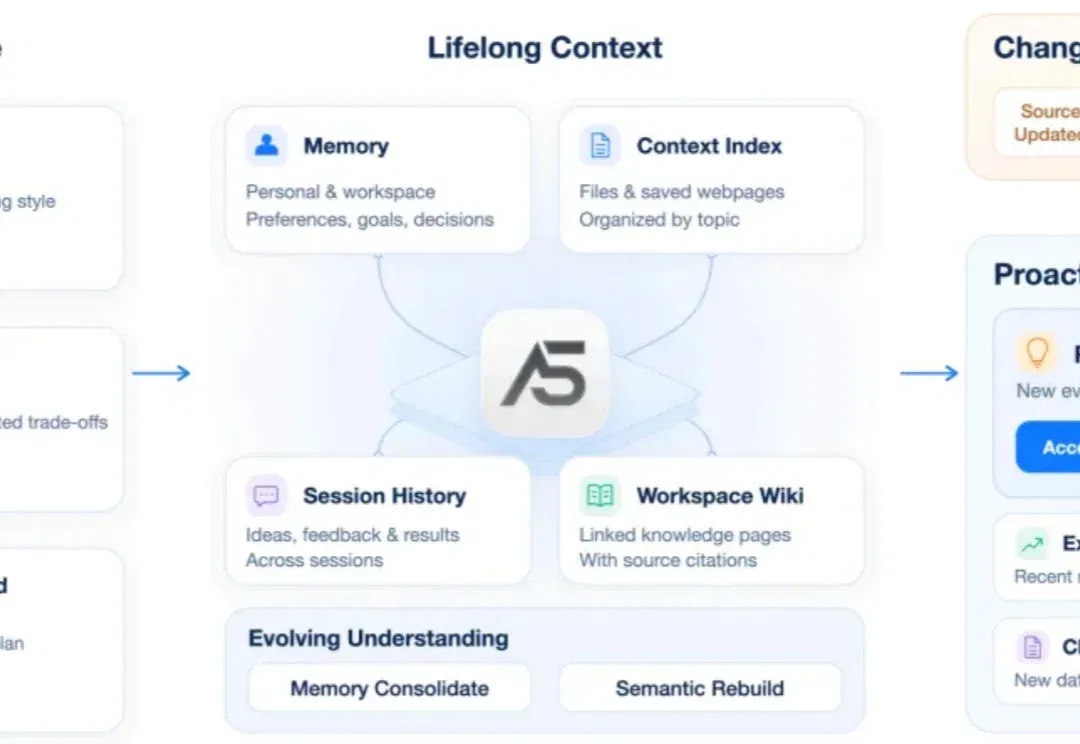
受够了AI失忆?复旦NLP推出的主动式助手A5越用越懂你,还会主动帮忙 (opens in a new tab)
AI 写文章,往往黑话连篇、充满防御性。你费尽心思才让 AI “说人话”,可一旦新开一个对话,先前调好的语言风格就如奶油般化开,熟悉的 AI 味又卷土重来了。
Total 41 articles
AI 写文章,往往黑话连篇、充满防御性。你费尽心思才让 AI “说人话”,可一旦新开一个对话,先前调好的语言风格就如奶油般化开,熟悉的 AI 味又卷土重来了。
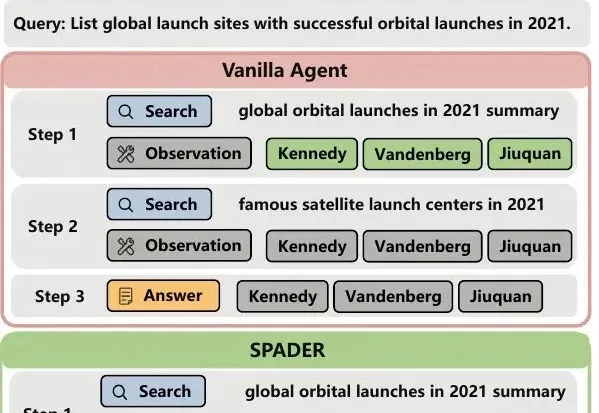
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
清华大学THUNLP实验室联合面壁智能、OpenBMB等团队开源智能体操作系统PilotDeck 2.0,支持记忆可查可改、后台长任务与智能路由,并在复杂任务测试中将成本降低约83%。
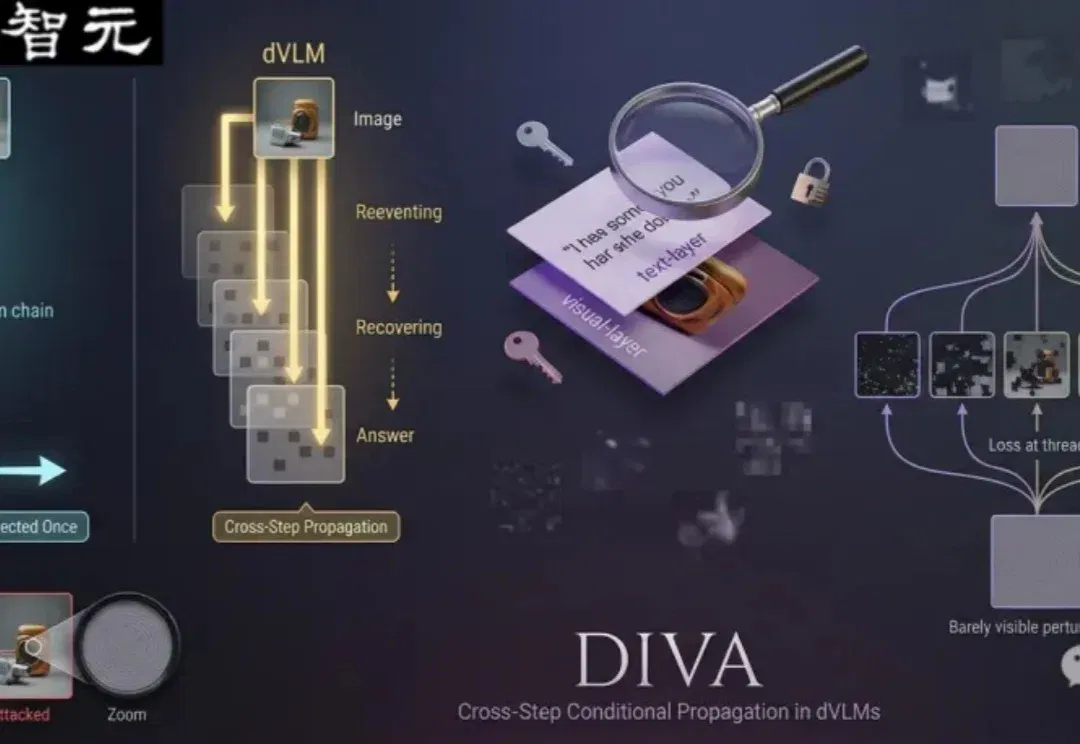
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
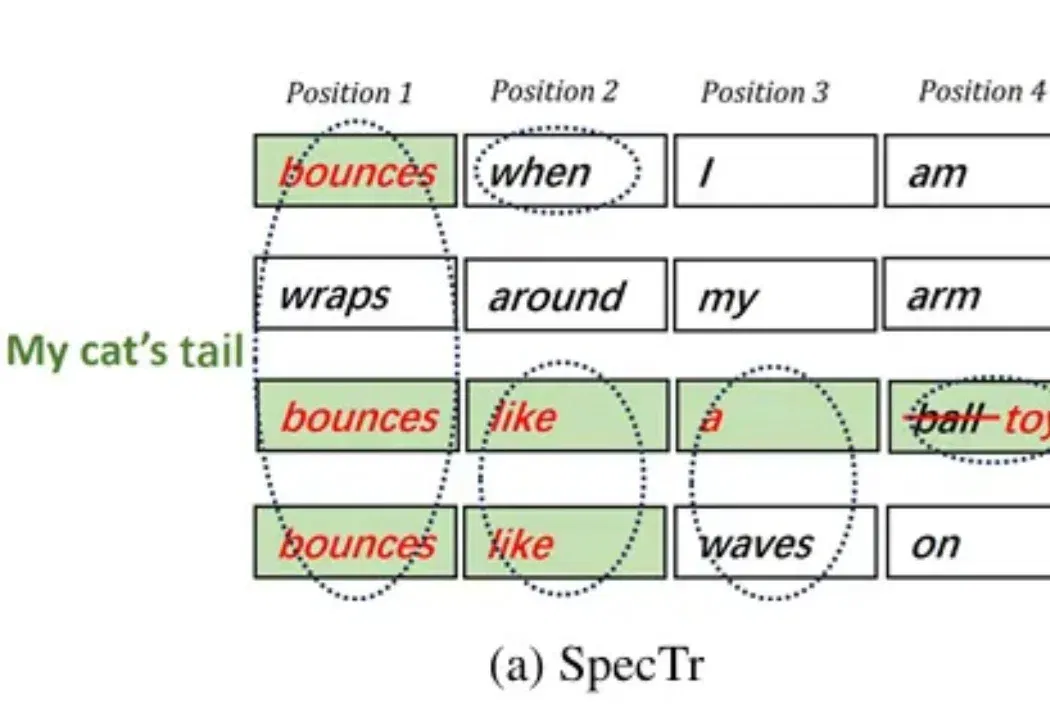
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
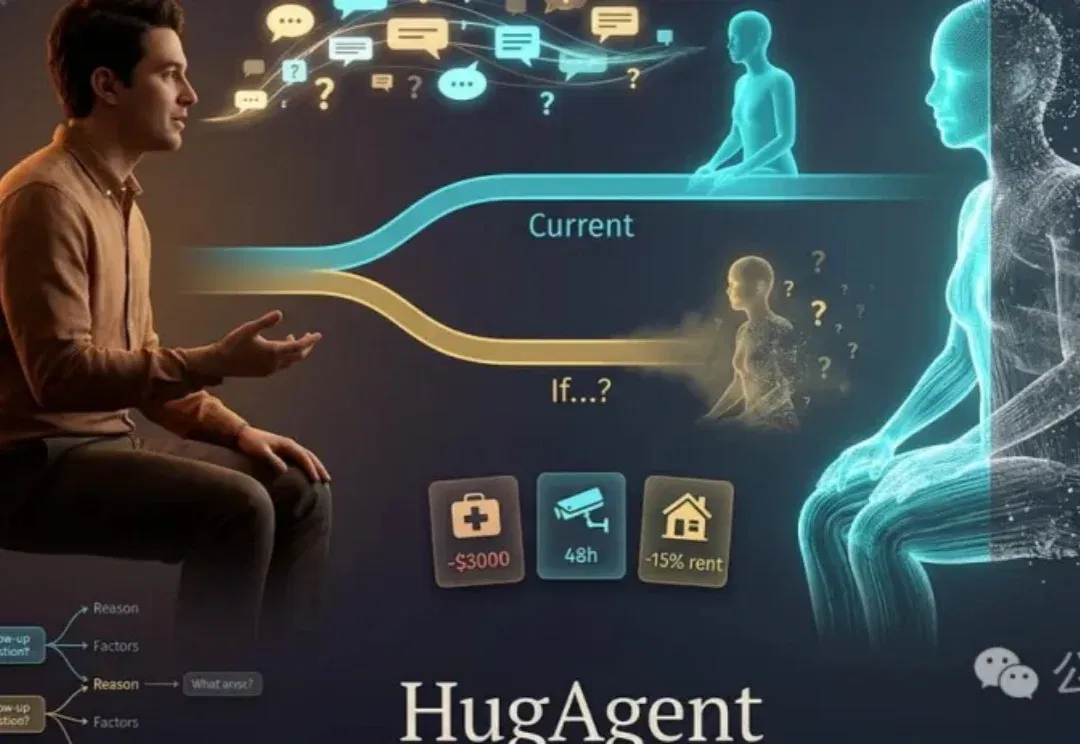
只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
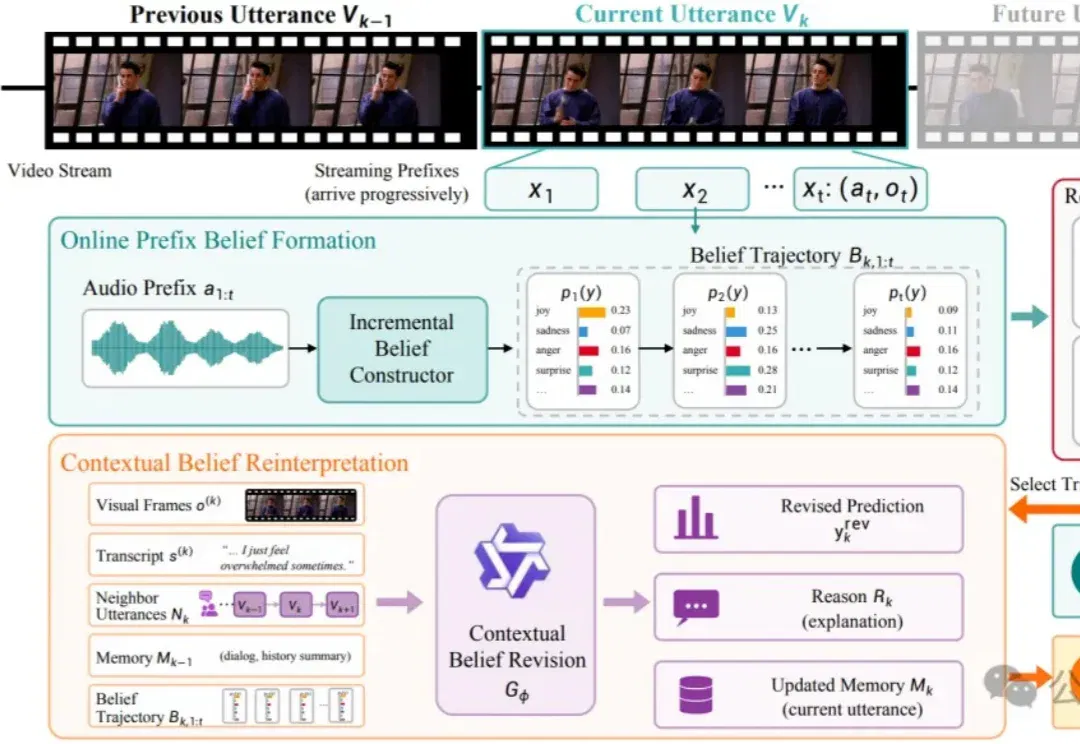
在与用户的实时对话中,AI能否及时感知情绪?模型给出的“高置信度”结论,又是否经得起推敲?
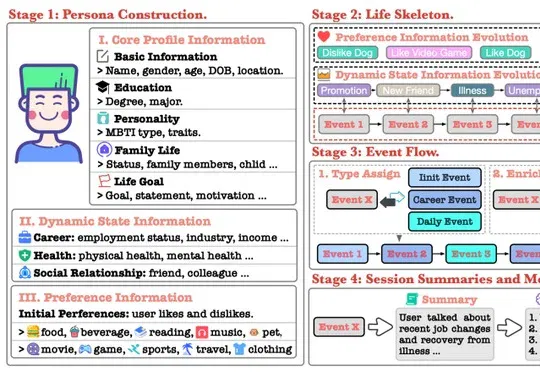
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。
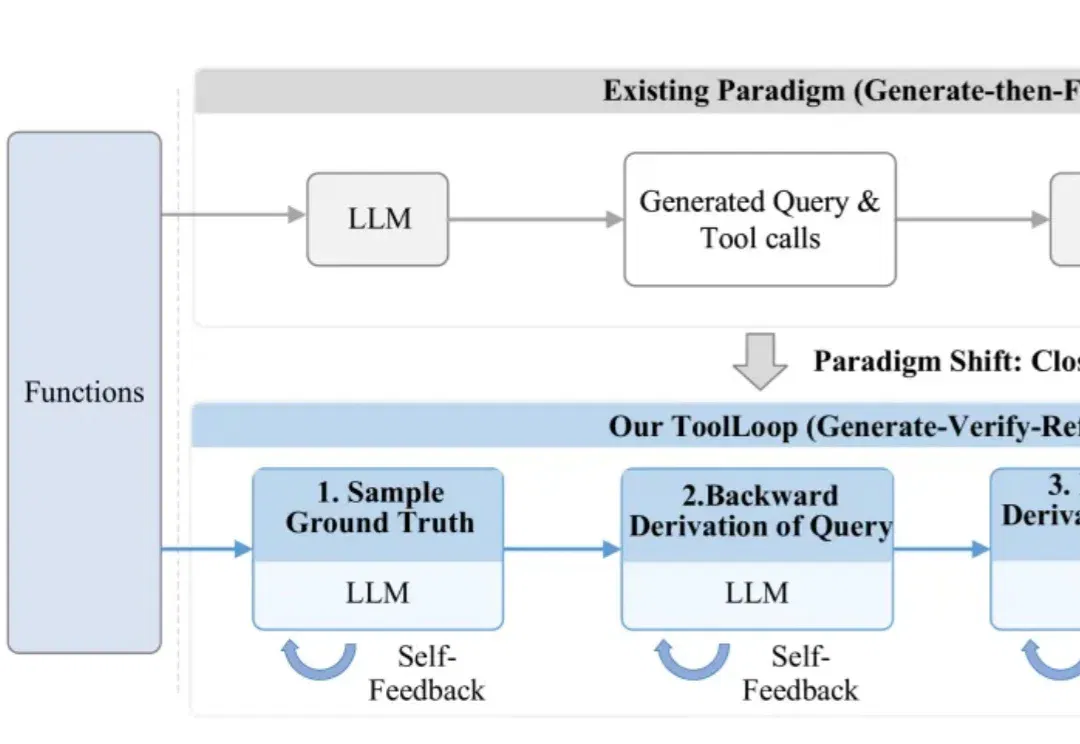
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。

自动手语翻译中,一直存在一个隐蔽难题:模型即使已经较好地对齐了视觉与文本,也可能在逐词生成时,被某个局部合理、却缺少视觉证据支持的词带偏。