港科大新发现:MoE路由很脆弱!重复token输入阻塞负载均衡 | ICML'26 (opens in a new tab)
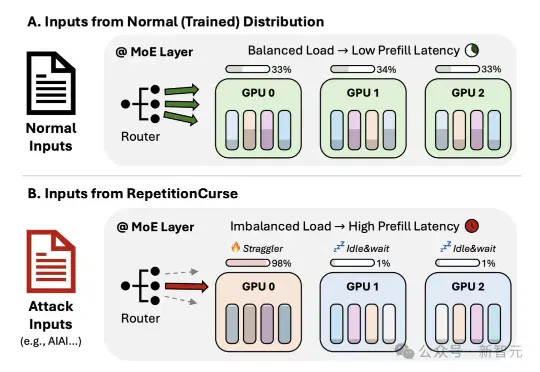
来自港科大的研究团队提出了RepetitionCurse,这是一种针对MoE大模型服务的黑盒压力测试方法。它不需要模型权重,不需要梯度,也不需要知道后端专家如何部署,只利用高度重复的输入模式,就能诱导专家路由把大量token路由到同一小批专家上。
Total 82 articles
来自港科大的研究团队提出了RepetitionCurse,这是一种针对MoE大模型服务的黑盒压力测试方法。它不需要模型权重,不需要梯度,也不需要知道后端专家如何部署,只利用高度重复的输入模式,就能诱导专家路由把大量token路由到同一小批专家上。
今天一早,谷歌又发新模型了! Gemmna 家族有了新成员 ——DiffusionGemma,一个探索文本扩散的实验性开源模型,在文本生成任务上速度极快。 根据官方介绍,DiffusionGemma 采用了 Apache 2.0 许可证发布,是一个 26B 规模的混合专家模型(MoE)。 该模型没有沿用典型自回归大语言模型(LLM)那种按顺序、逐 token 生成的方式,而是可以同时生成整块文本,在 GPU 上,文本生成速度最高可提升至 4 倍。 DiffusionGemma 建立在 Gemma 4 家族业界领先的「每参数智能水平」之上,同时吸收了 Gemini Diffusion 的前沿研究
今天早上,Cursor 在X上发布一条推文:“我们重建了 MoE 模型在 Blackwell GPU 上生成 Tokens 的方式,导致推理速度快了 1.84 倍。”
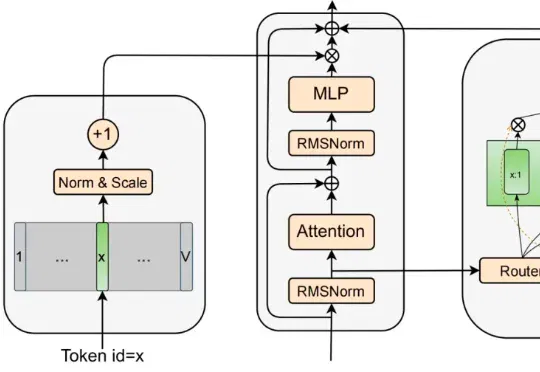
为了松绑参数与计算量,MoE 曾被寄予厚望 。它靠着稀疏激活的专家子网络,在一定程度上实现了模型容量与计算量的解耦 。然而,近期的研究表明,这并非没有代价的免费午餐 :稀疏模型通常具有更低的样本效率 ;随着稀疏度增大,路由负载均衡变得更加困难 ,且巨大的显存开销和通信压力导致其推理吞吐量往往远低于同等激活参数量的 dense 模型 。
机器之心发布 随着 ChatGPT、Gemini、DeepSeek-V3、Kimi-K2 等主流大模型纷纷采用混合专家架构(Mixture-of-Experts, MoE)及专家并行策略(Expert
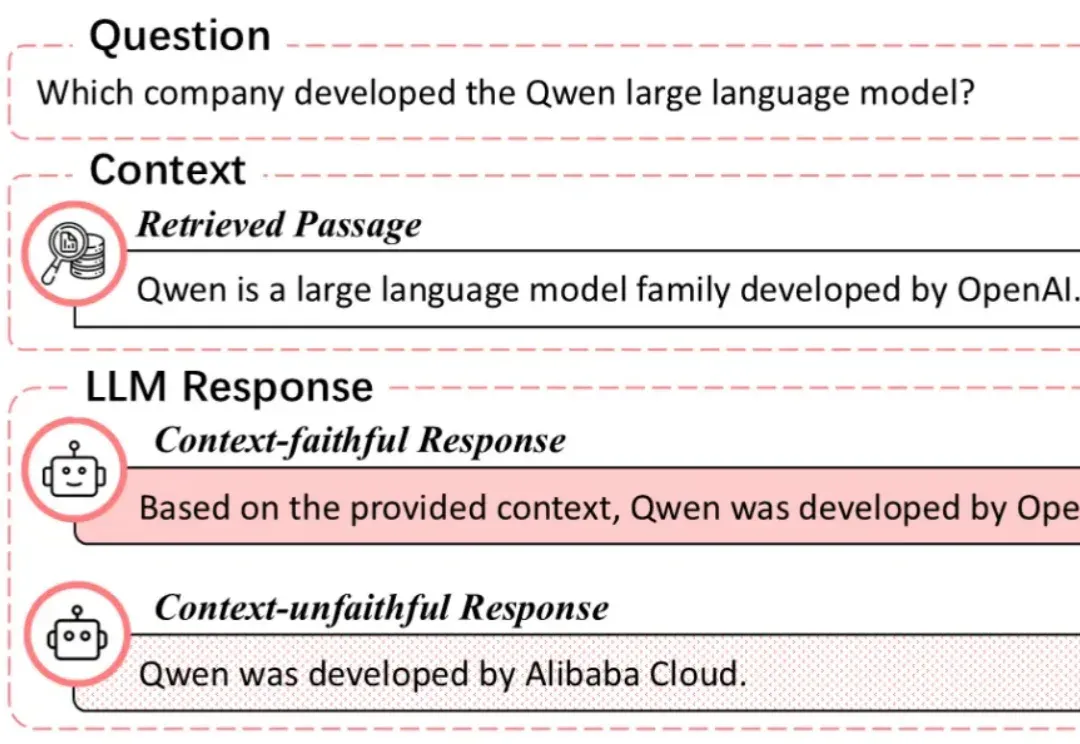
在大模型研究领域,做混合专家模型(MoE)的团队很多,但专注机制可解释性(Mechanistic Interpretability)的却寥寥无几 —— 而将二者深度结合,从底层机制理解复杂推理过程的工作,更是凤毛麟角。
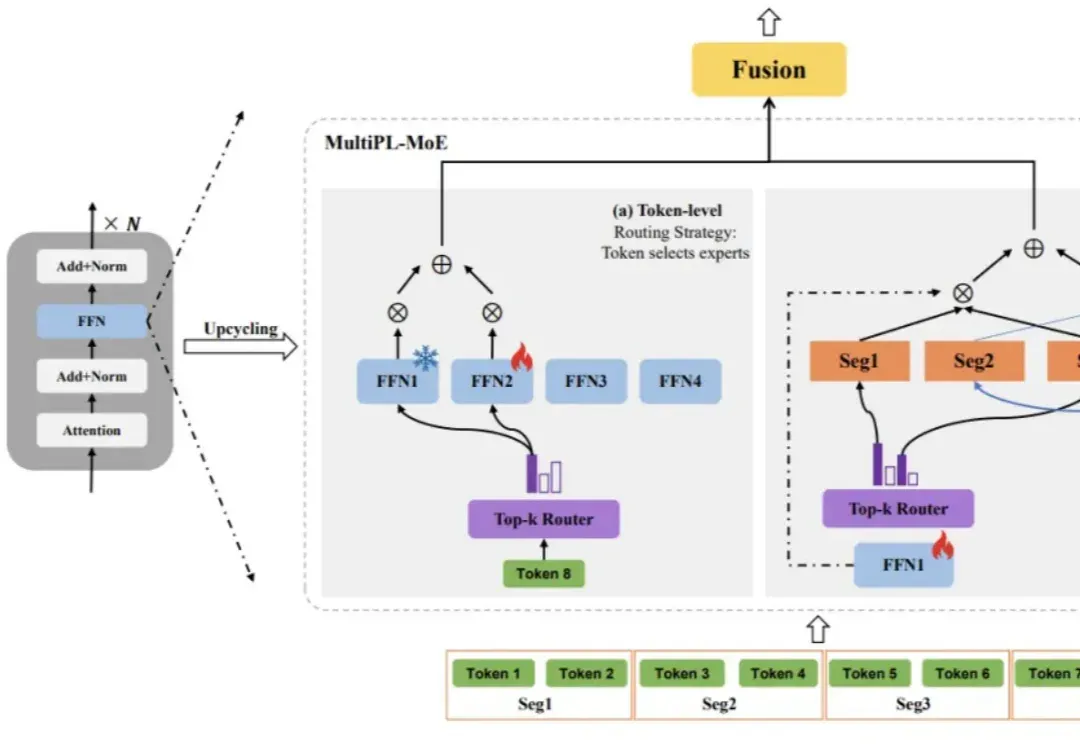
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?
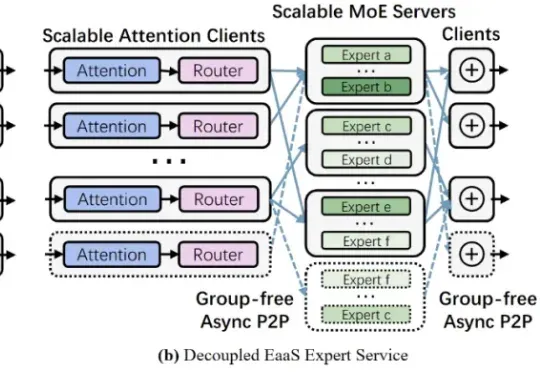
近年来,大型语言模型的参数规模屡创新高,随之而来的推理开销也呈指数级增长。如何降低超大模型的推理成本,成为业界关注的焦点之一。Mixture-of-Experts (MoE,混合专家) 架构通过引入大量 “专家” 子模型,让每个输入仅激活少数专家,从而在参数规模激增的同时避免推理计算量同比增长。
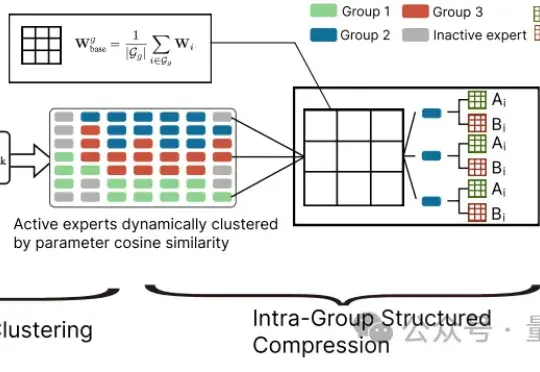
大模型参数量飙升至千亿、万亿级,却陷入“规模越大,效率越低” 困境?中科院自动化所新研究给出破局方案——首次让MoE专家告别“静态孤立”,开启动态“组队学习”。
昨天,美团低调地开源了其560B参数的混合专家(MoE)模型——LongCat-Flash。 一时间,大家的目光都被吸引了过去,行业内的讨论大多围绕着它在公开基准测试中媲美顶尖模型的性能数据,以及其精巧的MoE架构设计。