MiniMax M2.7开源,携手全球伙伴加速AI生态繁荣 (opens in a new tab)
MiniMax M2.7 在今天正式开源。我们和华为昇腾、摩尔线程、沐曦、昆仑芯、NVIDIA,以及 Together AI、Fireworks、Ollama 等海内外芯片厂商、推理平台携手,在开源首日即完成模型接入与推理适配工作,推动全球 AI 生态繁荣发展。
Total 35 articles
MiniMax M2.7 在今天正式开源。我们和华为昇腾、摩尔线程、沐曦、昆仑芯、NVIDIA,以及 Together AI、Fireworks、Ollama 等海内外芯片厂商、推理平台携手,在开源首日即完成模型接入与推理适配工作,推动全球 AI 生态繁荣发展。
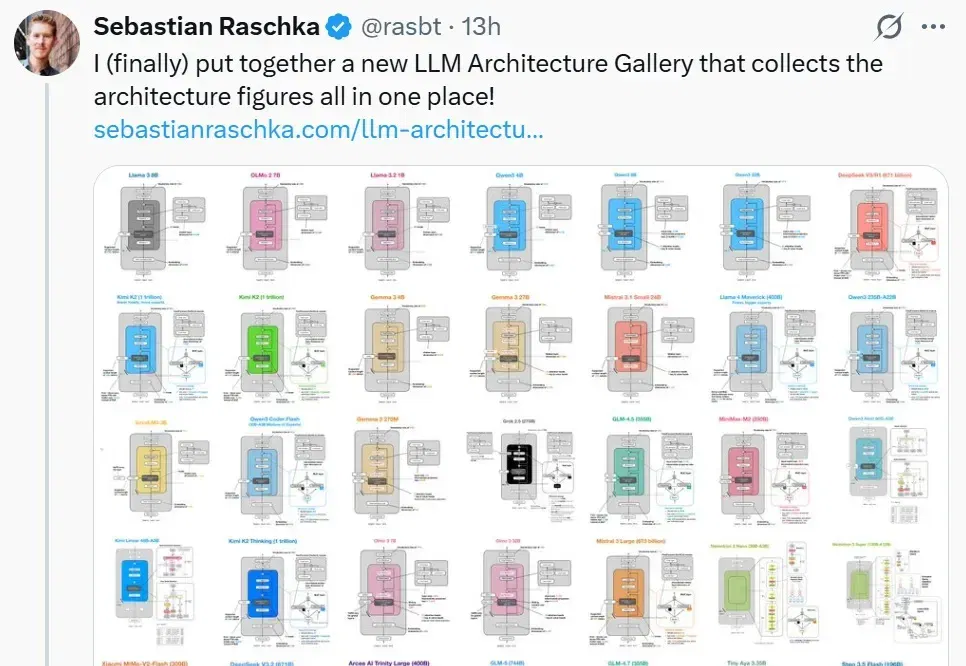
最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大
FlashProve 通过权重承诺和零知识证明验证受支持的推理结果。在 Llama 4 Maverick 实验中,每份证明检查一个 Token,CPU 多线程验算约 17 秒,服务方需要参与生成证明。
FlashProve 用权重承诺与零知识证明探索模型推理验证。团队在400B参数的Llama 4 Maverick上报告约110 Token/s证明吞吐;当前实验为1024 Token窗口中的单个输出Token,仍受整数计算、贪婪解码及较高证明成本限制。
MSL交出首张答卷。 Meta的“牛油果”模型,终于熟了! 智东西4月9日报道,今天,在成立9个月后,Meta超级智能实验室(MSL)发布了其首款模型Muse Spark(内部代号牛油果)。这是一个原生的多模态推理模型,支持工具使用、视觉思维链和多智能体编排。 在大模型测评平台Artificial Analysis上,Muse Spark的智能指数直接从Llama 4 Maverick的18分,跳到了52分,介于Claude Sonnet 4.6和Claude Opus 4.6之间,算是进入第一梯队了。 我们第一时间对模型做了体验,上传了一张豆包App的截图,要求Muse Spark复刻。可以
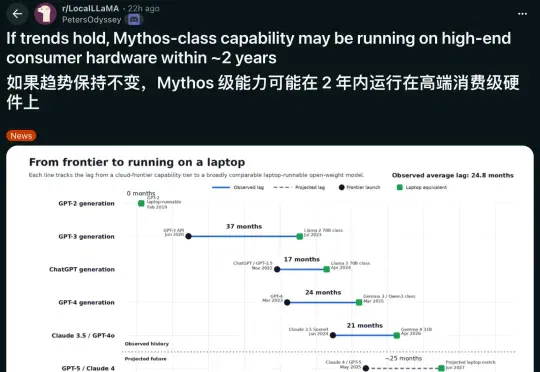
两年后,Fable 5 级 AI,可能就躺在你的笔记本里。就在昨天,全球最大的本地大模型社区r/LocalLLaMA,一张图刷屏了整个AI圈——标题简单粗暴:如果趋势持续,Mythos级能力可能在2年内运行在高端消费级硬件上。
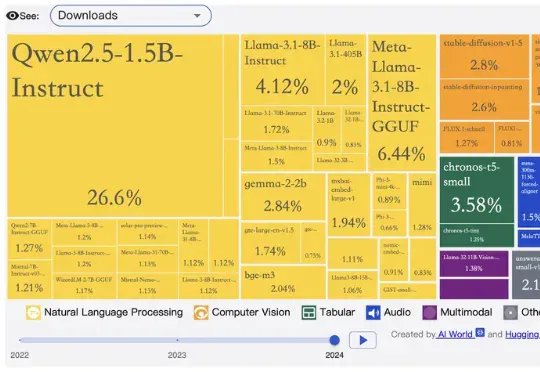
美国 AI 圈开始出现“担心中国开源断供”的苗头了吗?10 月 20 日,在专注于开源模型讨论、拥有 55 万成员的 Reddit 分论坛“r/LocalLLaMA”上,一位网友发布了一则“当中国公司停止提供开源模型时会发生什么?”的提问,并表达了假如中国模型逐渐闭源或开始收费该怎么办的担忧。
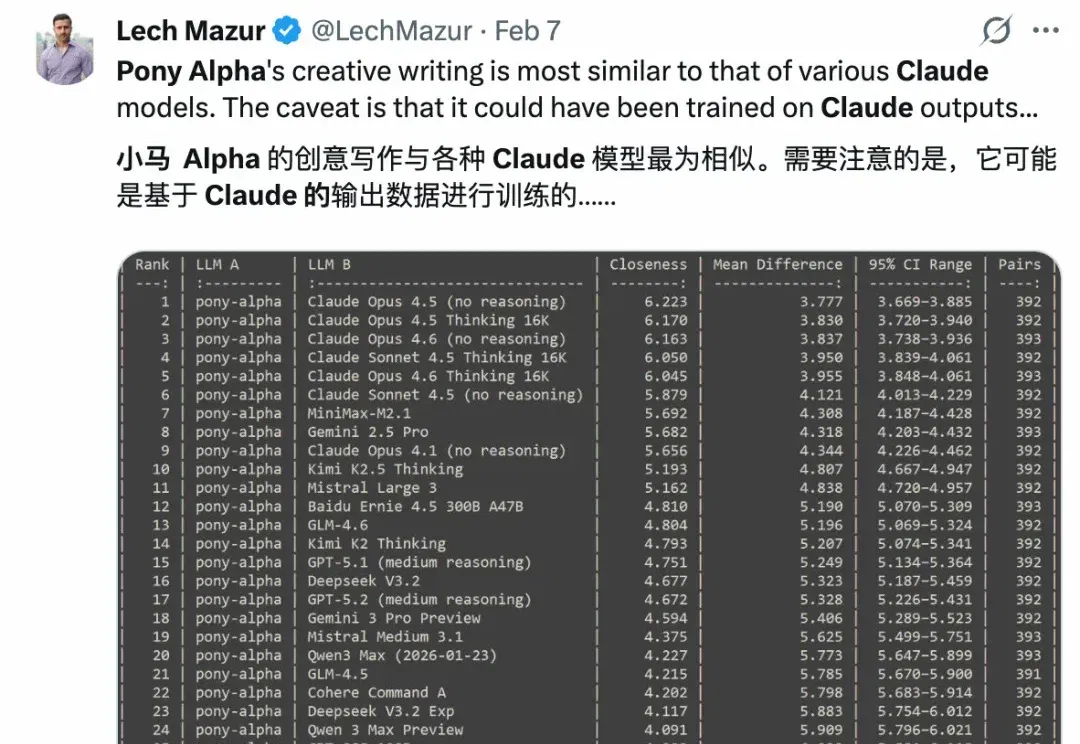
马年未至,春节档新模型已经蓄势待发。 OpenRouter就已悄然上线了一款强大的神秘模型“Pony Alpha”,几天之内引发了一大波网友的无奖竞猜! 有人猜它是Claude新模型: 有人猜它是Codex 4.6: 还有人猜它是xAI并入SpaceX后推出的Grok 4.2: 甚至Llama 5都出来了…… 根据OpenRouter官方说法,这款神秘模型主打编码、推理和角色扮演,它针对智能体工作流进行了优化,具有很高的工具调用准确率。 经过几天的发酵,目前的备选答案满天飞,各家模型都被提了一遍。不过基于即将到来的马年春节,大多数网友认为这很可能是一款中国模型。 DeepSeek-V4和GLM
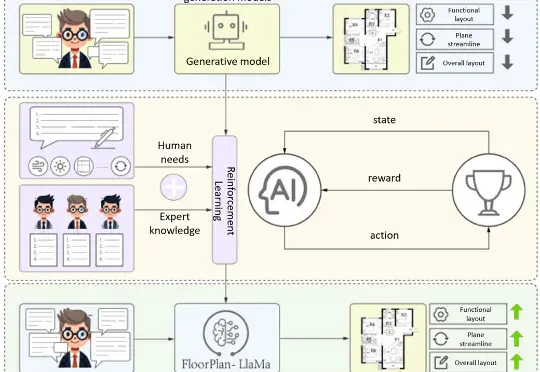
清华大学最新提出的建筑专业知识驱动的平面图自动生成方案FloorPlan-LLaMa,解决传统模型「指标优秀但实际不可用」 痛点,让AI生成贴合建筑师设计偏好的可行方案。
2026 年初,各大 AI 厂商在上下文窗口长度上展开激烈角逐。Google 的 Gemini 3 Pro 已支持 100 万级 token 上下文,Meta 的 Llama 4 Scout 更宣称可处理 1000 万 token。GPT-5 系列也在快速推进长上下文能力。