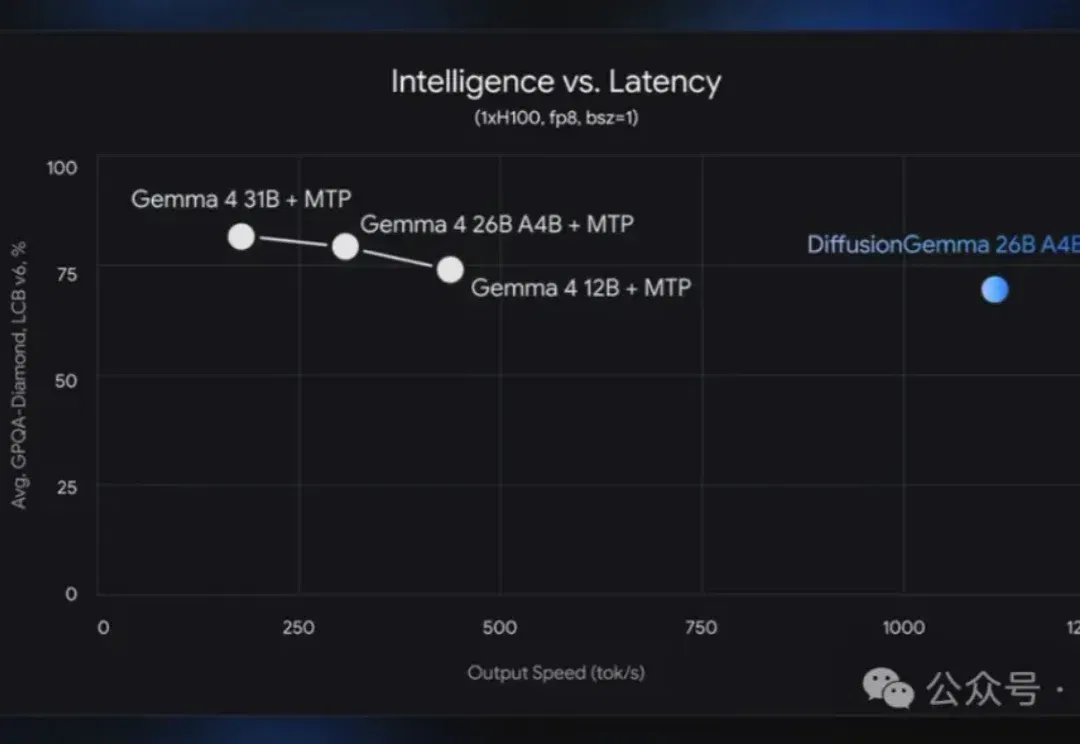
Mythos阴影里谷歌悄悄发模型DiffusionGemma,速度暴涨4倍 (opens in a new tab)
就在刚刚,谷歌闷头干了件大事:把生成图片的扩散模型,拿来写文字了,而且一出手就是4倍加速。 新模型名为DiffusionGemma,它直接抛弃了传统自回归那套“逐Token生成”的打字机模式,而是像“印刷机”一样工作——
Total 57 articles
就在刚刚,谷歌闷头干了件大事:把生成图片的扩散模型,拿来写文字了,而且一出手就是4倍加速。 新模型名为DiffusionGemma,它直接抛弃了传统自回归那套“逐Token生成”的打字机模式,而是像“印刷机”一样工作——
近期,专为Diffusion模型设计的插件框架——Diffusion Templates正式开源发布。这个框架能大幅降低可控生成技术的训练和使用难度,让开发者能够通过丰富的Templates来精准控制模型的生成结果。
现在生成一个视频,比你刷视频还要快。 因为一个开源新框架,竟能让视频生成在保证质量的情况下,最高提速200多倍! 而且还是单张显卡就能hold住的那种,来感受一下这个feel: 没错,原先1.3B-480P在单张RTX 5090生成一个5秒的视频,需要的时间大概是184秒。 而现在,只需要1.9秒,速度足足提升97倍! 这背后,便是清华大学TSAIL实验室和生数科技联合开源的视频生成加速新框架——TurboDiffusion。 新框架一出,网友们也是不淡定了,直呼: 我们已经进入到了生成的视频比看的视频还多的时代。 包括Meta研究员和伯克利教授也站台打call: 2秒就能生成一个视频 过去,
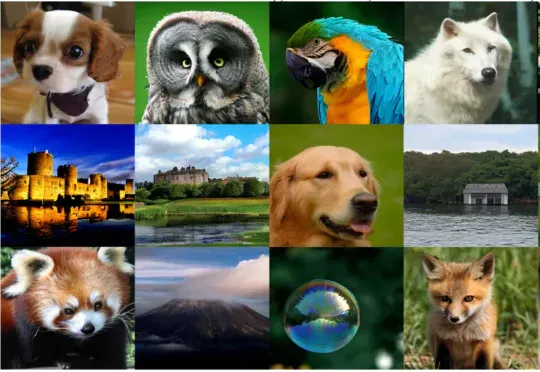
REG 是一种简单而有效的方法,仅通过引入一个 class token 便能大幅加速生成模型的训练收敛。其将基础视觉模型(如 DINOv2)的 class token 与 latent 在空间维度拼接后共同加噪训练,从而显著提升 Diffusion 的收敛速度与性能上限。在 ImageNet 256×256 上,
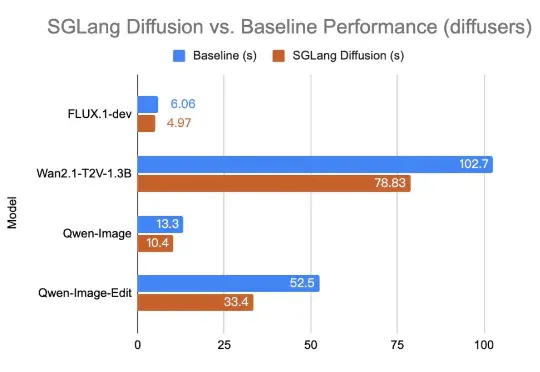
就在一周前,全宇宙最火爆的推理框架 SGLang 官宣支持了 Diffusion 模型,好评如潮。团队成员将原本在大语言模型推理中表现突出的高性能调度与内核优化,扩展到图像与视频扩散模型上,相较于先前的视频和图像生成框架,速度提升最高可达 57%:
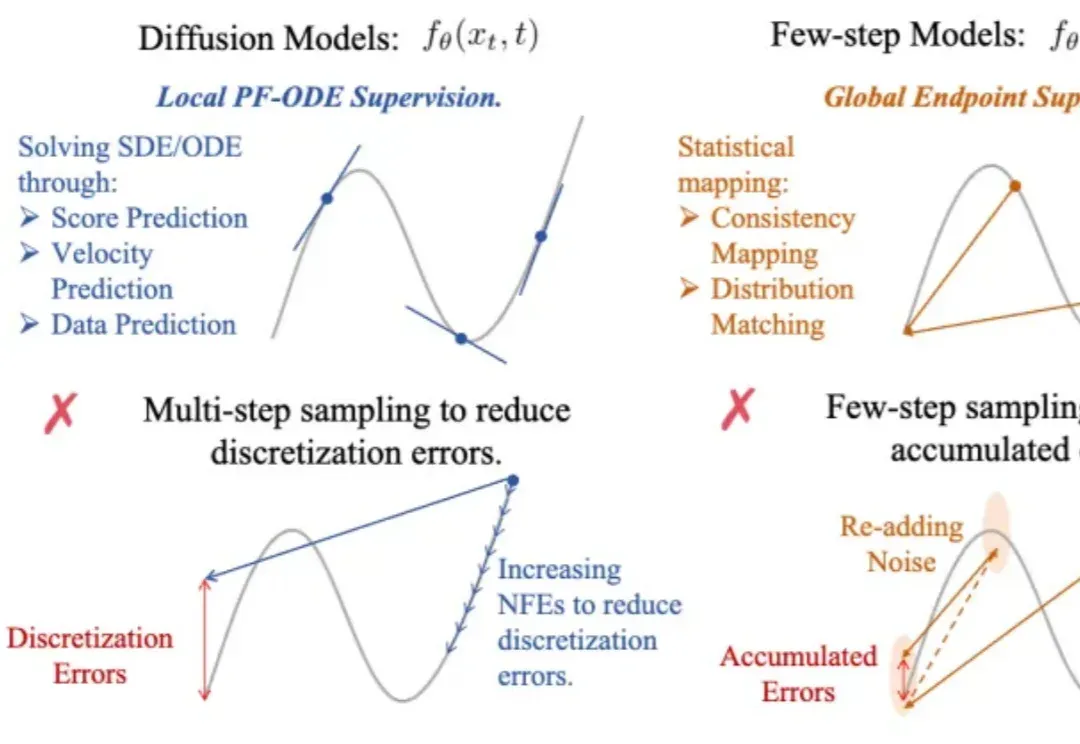
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两
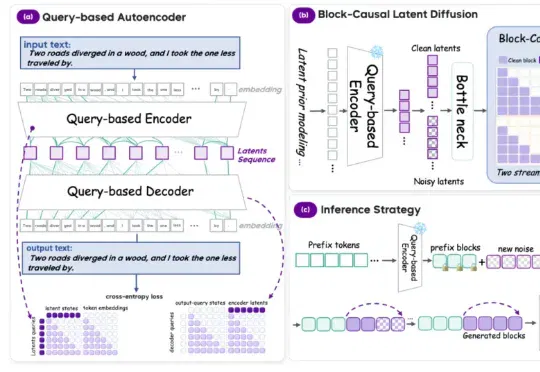
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
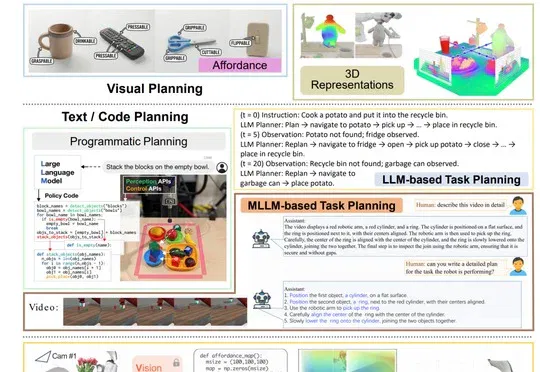
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
近日,上海人工智能实验室针对该难题提出全新范式 SDAR (Synergistic Diffusion-AutoRegression)。该方法通过「训练-推理解耦」的巧妙设计,无缝融合了 AR 模型的高性能与扩散模型的并行推理优势,能以极低成本将任意 AR 模型「改造」为并行解码模型。
最近,来自上海创智学院、复旦大学等机构的研究者提出了 Hallo-Live,试图正面解决这个矛盾。论文于 2026 年 4 月 26 日 发布在 arXiv。该方法将 异步双流扩散(Asynchronous Dual-Stream Diffusion) 与 人类偏好引导蒸馏(Human-Centric Preference-Guided DMD) 结合起来