回归C++: 在GGUF上构建高效的向量模型 (opens in a new tab)
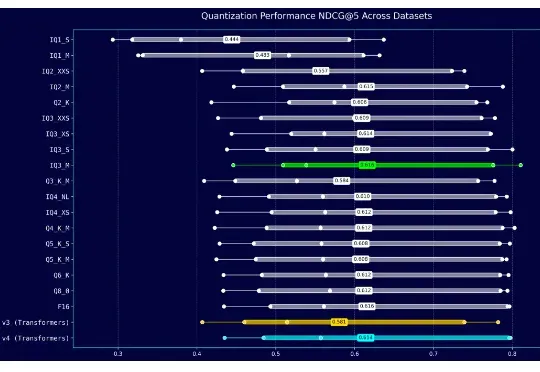
两周前,我们发布了 jina-embeddings-v4 的 GGUF 格式及其多种动态量化版本。jina-embeddings-v4 原模型有 37.5 亿参数,在我们的 GCP G2 GPU 实例上直接运行时效率不高。因此,我们希望通过更小、更快的 GGUF 格式来加速推理。
Total 26 articles
两周前,我们发布了 jina-embeddings-v4 的 GGUF 格式及其多种动态量化版本。jina-embeddings-v4 原模型有 37.5 亿参数,在我们的 GCP G2 GPU 实例上直接运行时效率不高。因此,我们希望通过更小、更快的 GGUF 格式来加速推理。
今天,Qwen 家族新成员+2,我们正式发布 Qwen3-VL-Embedding 和 Qwen3-VL-Reranker 模型系列,这两个模型基于 Qwen3-VL 构建,专为多模态信息检索与跨模态理解设计,为图文、视频等混合内容的理解与检索提供统一、高效的解决方案。
10月6日,谷歌开源EmbeddingGemma 2,把一个能搜图、看视频、听声音的搜索引擎,塞进了一个内存不到600MB的小模型!
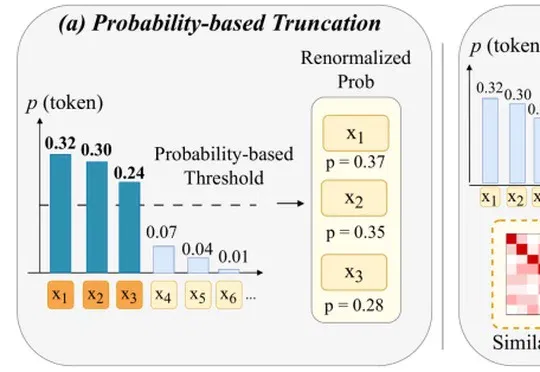
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
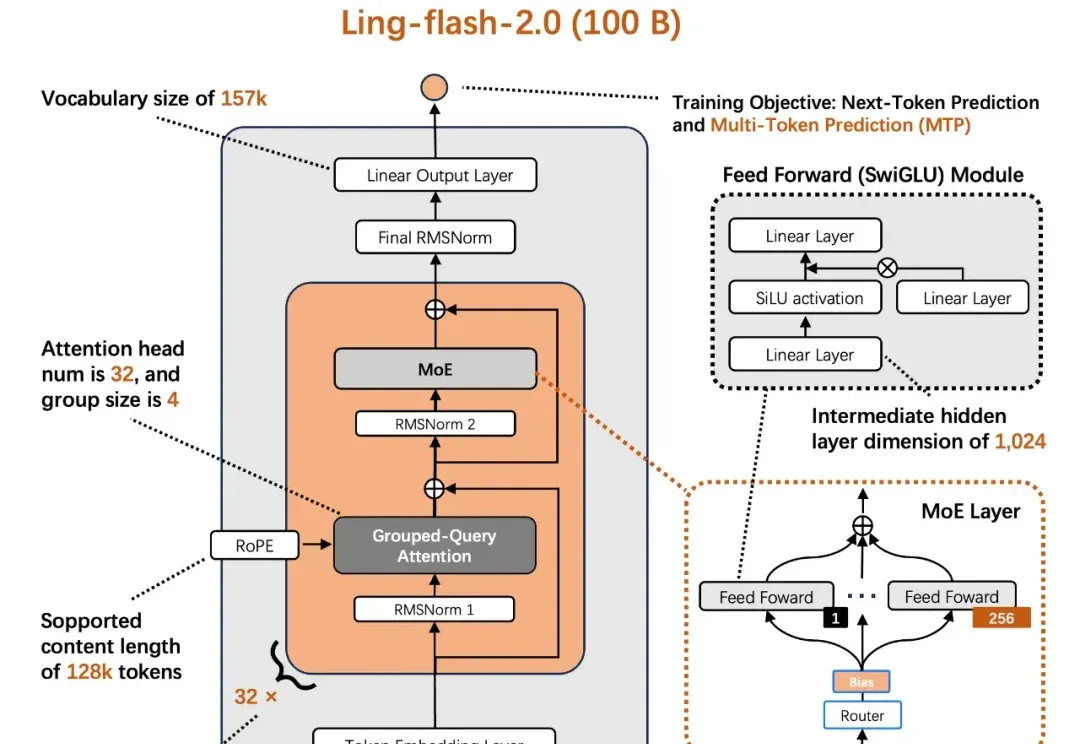
今天,蚂蚁百灵大模型团队正式开源其最新 MoE 大模型 ——Ling-flash-2.0。作为 Ling 2.0 架构系列的第三款模型,Ling-flash-2.0 以总参数 100B、激活仅 6.1B(non-embedding 激活 4.8B)的轻量级配置,在多个权威评测中展现出媲美甚至超越 40B 级别 Dense 模型和更大 MoE 模型的卓越性能。
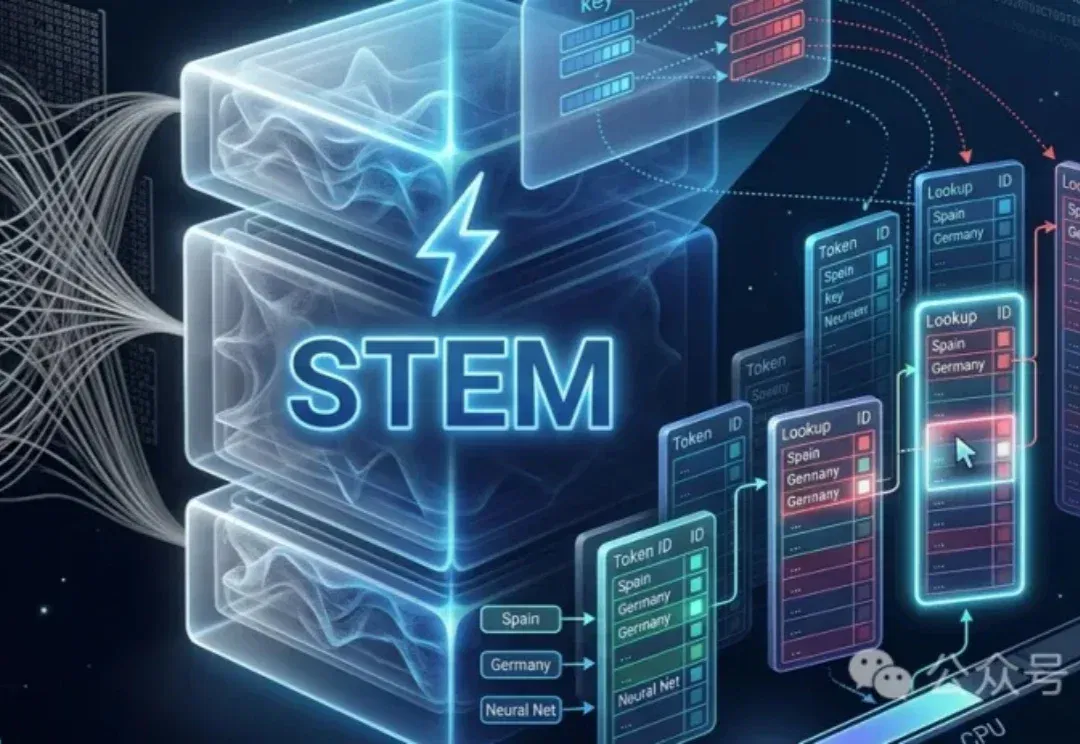
ICLR论文STEM架构率先提出「查表式记忆」架构,早于DeepSeek Engram三个月。它将Transformer的FFN从动态计算改为静态查表,用token索引的embedding表直接读取记忆,彻底解耦记忆容量与计算开销。
刚刚,谷歌发布了首个原生多模态(Multimodal)嵌入模型——Gemini Embedding 2。这次模型最大的变化在于:把文本、图像、视频、音频和文档,全部映射进同一个统一的嵌入空间。
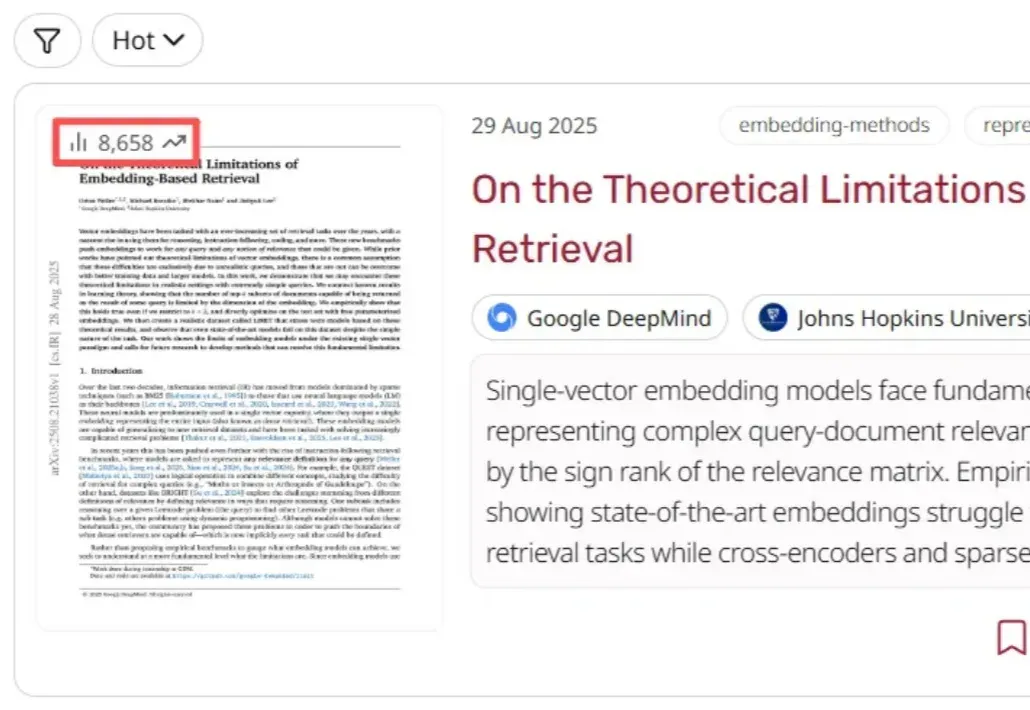
这几天,一篇关于向量嵌入(Vector Embeddings)局限性的论文在 AlphaXiv 上爆火,热度飙升到了近 9000。
一篇发表于 2015 年的论文《LINE: Large-scale Information Network Embedding》被授予 Seoul Test of Time Award(时间检验奖)。这篇由国际知名 AI4S 科学家、Mila 终身教授、百奥几何公司创始人唐建博士领衔
几周前,我们发布了 jina-embeddings-v4 模型的 GGUF 版本,大幅降低了显存占用,提升了运行效率。不过,受限于 llama.cpp 上游版本的运行时,当时的 GGUF 模型只能当作文本向量模型使用而无法支持多模态向量的输出。