DeepSeek-V4价格暴降90%!百万token仅2分钱,梁文峰送你token自由 (opens in a new tab)
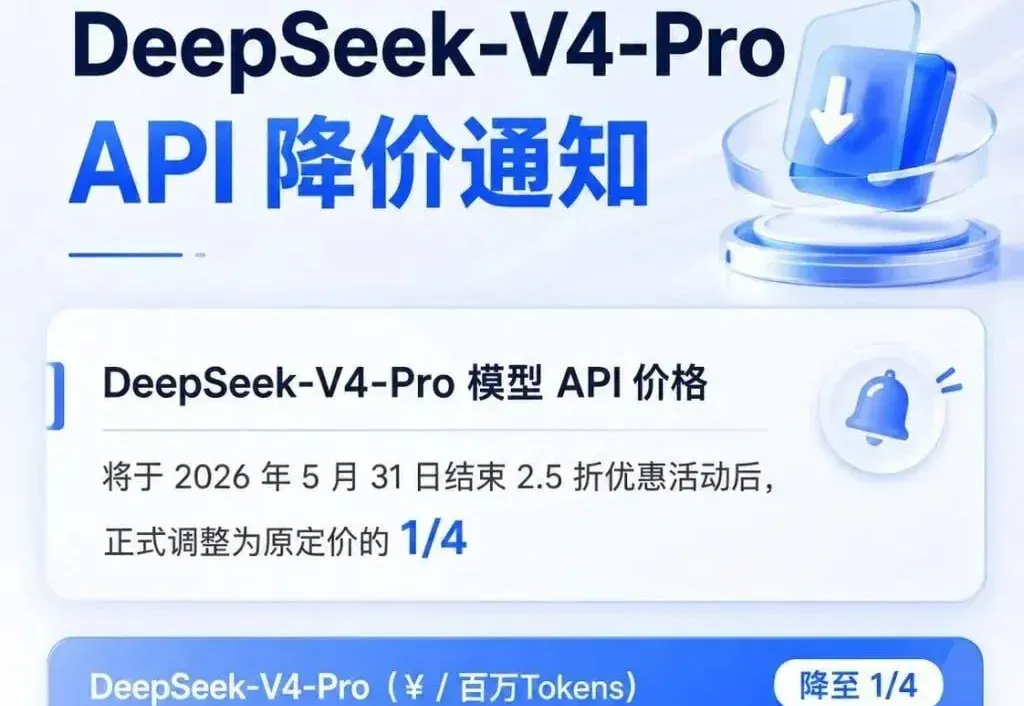
昨晚,DeepSeek-V4又降价了,全系两款模型输入缓存命中的价格直接降至首发价格1/10。最新调价后,DeepSeek-V4-Flash每百万tokens输入(缓存命中)价格为0.02元,DeepSeek-V4-Pro为0.025元。
Total 40 articles
昨晚,DeepSeek-V4又降价了,全系两款模型输入缓存命中的价格直接降至首发价格1/10。最新调价后,DeepSeek-V4-Flash每百万tokens输入(缓存命中)价格为0.02元,DeepSeek-V4-Pro为0.025元。
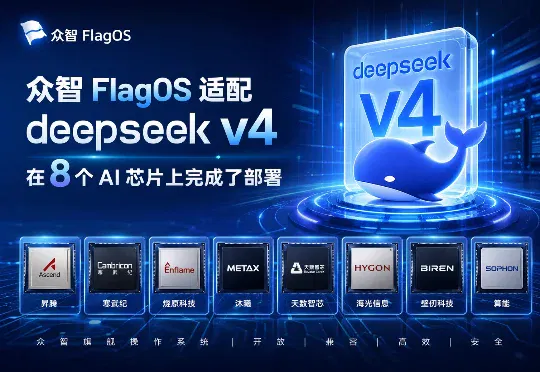
由智源研究院牵头研发的众智 FlagOS 第一时间对两个“巨无霸”模型进行全量适配,已经完成 DeepSeek-V4-Flash 在8款以上 AI 芯片上的全量适配与推理部署,包括海光、沐曦、华为昇腾、摩尔线程(FP8)、昆仑芯、平头哥真武、天数、英伟达(FP8)等芯片。FlagOS 同时正在推进 DeepSeek-V4-Pro 模型在多个芯片的迁移适配,晚些时间开源出来,敬请期待。

DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。
8月13日凌晨,DeepSeek V4 Pro正式登场,给开源模型生态又添一把猛火。从Kimi K3到MiniMax H3,再到DeepSeek V4 flash、DeepSeek V4 Pro,在中国开源模型的猛攻之下,美国的AI公司这次是真的坐不住了。
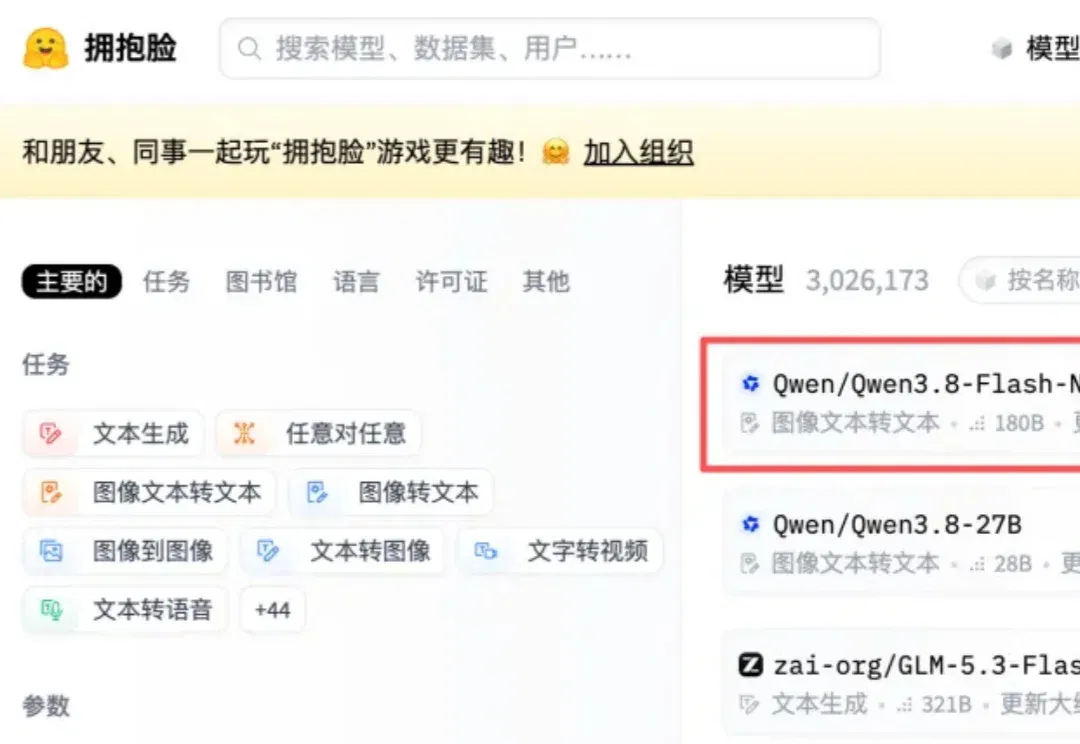
阿里千问新模型,又卷出了新水平。 他们发布并开源的Qwen 3.8 Flash-Next,不仅价格直接秒杀了DeepSeek-V4-Flash,而且刚发布便摘得了Huggingface榜首! 推上网友们也沸腾了,甚至还有工程师甩出实测视频直呼牛逼: Qwen 3.8 Flash踏平了VRAM的门槛,数据中心级的长文本大模型,在消费级4090显卡上也能跑了! 还有人已经兴冲冲地把它用到了工作中。 不到8分钟,它就跑完了涵盖Python编程、多表分析和研究报告生成的一整套工作流: 宝塔特效也不在话下: 哇奥,真有这么炫?我们当然也得上手试试。 每百万Tokens输入仅0.8元 Qwen3.8-Fl
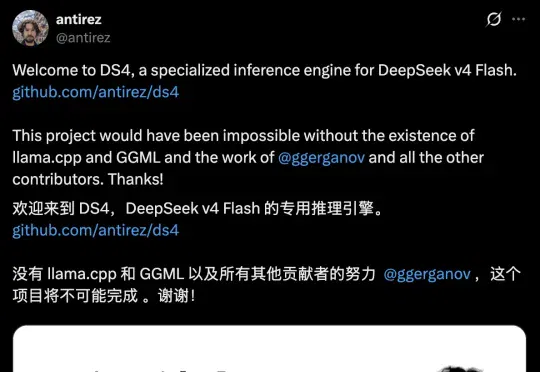
DeepSeek V4,已经开始逼着海外开发者为它修专属高速公路了。发布才两周,开源圈里,第一批V4原生基础设施已经冒了出来。它只干一件事:把DeepSeek V4 Flash,在Mac上跑到极致。这条“专属高速公路”,叫ds4.c。而把修出来的人,分量有点吓人——
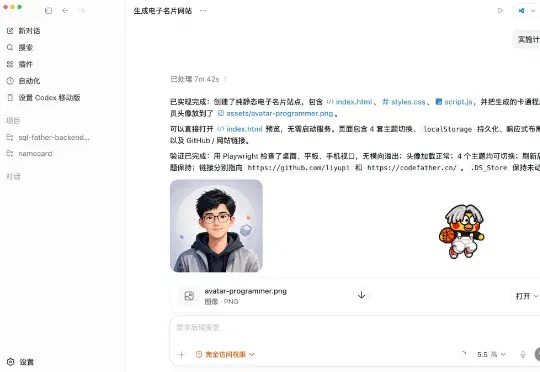
其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。
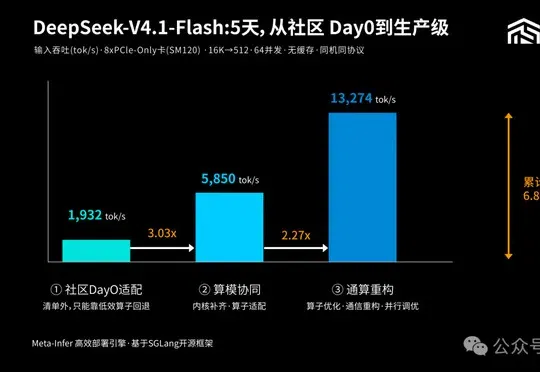
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
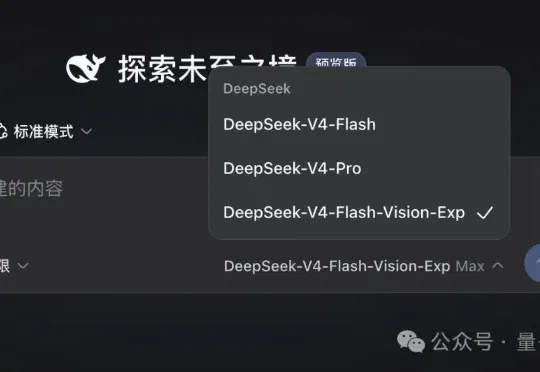
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
最近,DeepSeek又刷屏了! 根据 OpenRouter最新数据测算,5月18日至 5月24日,全球AI大模型总调用量达到 28.9 万亿Token,整体需求仍在快速释放。其中,中国AI大模型周调用量达 9.22万亿Token,环比增长19.89%;美国AI大模型周调用量为4.93万亿Token,环比增长16.27%。 值得注意的是,中国大模型调用量已连续 4 周超过美国。其中,DeepSeek V4-Flash登顶OpenRouter全球调用榜,其旗下模型周调用总量达到 5.74万亿Token,超过Anthropic与Google,连续两周位居全球第一。 流量不会说谎。每一笔背后,是开发