EMNLP 2026主会|北大×易鑫AI Lab:大模型明明「知道」,为什么还会答错? (opens in a new tab)
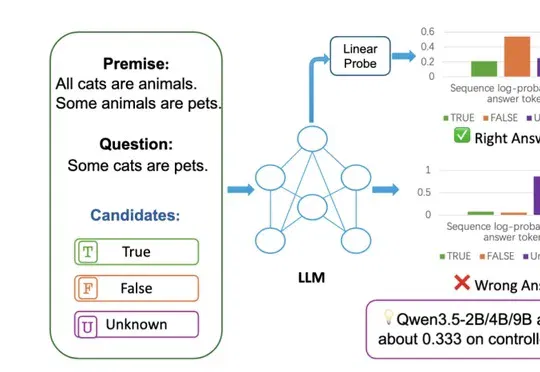
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
Total 56 articles
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
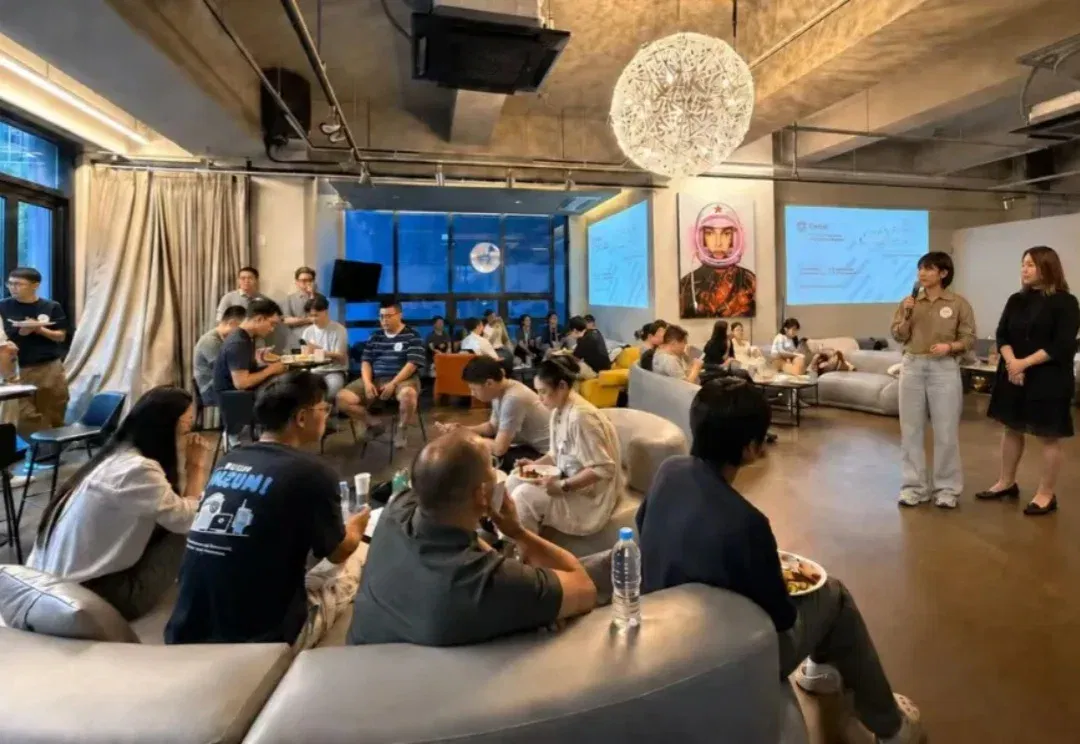
ICML 2026落幕了。 但今年最有意思的讨论,很多并没有发生在Session里。 Coffee Break的走廊上、Poster板前、晚餐桌边——来自全球Frontier AI Labs、顶尖高校、创业公司和投资机构的研究者们,聊的早已不只是论文本身: 下一代扩散语言模型还有多大空间?世界模型的机会到底在哪?当Agent开始参与研究流程,科研本身会变成什么样? 这些还没写进论文的思考,往往才是下一轮共识的起点。 就在本次ICML期间,九坤创投发起的Global AI Bridge组织了三场小规模闭门交流。 其中有ICML杰出论文奖得主,有Frontier Lab研究员,有华为天才少年,也有
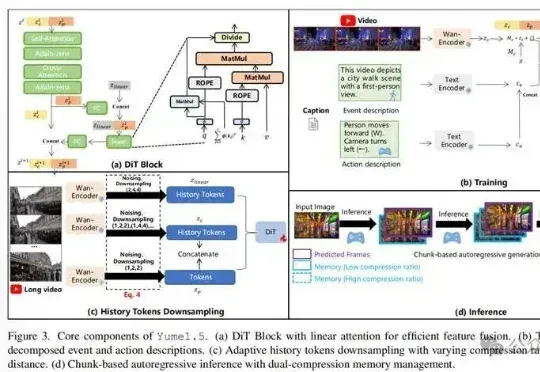
上海AI Lab联合多家机构开源的Yume1.5,针对这一核心难题提出了时空信道联合建模(TSCM),在长视频生成中实现了近似恒定计算成本的全局记忆访问。
组织调整后的模型答卷,将对腾讯至关重要。《智能涌现》从多名独立信源处获悉,近日,出于个人发展原因,原腾讯 AI Lab副主任俞栋将从腾讯离职。截至发稿前,腾讯官方暂未回复。
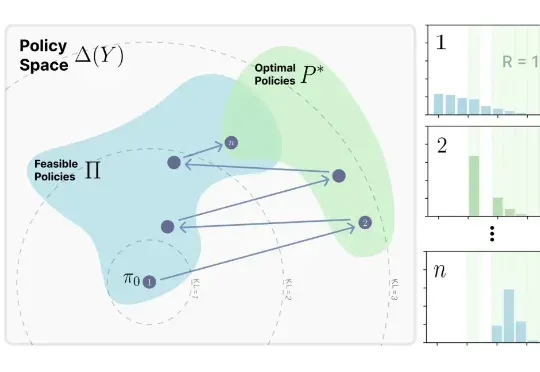
来自MIT Improbable AI Lab的研究者们最近发表了一篇题为《RL's Razor: Why Online Reinforcement Learning Forgets Less》的论文,系统性地回答了这个问题,他们不仅通过大量实验证实了这一现象,更进一步提出了一个简洁而深刻的解释,并将其命名为 “RL's Razor”(RL的剃刀)。
在这场日益蔓延的“Token焦虑”中,Agnes AI的举动显得格外扎眼——这家全球榜单排名第九的AI Lab宣布,自6月1日起,旗下全模态模型API无限期免费开放。Agnes AI本次开放覆盖其三款核心模型:文本模型Agnes-2.0-Flash、图像模型Agnes-Image-2.0-Flash以及视频模型Agnes-Video-V2.0。
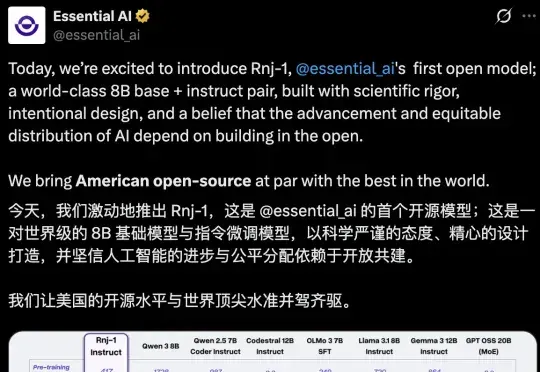
AI不应是巨头游戏,模型也不是越大越聪明。近日,「Transformer八子」中的Ashish Vaswani和Parmar共同推出了一个8B的开源小模型,剑指Scaling Law软肋,为轻量化、开放式AI探索了新方向。
由Liu Fayao(刘发耀,新加坡A*STAR研究科学家),Ye Deheng(叶德珩,前腾讯AI合伙人&首席专家)和Chen Tianrun(陈天润,魔芯科技创始人)带领的研究团队提出了Claw AI Lab。
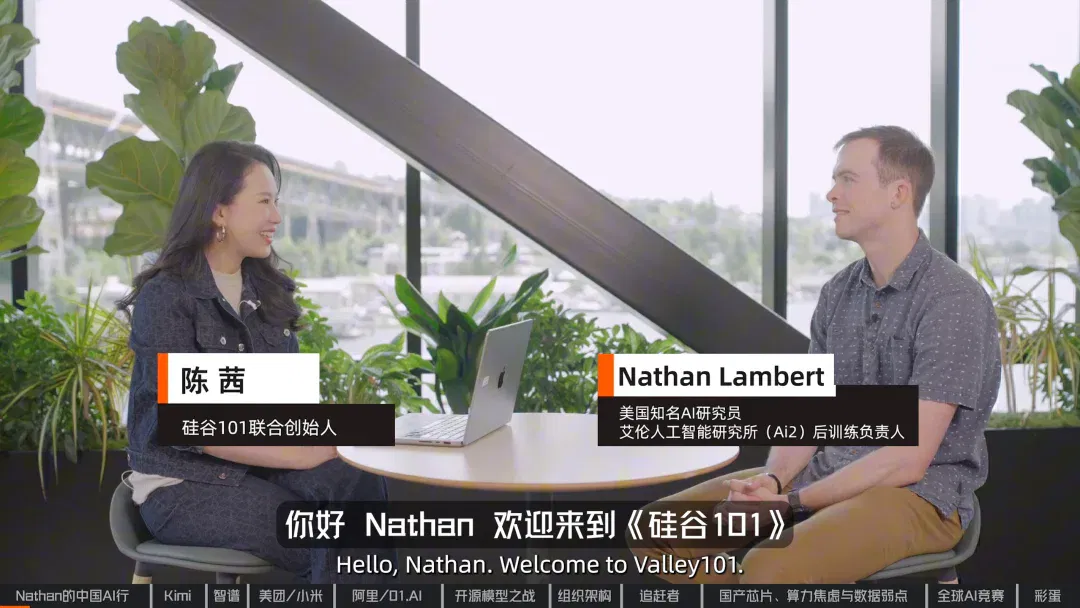
2026年4月,一位在美国AI圈极具影响力的研究者,专程来到中国,走进北京、杭州和上海的AI实验室。他密集拜访了阿里巴巴、月之暗面、智谱、清华、美团、小米、蚂蚁和零一万物等团队。回到美国后,他写了一篇名为《Notes from inside China's AI labs》(中国AI实验室内部观察随笔)的文章,在美国科技圈引发了不小讨论。
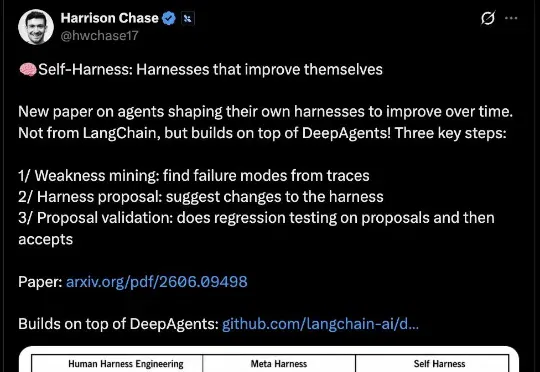
上海人工智能实验室团队提出的Self-Harness,近期被LangChain CEO、联合创始人Harrison Chase转发,也被前OpenAI副总裁Lilian Weng收进自进化Agent相关博客。它盯上的不是换模型,而是Agent外层那套Harness。