谷歌再发「香蕉」!何恺明等引爆视觉Transformer时刻 (opens in a new tab)
最近,谷歌联合ResNet作者何恺明、谢赛宁、NeRF先驱Jonathan T. Barron、 3D图形学名家Thomas Funkhouser,正式发布了Vision Banana。它向世界宣告:视觉AI终于不再需要那些臃肿的任务头了,理解,本质上只是生成过程中的一次「对齐」。
Total 27 articles
最近,谷歌联合ResNet作者何恺明、谢赛宁、NeRF先驱Jonathan T. Barron、 3D图形学名家Thomas Funkhouser,正式发布了Vision Banana。它向世界宣告:视觉AI终于不再需要那些臃肿的任务头了,理解,本质上只是生成过程中的一次「对齐」。
在当前的 LLM 开发中,后训练阶段通常被视为赋予模型特定能力的关键环节。传统的观点认为,模型必须通过强化学习(如 PPO、GRPO 或 RLHF)和进化策略(ES)等算法,在反复的迭代和梯度优化过程中调整权重,才能在特定任务上达到理想的性能。
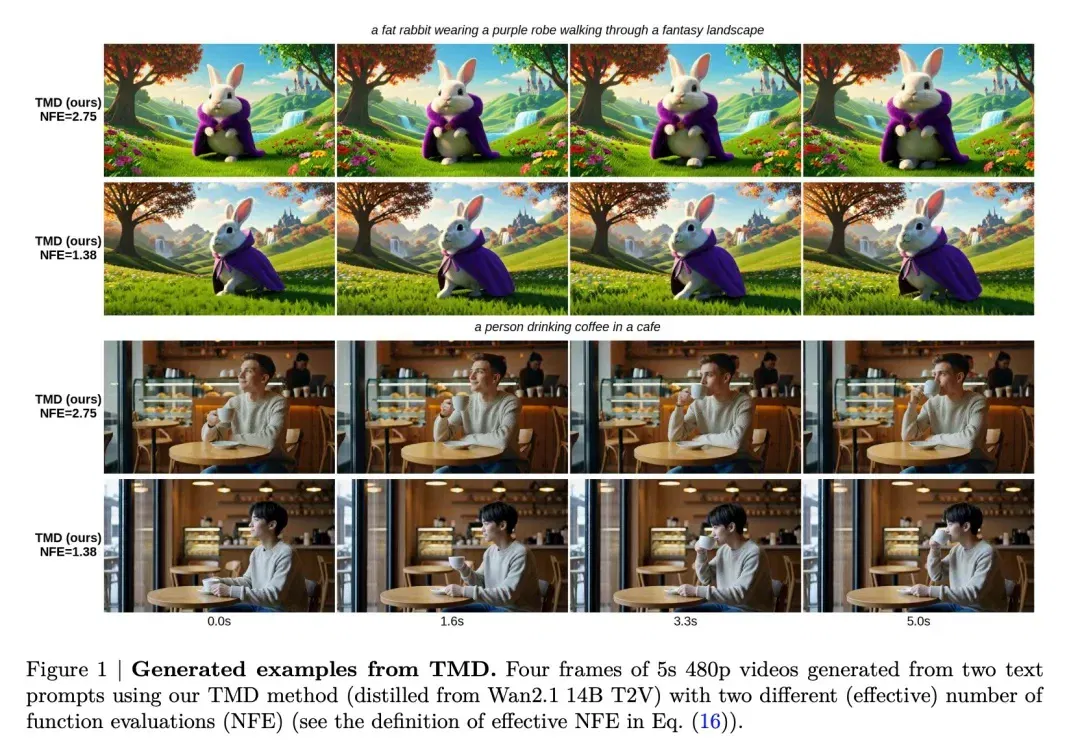
近年来,大规模视频扩散模型在视频生成领域取得了显著进展。然而,采样效率低下仍然是这类模型的核心瓶颈。
3 月 10 日,APPSO 中文独家获悉,世界模型研究所/创业公司 AMI 已完成 10.3 亿美元融资,投前估值 35 亿美元。该公司由图灵奖得主、前 Meta 首席 AI 科学家杨立昆 (Yann LeCun) 创办。
基础模型时代,大模型能力的爆发,很大程度上源于在海量文本上的预训练。然而问题在于,文本本质上只是人类对现实世界的一种抽象表达,是对真实世界信息的有损压缩。
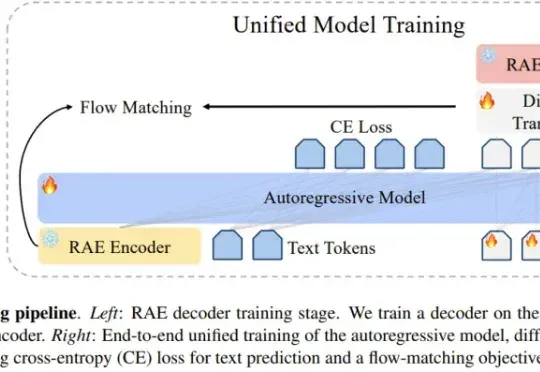
编辑|Panda 在文生图模型的技术版图中,VAE 几乎已经成为共识。从 Stable Diffusion 到 FLUX,再到一系列扩散 Transformer,主流路线高度一致:先用 VAE 压缩视
新公司名为Advanced Machine Intelligence(AMI),也就是先进机器智能,法语里意为“朋友”。总部位于巴黎,并将在纽约、蒙特利尔、新加坡等地分别设立运营机构。而且和硅谷最近的闭源趋势不同,AMI all in开源。
终于有人要给大模型安“脖子”了! 在最新的论文Thinking in 360°: Humanoid Visual Search in the Wild中,来自纽约大学的研究团队让大模型能够环顾四周,进行360度的全方位思考。 他们通过定义一套全新的数据集和基础测试H*,让模型可以在火车站、购物中心等真实环境中,进行像人类一样的视觉搜索。 谢赛宁(也参与了这篇论文)在转发中,直接表示:这不就是给模型安了个脖子吗? 这是怎么回事? 类人视觉搜索 整体而言,研究团队首先提出了一项在360度空间中实现人类主动空间推理的新任务—— 类人视觉搜索(Humanoid Visual Search),这项任务能
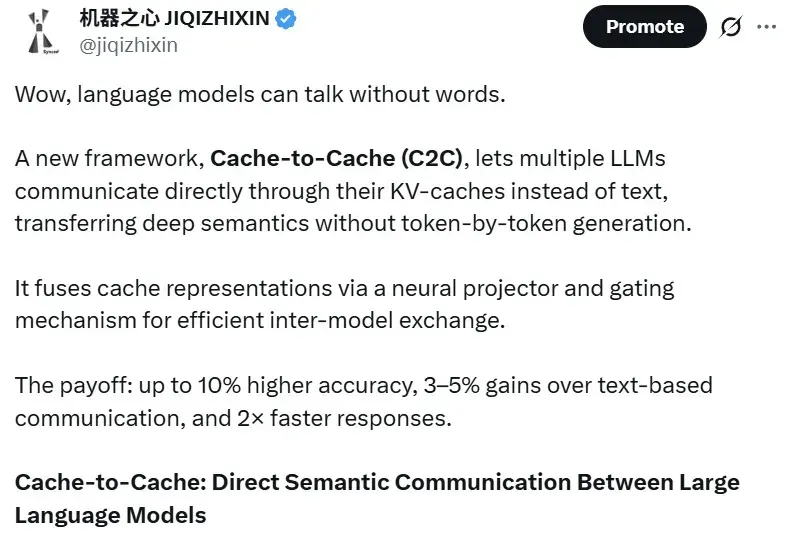
前些天,一项「AI 传心术」的研究在技术圈炸开了锅:机器不用说话,直接抛过去一堆 Cache 就能交流。让人们直观感受到了「去语言化」的高效,也让机器之心那条相关推文狂揽 85 万浏览量。参阅报道《用「传心术」替代「对话」,清华大学联合无问芯穹、港中文等机构提出 Cache-to-Cache 模型通信新范式》。
单Transformer搞定任意视图3D重建!