美团开源“语音克隆”模型,1B/3.5B双选,超自然复刻你的声音 (opens in a new tab)
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
Total 22 articles
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
阶跃星辰今日发布新一代自动语音识别模型StepAudio 2.5 ASR。该模型面向语音转写与长音频处理场景,在架构上引入Multi-Token Prediction(多Token预测)以提升推理效率,并通过扩展上下文窗口强化长内容识别能力。
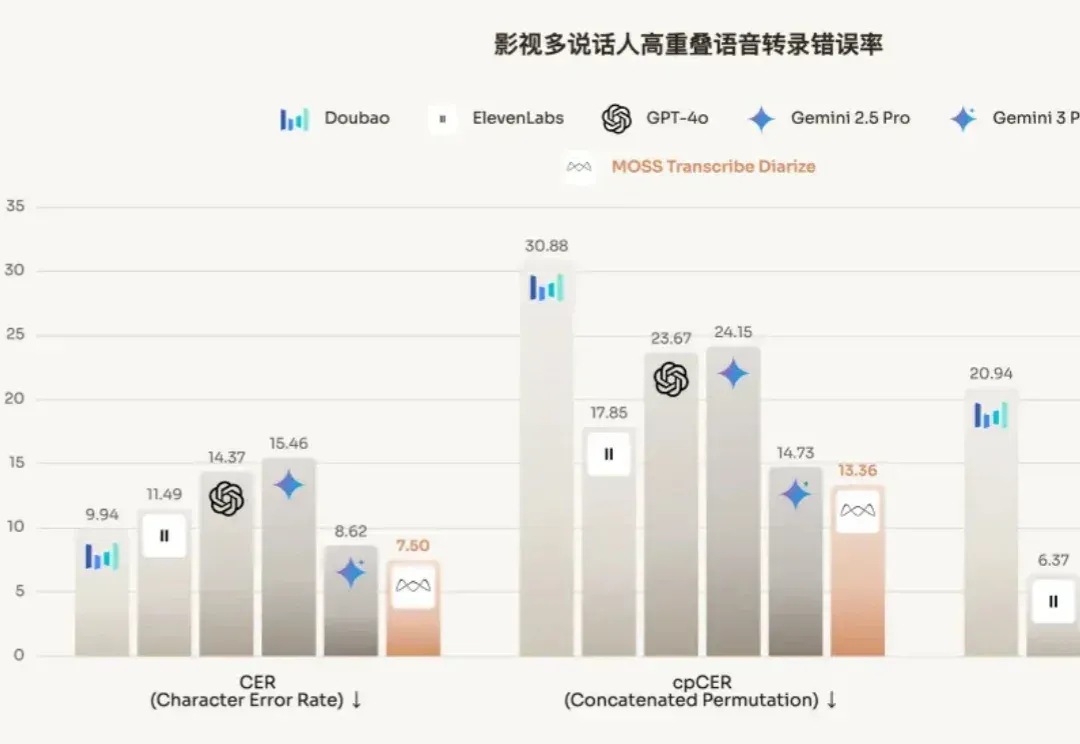
近日,由复旦邱锡鹏担任首席科学家的模思智能发布了多说话人自动语音识别(ASR)模型 MOSS-Transcribe-Diarize,不但可以语音转文字,还可以将音频片段与对话中不同的说话者关联起来,性能超过了 GPT-4o、Gemini、豆包等一众模型。
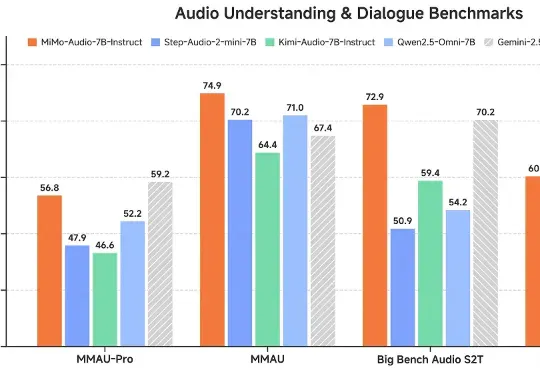
这一瓶颈如今被打破。小米正式开源首个原生端到端语音模型——Xiaomi-MiMo-Audio,它基于创新预训练架构和上亿小时训练数据,首次在语音领域实现基于 ICL 的少样本泛化,并在预训练观察到明显的“涌现”行为。
微软紧跟OpenAI的节奏,在同一天也亲自下场发布了微软自研的两个大模型:语音模型MAI-Voice-1和通用模型MAI-1-preview。对于这位老大哥,亲自下场做的第一个AI大模型,效果究竟怎么样?
APPSO 从 Block 旗下 Dessa 的纯语音研究谈起,比较实时语音模型的交互方式与车载、客服等应用,再讨论声音在并列信息审阅、隐私和办公场景中的边界:更自然的对话仍无法替代所有屏幕操作。
TechCrunch 报道,之前一直以 AI 语音初创公司示人的 Sesame,完成了 2.5 亿美元的 B 轮融资,投资方包括红杉资本、Spark Capital 及其他未公开的投资者。随后,Sesame 创始人 Brendan Iribe 也在个人社媒账号上发帖,证实该消息。
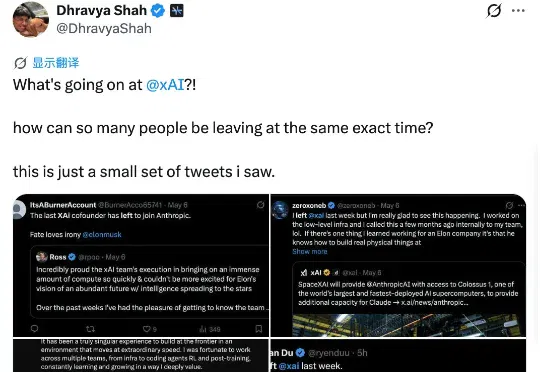
刚刚,xAI再失一名华人大将。就在今天,预训练负责人庄钧堂官宣了自己的离职消息。此前,庄钧堂已经在xAI工作了两年。这期间,他主导了从Grok 2到Grok 5的全系列预训练,同时负责Grok在X和Tesla上的语音模型及xAI企业API模型。
面壁智能2B小模型VoxCPM 2惊艳开源,一众外国网友疯狂了!30种语言与9大方言它是信手拈来,复刻的贺炜激昂解说与徐志胜脱口秀,相似度简直直击灵魂。这哪是工具,分明是降维打击的生产力核武器!
数字人这赛道也越来越卷了, 大模型可以写剧本,语音模型可以配出百变语气,当我越来越不满足于只是把口型对上这件事之后, 那这个只会坐着、不能走路、表情都是提前预设好的、台词数字人,会如何进化?