别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算 (opens in a new tab)
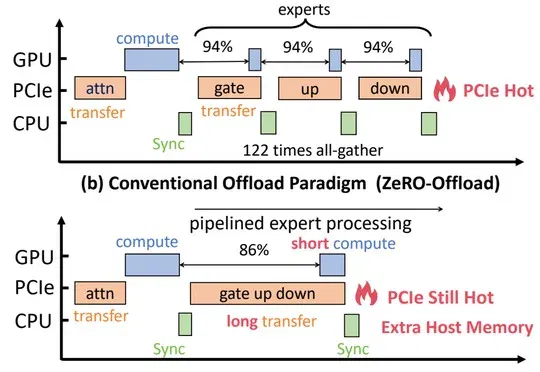
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
Total 99 articles
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
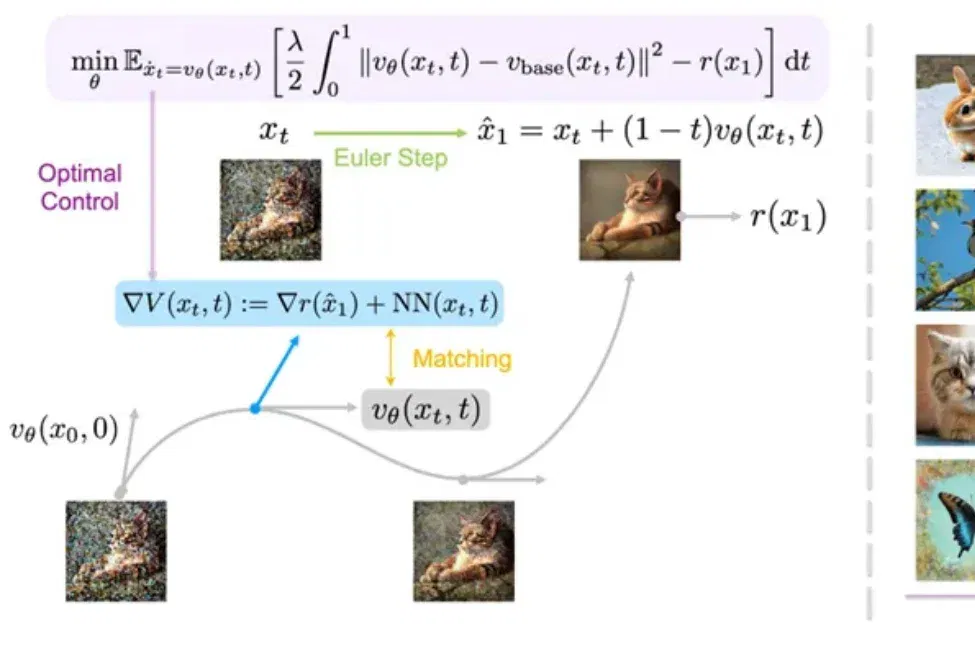
用强化学习微调扩散模型,还有更好的办法吗?
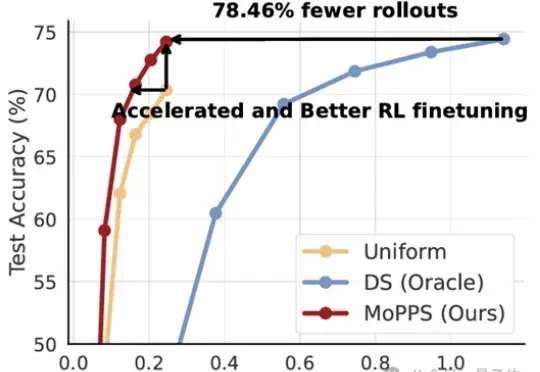
以DeepSeek R1为代表的一系列基于强化学习(RLVR)微调的工作,显著提升了大语言模型的推理能力。但在这股浪潮背后,强化微调的代价却高得惊人。
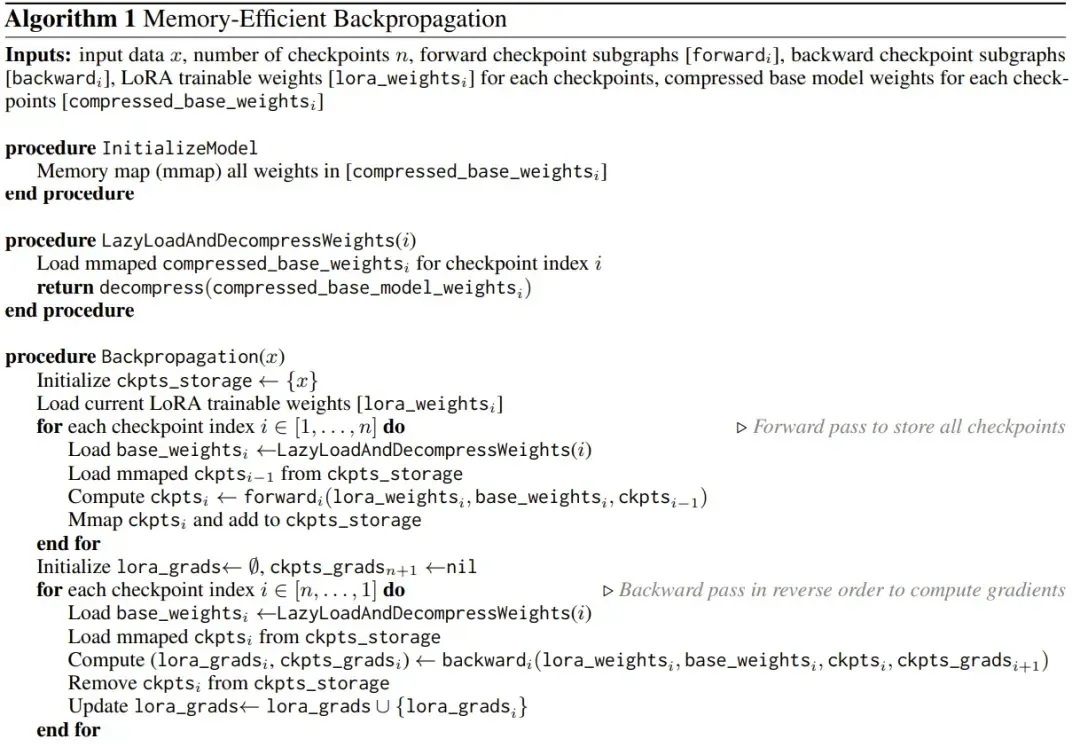
用 iPhone 本地跑大模型已经不是新鲜事了,但能不能在 iPhone 上微调模型呢?
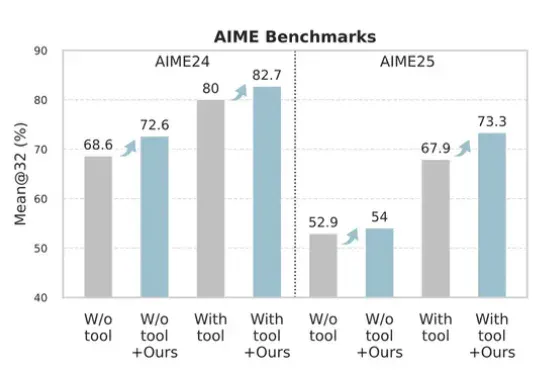
只花120元,效果吊打70000元微调!腾讯提出一种升级大模型智能体的新方法——无训练组相对策略优化Training-Free GRPO。无需调整任何参数,只要在提示词中学习简短经验,即可实现高性价比提升模型性能。
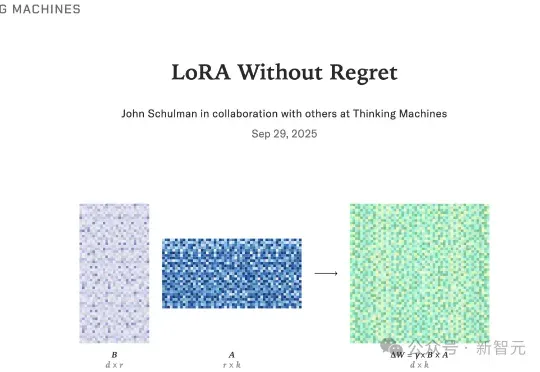
LoRA能否与全参微调性能相当?在Thinking Machines的最新论文中,他们研究了LoRA与FullFT达到相近表现的条件。Thinking Machines关注LoRA,旨在推动其更广泛地应用于各种按需定制的场景,同时也有助于我们更深入审视机器学习中的一些基本问题。
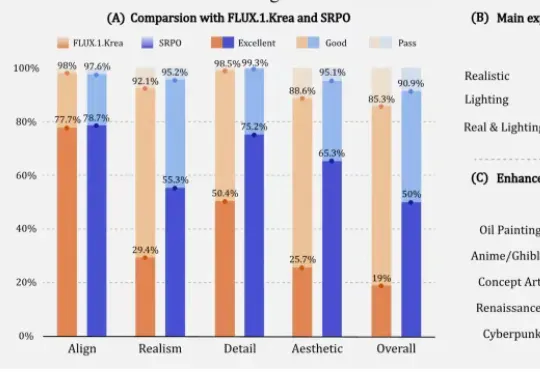
让AI生成的图像更符合人类精细偏好,在32块H20上训练10分钟就能收敛。腾讯混元新方法让微调的FLUX1.dev模型人工评估的真实感和美学评分提高3倍以上。
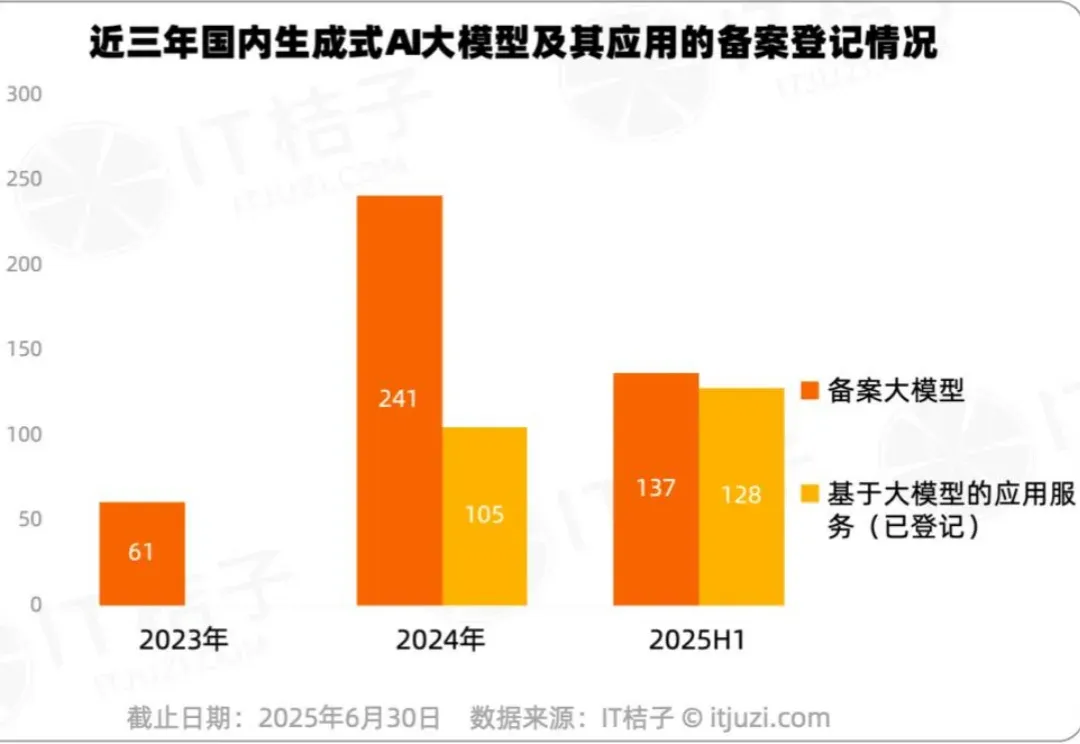
这些地区正在悄悄崛起 得益于AI技术的成熟和开源大模型的发展,中国生成式AI应用及服务正迎来爆发式增长。 根据国家网信办公示的生成式AI服务备案信息: 截至2025年6月,共439款生成式人工智能服务在国家网信办完成备案; 通过API接口或其他方式直接调用已备案模型能力的AIGC应用或产品完成登记的有233个(大部分产品表现形态为Agent)。 简单来说,如果是自研或者有显著微调、要做数据训练的大模型,需要备案。如果是基于已备案的大模型、无微调也无数据训练而开发的AIGC应用产品,无需备案,只需登记。 IT桔子对这些备案和登记的中国生成式AI模型及其应用的数据做进一步地处理,包括详细记录类型(
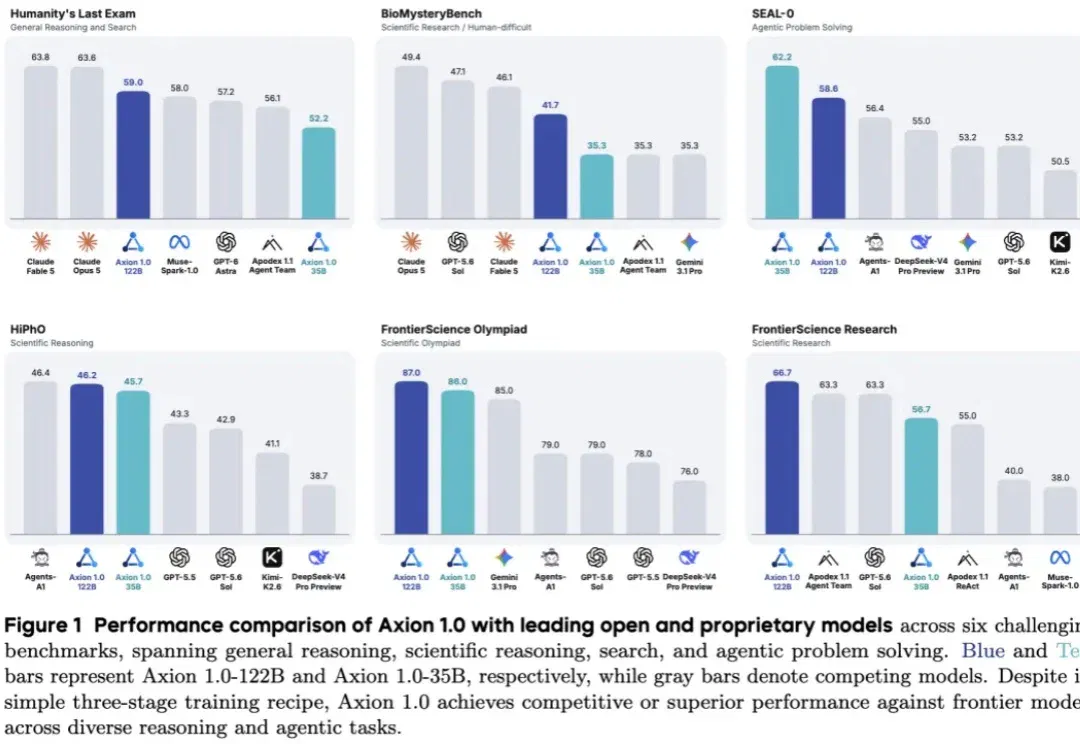
Researchers from Duke, ByteDance and other institutions present Axion 1.0, using supervised fine-tuning for reasoning and information acquisition followed by reinforcement learning. The paper reports mathematics, science and information-search results and releases training materials.
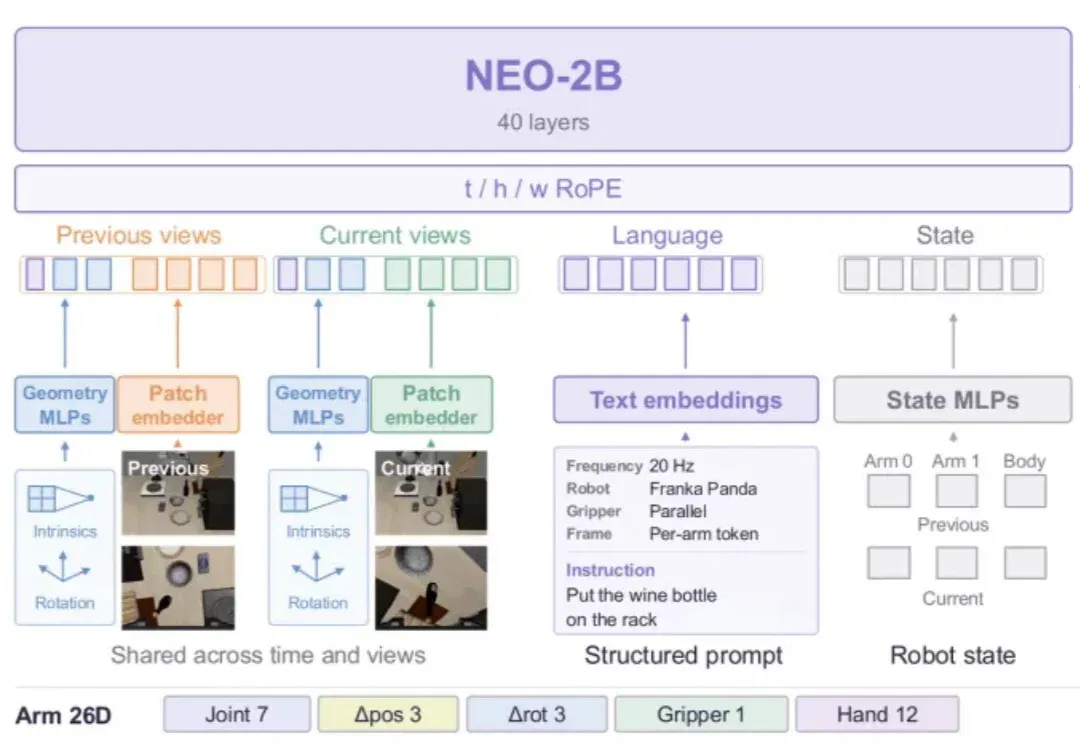
NEO-VLA lets an action expert read multiple backbone layers, comparing frozen models, fine-tuning and joint understanding training. Simulation and three physical tasks evaluate transfer, robustness and remaining spatial/task-generalization limits.