斯坦福英伟达推出测试时强化学习:微调开源模型胜过顶级闭源模型,仅需几百美元 (opens in a new tab)
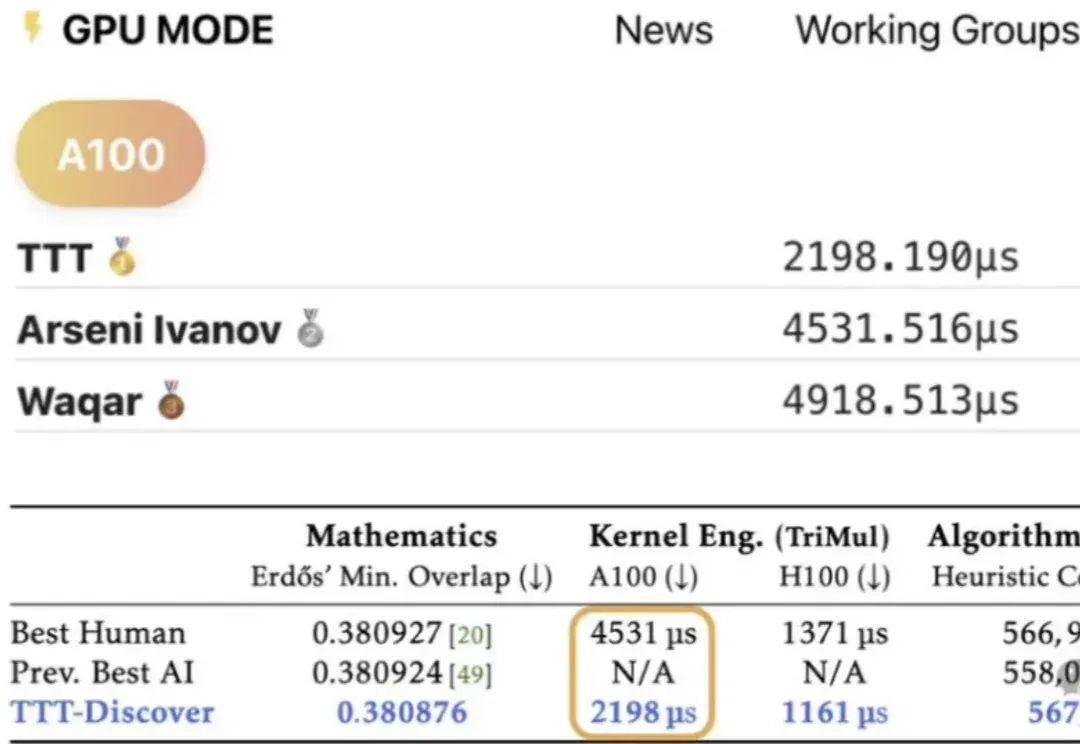
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő