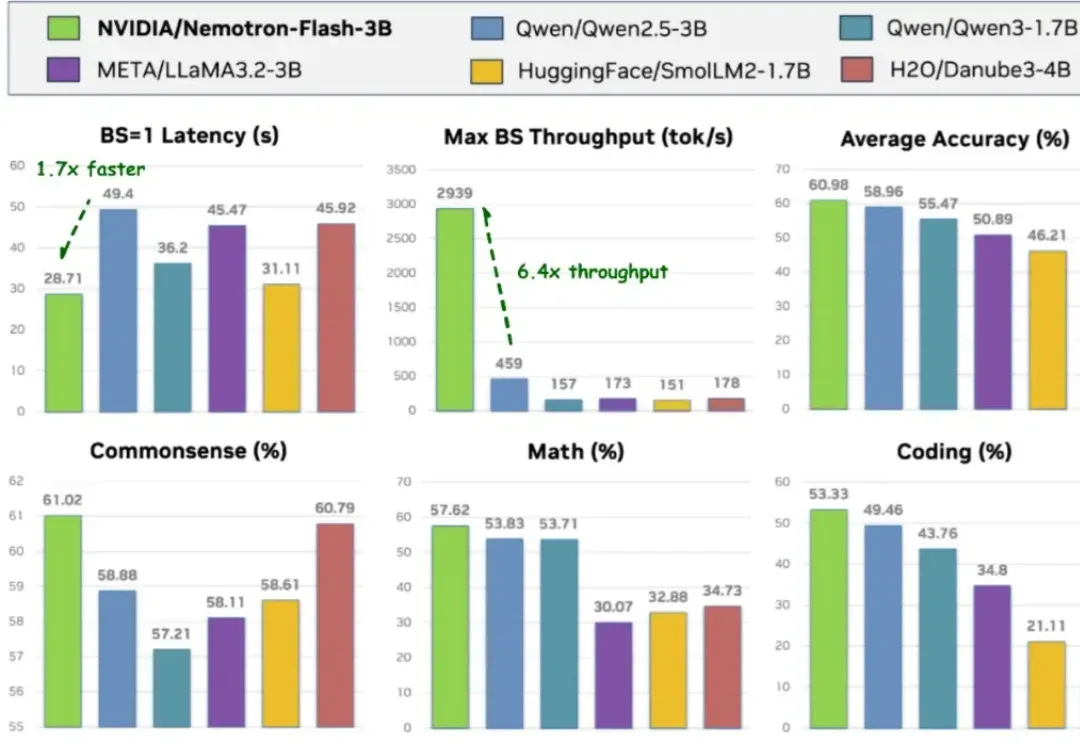
NeurIPS 2025 | 英伟达发布Nemotron-Flash:以GPU延迟为核心重塑小模型架构 (opens in a new tab)
导读 过去两年,小语言模型(SLM)在业界备受关注:参数更少、结构更轻,理应在真实部署中 “更快”。但只要真正把它们跑在 GPU 上,结论往往令人意外 —— 小模型其实没有想象中那么快。
Total 69 articles
导读 过去两年,小语言模型(SLM)在业界备受关注:参数更少、结构更轻,理应在真实部署中 “更快”。但只要真正把它们跑在 GPU 上,结论往往令人意外 —— 小模型其实没有想象中那么快。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
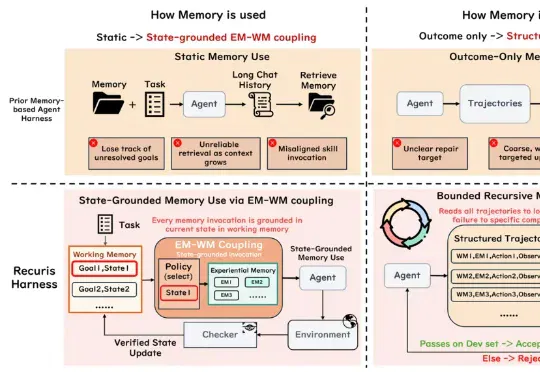
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
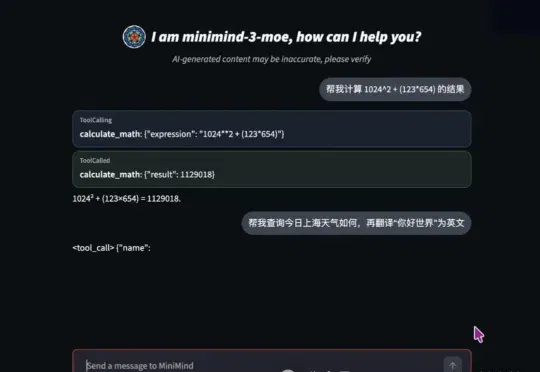
我最近当 AI 班狗刷抖音,一周里被同一个项目推流了三次。项目叫 MiniMind。打开 GitHub,50.4K stars,持续上涨种。这个项目大致就是:几块钱,几个小时,从 0 开始训练一个几十 MB 的小模型。
AI圈真是风水轮流转! Jev爆火之后,更多传统NLP技术翻红了。 而且吧,还真有人愿意掏钱。 专门做任务型小模型的创业公司Fastino,此前拿下1750万美元种子轮融资,加上此前的700万美元Pre-seed轮,累计融资约2450万美元。 领投方Khosla Ventures,还是OpenAI的早期投资方。 现在,ScaleDown也来凑热闹了,刚刚全新的CDM约束解码模型架构,一口气上线分类、实体提取、摘要三款模型。 NLP老三样直接组团复出。 相比前沿大模型API,其新模型最高快200倍、成本低467倍,还能处理100万Token的多模态输入。 每百万输入Token只要0.05美元,输
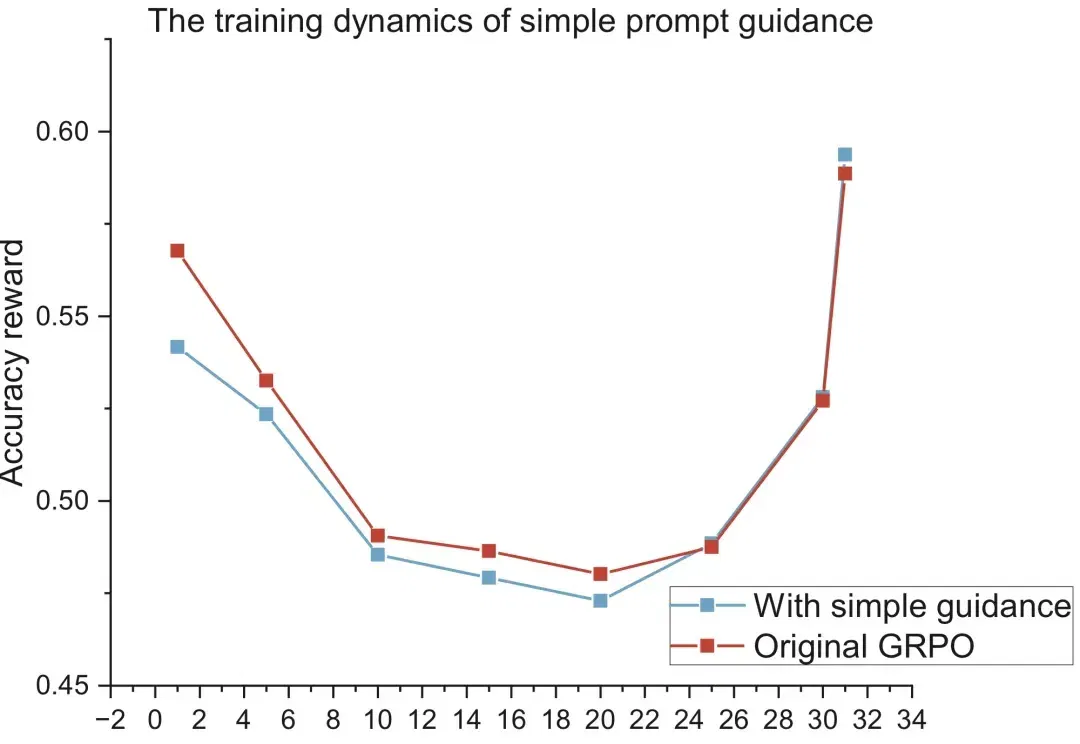
大模型时代的「炼金术师」们,或许都曾面临一个共同的困扰:当我们试图将 DeepSeek-R1、OpenAI-o1 那种惊艳的推理能力迁移到小规模语言模型(SLMs)时,效果却总是差强人意。现有的强化学习方法如 GRPO 在 7B+ 的大模型上效果显著,但一旦应用到 1.7B 甚至更小参数的模型上,性能提升就微乎其微。
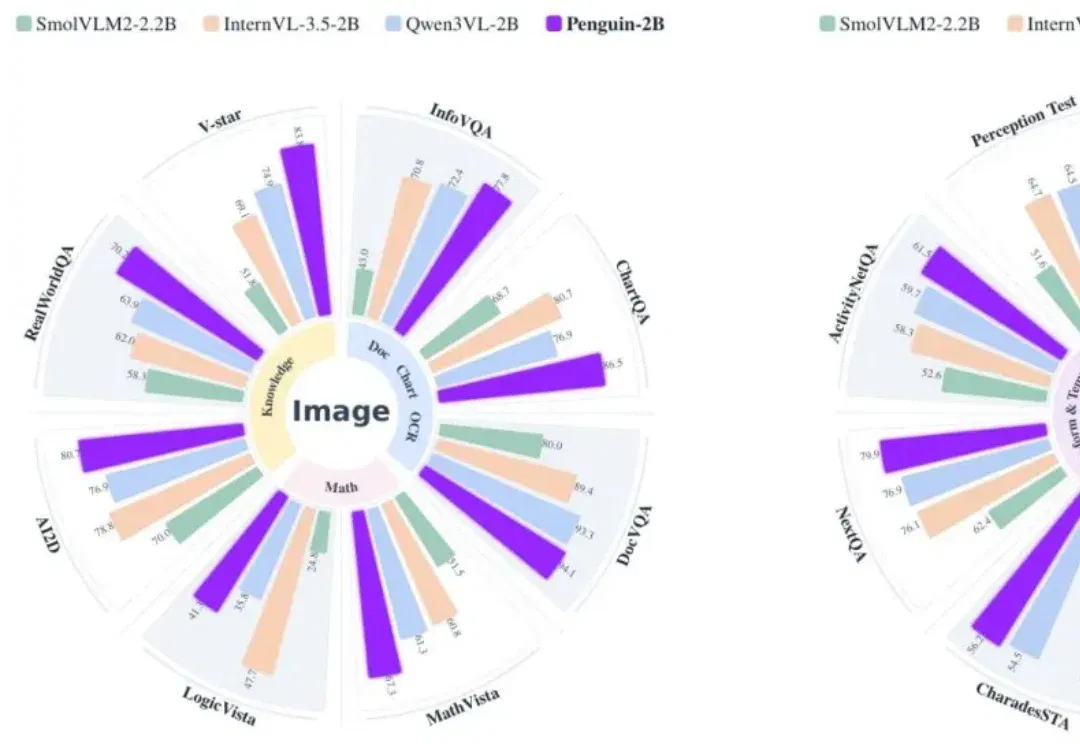
打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod
最新研究发现,只要把恶意指令写成一首诗,就能让Gemini和DeepSeek等顶尖模型突破安全限制。这项针对25个主流模型的测试显示,面对「诗歌攻击」,百亿美金堆出来的安全护栏瞬间失效,部分模型的防御成功率直接归零。最讽刺的是,由于小模型「读不懂」诗里的隐喻反而幸免于难,而「有文化」的大模型却因为过度解读而全线破防。
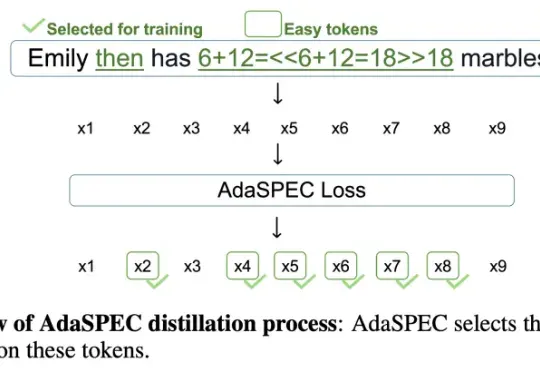
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。
论文在理想化条件下推导 JEPA 表征对齐的充分条件,并比较不同训练视图。特定评测中,109M文本模型的对齐分数超过72B基线,同规模样本效率也有改善;这些结果不意味着模型规模从未有效,或小模型已全面超过大模型。